 AI Tracker
AI 뉴스,
개발자를 위해 정리했습니다.
모든 AI 제공업체의 출시, 가격 변경, 지원 종료를 요약했습니다. 앱의 뉴스 탭과 같은 피드입니다.
OpenAI의 API 가격 페이지에서 o1, o1-pro, GPT-4를 포함한 구형 모델 10종이 사라졌습니다
2026년 11월 2일, OpenAI의 API 가격 페이지에서 구형 모델 10종이 사라졌습니다. 이는 가격 페이지 자체의 변경이며 OpenAI의 발표가 아닙니다. 가격 페이지에서 삭제됐다는 사실만으로 해당 모델의 서비스 종료를 의미하지는 않습니다. 페이지에는 단위 없이 가격이 기재되어 있습니다.OpenCode를 브라우저 개발자 도구에서 실행되도록 재구축
Adam(adamdotdev)은 11월 2일 X에서 console.log 문을 인터페이스로 사용해 OpenCode를 브라우저 개발자 도구 콘솔에서 실행되도록 재구축했다고 밝혔습니다. textjs.org에서 링크한 프레임워크를 기반으로 만들었으며, 개발자와 에이전트들이 이를 사용해 다른 콘솔 앱도 만들어 보도록 권했습니다. 게시물에 달린 메모에 따르면 VS Code 확장 프로그램은 개발 중이며, Chrome 개발자 도구 확장 프로그램도 추후 출시될 예정입니다.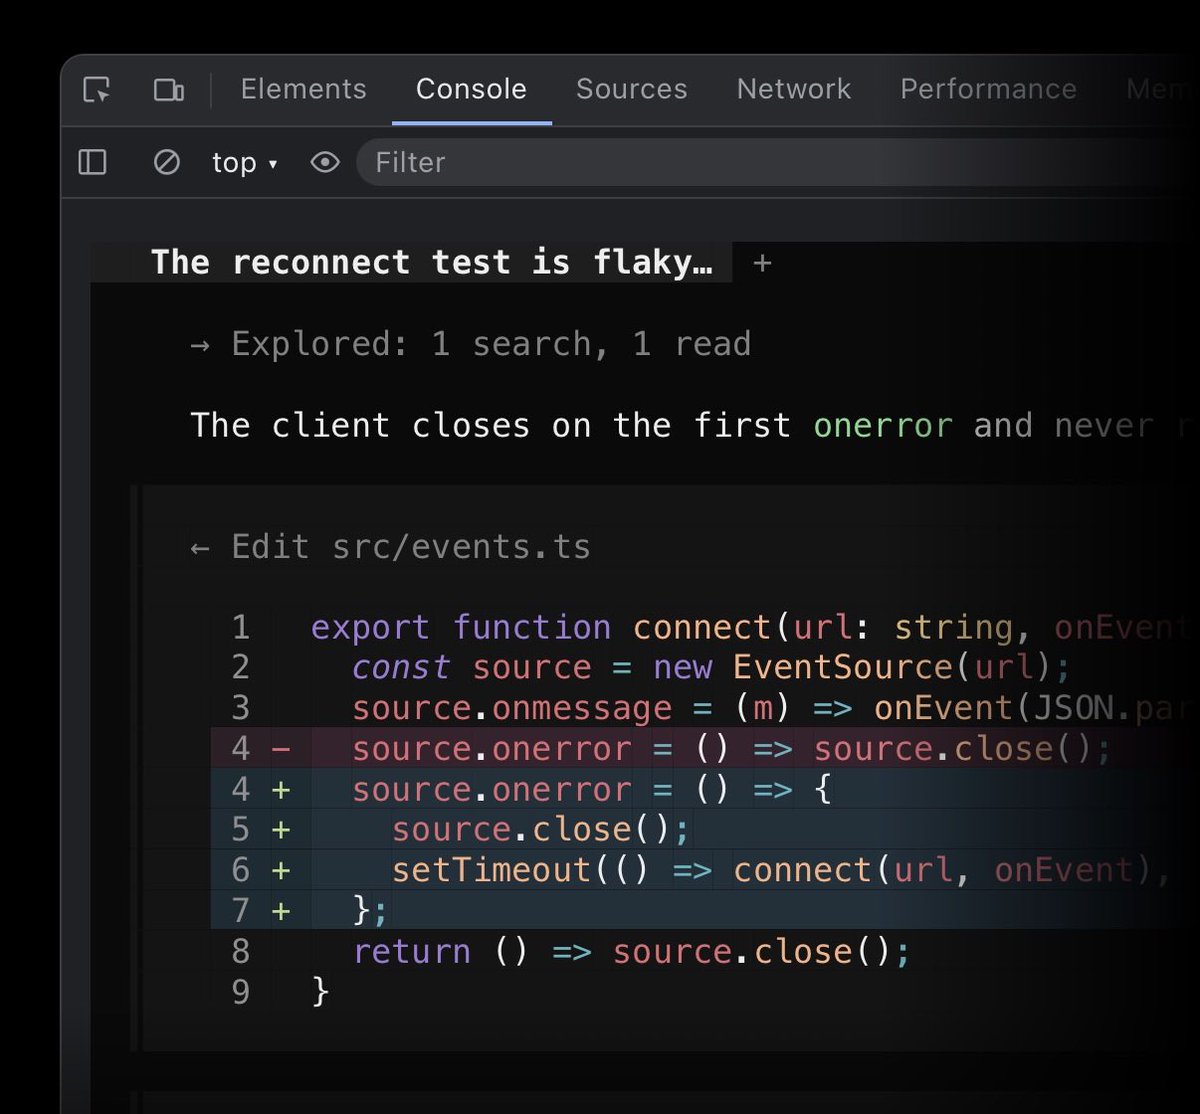
Anthropic, 어떤 모델이 응답을 생성했는지 증명하는 오픈소스 프로토타입 FlashProve 출시
Anthropic은 검증 가능한 추론에 관한 연구를 공개했습니다. 응답이 특정한, 사전에 커밋된 모델 가중치 집합에서 나왔음을 증명하는 암호학적 증명(zkSNARK)으로, 가중치를 갖고 있지 않은 사용자도 확인할 수 있습니다. 게시물은 라우팅 서비스가 모델을 몰래 바꿔치기하거나 공격자가 모델을 변조했는지 감지하는 데 도움이 되고, 평가자와 규제 당국이 어떤 모델이 제공되고 있는지 확인할 방법이 될 수 있다고 설명합니다.
Vercel Drives를 사용하는 Sandboxes, 이제 최대 2.4배 더 빠르게 시작
Vercel에 따르면 Drives를 사용하는 샌드박스가 이제 최대 2.4배 더 빠르게 시작됩니다. Vercel이 공개한 수치에 따르면 중앙값 생성 시간은 1.7초에서 0.7초로, p95는 2.2초에서 1.6초로 줄었습니다. SDK를 업그레이드하거나 설정을 변경할 필요가 없다고 Vercel은 밝혔습니다. 자세한 내용은 Vercel 변경 로그에서 확인할 수 있습니다.Arena: 상위 에이전트는 출력 토큰 하나당 입력 토큰을 약 93개 처리
리더보드를 운영하는 Arena에 따르면, 26,000건이 넘는 세션을 분석한 결과 Agent Arena의 상위 10개 에이전트는 생성 토큰 하나당 입력 토큰을 약 93개 처리합니다. Arena는 이것이 각 연구소가 캐시된 입력의 가격을 낮추기 위해 경쟁하는 이유라고 설명하며, 실제 세션에서 캐싱이 작동하는 모습을 담은 영상을 공유했습니다. 이 수치는 Arena 자체 분석 결과입니다.
Claude Messages API에 서버에서 대화를 캐싱하는 메시지 스레드 공개 베타 추가
Anthropic의 ClaudeDevs 계정에 따르면 Messages API의 메시지 스레드가 공개 베타로 제공되기 시작했습니다. API가 턴 사이에 대화를 서버에 보관하므로, 요청에는 전체 대화 기록 대신 새 메시지와 이전 메시지 ID만 담으면 됩니다. 이에 따라 Claude가 더 빨리 응답을 시작합니다.
Vercel 빌드에서 알려진 악성 npm 패키지를 설치 스크립트 실행 전에 차단
Vercel은 이제 빌드 과정에서 알려진 악성 npm 패키지가 설치 스크립트를 실행하기 전에 자동으로 차단한다고 밝혔습니다. 사용자가 취해야 할 조치는 없습니다. 자세한 내용은 Vercel의 변경 로그 항목에서 확인할 수 있습니다.OpenAI, 보안 버그 바운티 보상 인상… 보고서 품질과 참여도에 따른 보너스 추가
OpenAI는 보안 버그 바운티 프로그램의 보상을 인상한다고 밝혔으며, 중간·높음·치명적 등급 취약점의 보상 범위 중간값을 평균적으로 “4배 이상” 높인다고 설명했습니다.연구진 주장: GPT-6 Astra가 학습 없이 소형 Qwen 모델의 가중치를 편집해 수학 성능을 개선
rikiyatakehi 계정의 X 게시물에 따르면, 작성자들은 GPT-6 Astra에 Qwen3.5-0.8B의 가중치를 편집해 수학 성능을 개선해 달라고 요청했습니다. 이들은 모델이 가중치의 0.016%만 직접 변경해 소형 모델의 추론 루프를 바로잡고, 수학 성능을 최대 6배, 지시 수행 능력을 3배 높였으며, 그래디언트나 학습은 사용하지 않았다고 말합니다. 이 접근법을 Weight-Space Programming이라고 부릅니다.OpenAI, 일상적인 개인 비서 업무를 평가하는 벤치마크 LifeVal 공개
OpenAI는 수천 명의 ChatGPT 사용자가 개인 비서의 도움을 가장 필요로 하는 분야에 관한 피드백을 바탕으로 새로운 벤치마크 LifeVal을 만들었다고 밝혔습니다. 과제는 보육 서비스 찾기부터 정부 서비스 이용, 개인 재정 관리까지 다양합니다.Arena의 Agent Arena, 출력 토큰 및 대기 시간 대비 성능 그래프 추가
리더보드 제공업체 Arena는 Agent Arena에서 작업 비용뿐 아니라 생성된 출력 토큰당, 그리고 사용자가 기다리는 1분당 어떤 에이전트가 최고의 성능을 내는지 확인할 수 있게 됐다고 밝혔습니다. Arena에 따르면 같은 수준의 지능을 얻는 데 비용이 10배 더 들고, 출력 토큰이 6배 더 필요하며, 시간도 두 배 더 걸릴 수 있습니다.
Hume, 한 번의 호출로 오디오 관련 질문에 답하는 Audio Decision API 출시
Hume은 Audio Decision API를 통해 개발자가 오디오 속 화자 수, 누군가 웃고 있는지, 통화 상대가 불만스러워하는지 등을 물을 수 있다고 밝혔습니다. Hume은 이 API가 과거 10개 이상의 모델이 필요했던 작업을 대체한다고 설명합니다.OpenAI, Codex 규모의 개발을 위해 구축한 Git 호환 백엔드 Pando 소개
OpenAI 엔지니어들에 따르면 Codex로 회사 모노레포의 부하가 너무 빠르게 커졌습니다(개발 환경, 연구 작업, CI에서 브랜치·푸시·병합·페치·클론이 증가). 2025년 말 무렵부터 페치와 푸시가 느려지고 병합이 실패했으며, 안정성은 한때 90% 아래로 떨어졌습니다. 이에 대응해 Git 저장소용 새 백엔드 Pando를 구축했으며, OpenAI는 현재 자사 모노레포의 모든 개발을 Pando가 뒷받침한다고 밝혔습니다.DeepSeek Harness, 아이디어를 플러그인으로 만드는 Creator Mode 추가
DeepSeek Harness 계정은 11월 2일 X에서 아이디어를 직접 사용할 수 있는 플러그인으로 만드는 모드인 Creator Mode를 발표했습니다. 데모 영상에는 디자인 작업 공간, 샌드박스 게임, LLM을 3D로 시각화한 도구가 예시로 등장합니다. 후속 게시물에서 계정은 영상 속 플러그인을 만든 영어 및 중국어 프롬프트 모음을 링크했습니다.
GLM-5.3을 기반으로 후학습한 오픈 웨이트 과학 모델 Hydrogen-1.0 출시
Chenru Duan이 팀의 첫 과학 연구용 오픈 웨이트 모델이라고 소개한 Hydrogen-1.0을 발표했습니다. 이 모델은 Z.ai의 GLM-5.3을 팀 내부의 과학 데이터, 연구실 기록, 발견 과정 데이터로 후학습했습니다.
SemiAnalysis, 최고 모델 점수가 12%인 에이전트형 벤치마크 GDPx 공개
SemiAnalysis가 칩 설계, 사이버 보안, 생물학 등 가장 가치가 높다고 보는 분야의 에이전트형 역량을 평가하는 벤치마크 GDPx를 공개했습니다. SemiAnalysis에 따르면 최고 모델도 점수는 12%에 불과합니다. 결과를 전한 한 게시물은 Claude Opus 5.5가 12.0%로 1위, 출시 예정인 Gemini 4 Carbon이 10.9%라고 보고했습니다. 이는 해당 게시물 작성자의 해석이지 SemiAnalysis의 자체 설명은 아닙니다.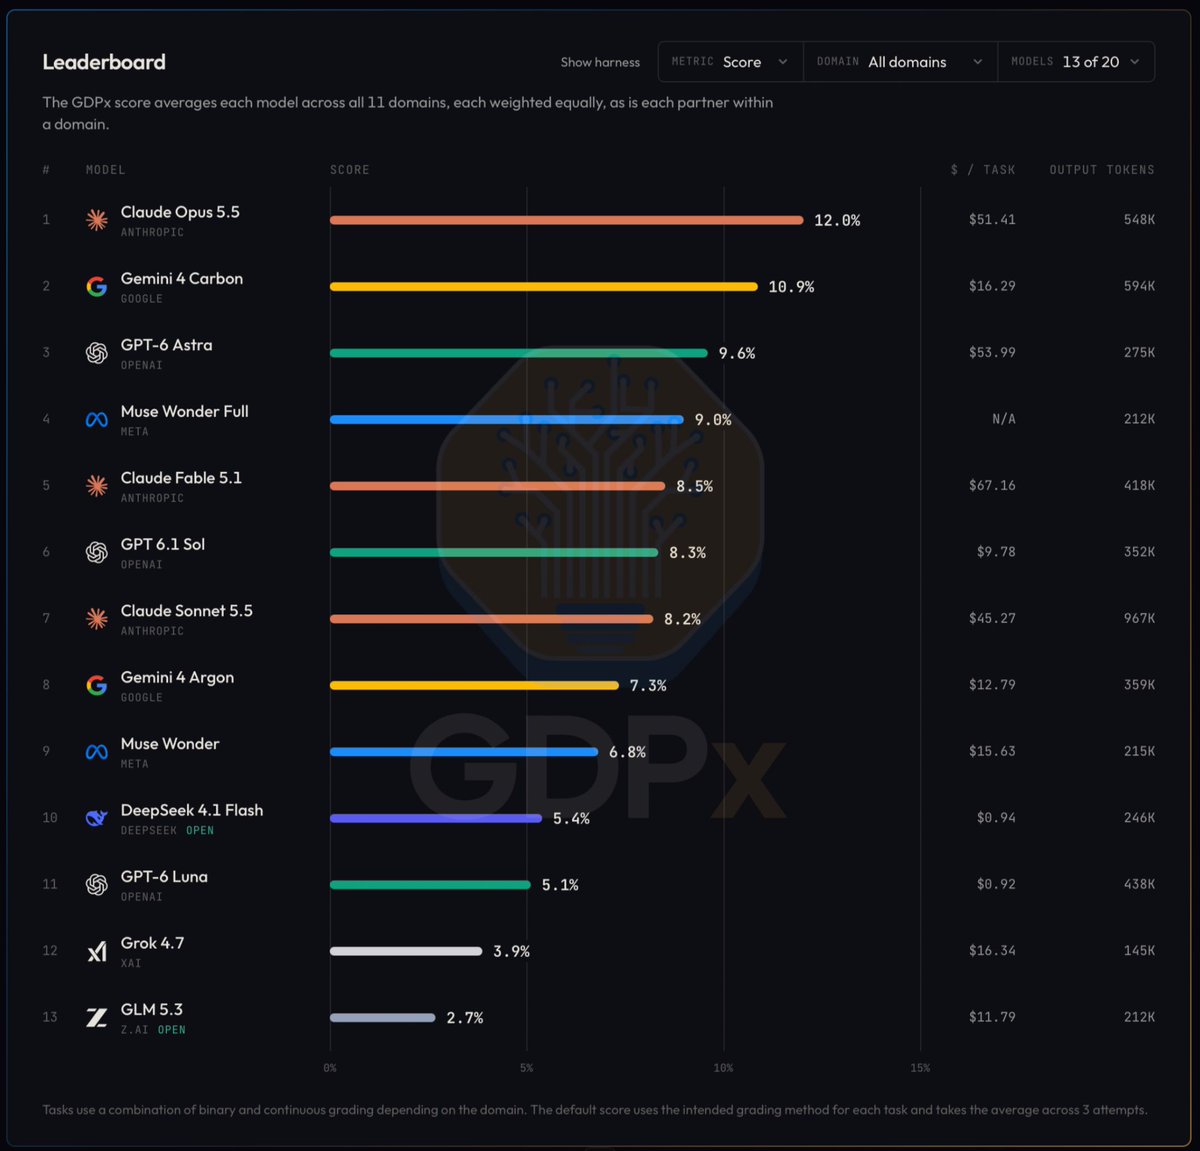
Meituan, 에이전트 작업용 1.6T 파라미터 멀티모달 모델 LongCat-2.5 출시
X 계정 leo114119의 게시물에 따르면 Meituan이 LongCat-2.5를 출시했습니다. 해당 게시물은 Meituan의 LongCat 블로그로 연결됩니다. 게시물에 따르면 Meituan은 이 모델을 에이전트 작업을 위해 구축한 네이티브 멀티모달 모델이라고 설명하며, 복잡한 시각적 코딩 프로젝트와 창의적 디자인, 3D 작업, 비즈니스 분석 같은 전문 사무 업무에서 강점을 보인다고 합니다. 파라미터는 1조 6천억 개입니다.
MiniMax, M3.1 Flash를 로컬에서 실행할 수 있도록 커뮤니티 양자화 버전 소개
MiniMax는 자체 하드웨어에서 모델을 실행하려는 사용자를 위해 428B 파라미터 오픈 웨이트 모델 M3.1 Flash의 커뮤니티 제작 양자화 버전을 정리해 공개했습니다. MiniMax에 따르면 저비트 가중치는 모델을 불러오는 데 필요한 메모리와 디코딩 중 전송되는 가중치 데이터의 양을 줄여 줍니다. 이를 유용하게 구현하려면 세심한 보정, 효율적인 저비트 커널, GPU와 시스템 RAM에 전문가를 배치하는 작업이 필요합니다.
Claude Mythos 5.5는 발표되지 않았지만 Anthropic 웹사이트 소스에 언급돼 있다
Anthropic은 Claude Mythos 5.5를 발표하지 않았습니다. 여러 X 계정은 Anthropic의 Claude Mythos 페이지(anthropic.com/claude/mythos)의 HTML 소스에 해당 이름이 등장한다고 전했습니다.
Google announces Gemini 4 Carbon, its next frontier model, to cyber defenders first
Google announced Gemini 4 Carbon on October 28, 2026, calling it its strongest model, with state-of-the-art cybersecurity and long-horizon capabilities. It follows Gemini 4 Argon by two weeks. Sundar Pichai's post and Google's blog say it is not yet generally available: starting this week a subset of cyber defenders get access, with more trusted partners added through the Fairwind Program. Google says it will bring Carbon to developers, businesses and consumers "as soon as possible", and that it is taking part in the U.S. government's voluntary process for pre-release model testing.