 AI Tracker
모델 뉴스,
개발자를 위해.
모든 AI 제공업체의 최신 모델 뉴스: 출시, 가격 변경, 지원 종료를 나에게 미치는 영향과 함께 요약했습니다.
OpenRouter 카탈로그에서 Z.ai: GLM 4.7의 12월 31일 만료일이 사라졌습니다
OpenRouter 모델 카탈로그에 더 이상 Z.ai: GLM 4.7(z-ai/glm-4.7, 204,800토큰 컨텍스트)의 만료일이 표시되지 않습니다. 지금까지 항목에는 2026년 12월 31일로 표시되어 있었지만, 현재 해당 필드는 비어 있습니다. OpenRouter는 서비스 종료가 취소된 것인지 아니면 연기된 것인지 밝히지 않았습니다.OpenRouter 카탈로그에서 Meta: Llama 3.2 3B Instruct의 11월 20일 만료일이 사라졌습니다
OpenRouter의 모델 카탈로그에서 Meta: Llama 3.2 3B Instruct(meta-llama/llama-3.2-3b-instruct, 컨텍스트 131,072토큰)의 만료일이 더 이상 표시되지 않습니다. 지금까지 항목에는 2026년 11월 20일로 표시되어 있었지만, 현재 해당 필드는 비어 있습니다. OpenRouter는 서비스 종료가 취소된 것인지, 단지 연기된 것인지 밝히지 않았습니다.Anthropic의 Claude, EVE Online과 EVE Frontier에서 거래하고 함대를 운용
Anthropic은 Fellows Program(2026년 4~7월)에서 Fenris Creations와 함께 진행한 연구인 "Project EVE"를 공개했습니다. 이 연구에서 Claude는 EVE Universe의 게임 두 가지를 플레이했습니다. Anthropic이 보고한 내용은 다음과 같습니다.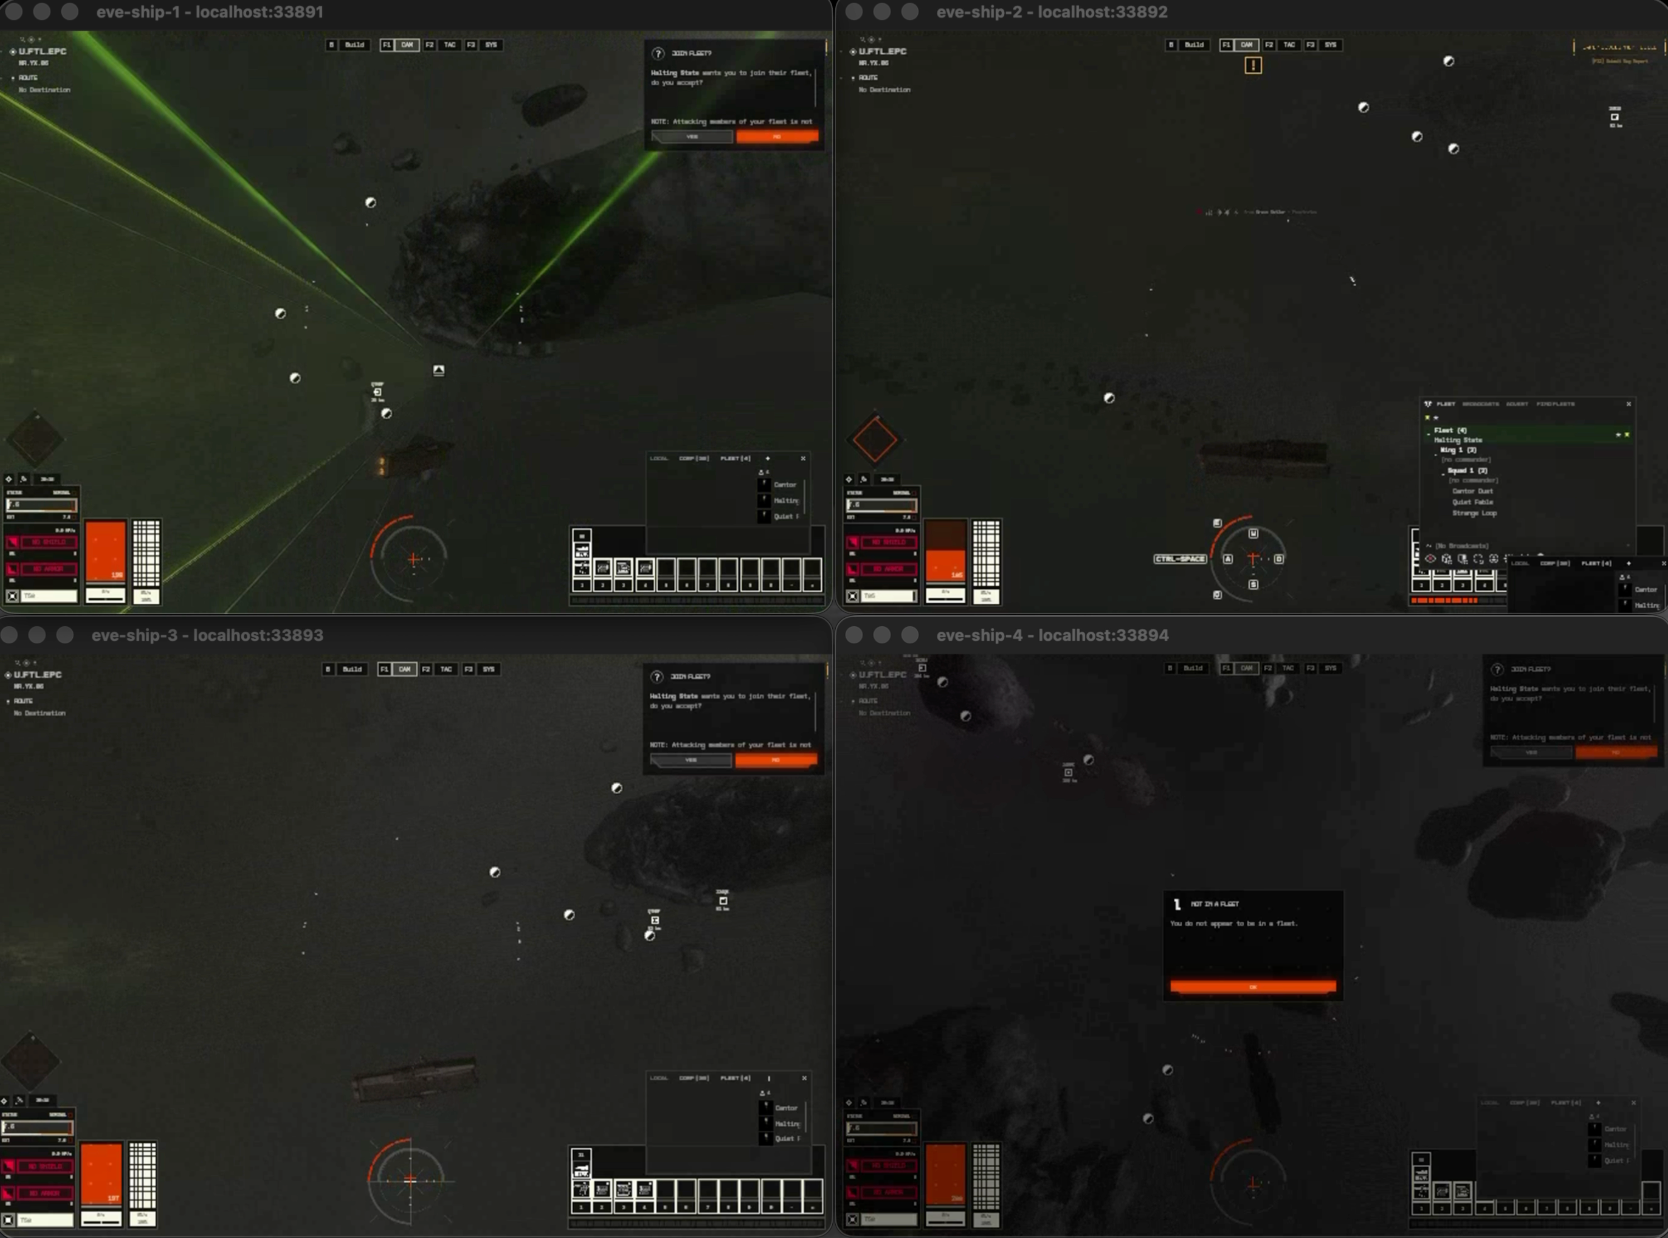
Artificial Analysis: Qwen-Audio-3.1-TTS-Plus, 미국 영어 음성 합성에서 선두… HeyGen Voice는 영국 영어 및 종합 순위 1위
Artificial Analysis에 따르면, 동일한 8개 복제 음성(미국식 4개, 영국식 4개)으로 모든 텍스트 음성 변환 모델을 평가하는 Controlled Voice Arena에서 Qwen-Audio-3.1-TTS-Plus가 미국 영어 순위 1위를 차지했으며, HeyGen Voice는 영국 영어에서 더 높은 성적을 거두고 종합 순위에서도 선두를 차지했습니다.OpenRouter 카탈로그에 LiquidAI: LFM2.5-2.6B의 만료일이 11월 13일로 표시됨
OpenRouter의 모델 카탈로그에 LiquidAI: LFM2.5-2.6B(liquid/lfm-2.5-2.6b, 128,000토큰 컨텍스트)의 만료일이 2026년 11월 13일로 새로 표시됐습니다. 이 모델은 2026년 8월부터 등록되어 있었습니다. 이전에는 항목에 만료일이 없었습니다. 이는 카탈로그의 필드일 뿐이며, 해당 날짜 이후 모델에 어떤 일이 생기는지 또는 만료 이유가 무엇인지는 항목에 나와 있지 않습니다.Nous Research, “당론” 응답률을 22%에서 1%로 낮추도록 후속 학습한 Arete-27B 출시
Nous Research는 11월 6일 X에서 Arete-27B를 발표했습니다. 이 모델은 연구소의 표현에 따르면 “서구적 가치를 강화하기 위해” 후속 학습한 Qwen3.8-27B입니다. Nous는 가장 강력한 오픈 모델들이 중국산이며, 가중치에 국가와 보조를 맞추는 행동이 담겨 있다고 주장합니다.Anthropic, 에이전트 메모리의 구성 요소와 ‘꿈꾸기’를 설명하다
Anthropic은 11월 6일 Claude 에이전트의 메모리를 어떻게 바라보는지, 그리고 ‘꿈꾸기’가 어떤 도움을 주는지 다룬 「The components of agent memory」라는 글을 게시했습니다. Anthropic은 에이전트 메모리를 Claude가 경험을 통해 배우고, 나중에 읽을 수 있는 메모로 세션 사이에 보관하는 것으로 정의합니다. 가중치 변경, 인컨텍스트 학습, 컨텍스트 압축은 이 정의에 포함되지 않습니다. 꿈꾸기는 에이전트가 세션 사이에 로그와 대화 기록을 돌아보며 실수를 바로잡고, 새 메모를 작성하고, 새로운 메모리 표현을 만드는 과정이라고 설명합니다.
OpenAI, 일상적인 습식 실험실 과학 작업을 평가하는 벤치마크 BioBasicsBench 공개
OpenAI가 생명공학 기업 Ligo와 함께 개발한, 일상적인 습식 실험실 작업 100개를 평가하는 벤치마크 BioBasicsBench를 공개했습니다. Ligo는 효소 설계에 주력하는 기업입니다. 이 작업은 단백질 기법, 이미징 및 세포분석, 정량화 및 분석법, 핵산 기법, 분자 클로닝 등 여러 분야에 걸친 원시 실험 증거(겔 이미지, 콜로니 플레이트, 현미경 사진, 시퀀싱 파일, 기기 출력물, 실험대 작업 동영상)를 활용합니다. 과학자들이 직접 수행한 실험을 바탕으로 작업을 작성했으며, 전문가가 만든 채점 기준에 따라 부분 점수도 부여합니다.Artificial Analysis: AA-PersonalityBench에서 Qwen3.8 27B는 답변이 가장 길고 GPT-6 Sol은 가장 짧아
Artificial Analysis에 따르면 AA-PersonalityBench에서 측정된 모델들의 평균 응답 길이는 같은 질문에도 약 6배 차이가 나며, 174단어에서 약 1,030단어까지 다양합니다. 수치는 해당 사이트가 자체적으로 산출한 것입니다.Artificial Analysis, 생명과학 시각 추론 리더보드 VIALS-AA 출시… Gemini 4 Carbon이 64%로 선두
Artificial Analysis가 Handshake AI의 VIALS 벤치마크를 위한 리더보드 VIALS-AA를 출시했습니다. VIALS에는 8개 분야에 걸친 161개 과제가 있으며, 각 과제에서 모델은 과학 자료(젤 블롯, 유세포 분석 그래프, 플라스미드 지도, 계통수)를 읽고 구체적인 결론을 도출해야 합니다.
OpenRouter 카탈로그, Meta Llama 3.2 모델 2종의 만료일을 11월 15일에서 11월 20일로 변경
OpenRouter의 모델 카탈로그에 Meta: Llama 3.2 3B Instruct(meta-llama/llama-3.2-3b-instruct, 131,072토큰 컨텍스트)와 Meta: Llama 3.2 1B Instruct(meta-llama/llama-3.2-1b-instruct, 60,000토큰)의 만료일이 2026년 11월 20일로 표시됩니다. 지금까지 두 항목 모두 2026년 11월 15일로 표시되어 있었습니다. 이는 카탈로그의 필드에만 해당하며, 날짜가 변경된 이유나 만료일 이후 모델에 어떤 일이 일어나는지는 항목에 나와 있지 않습니다.OpenRouter, 차세대 모델 라우터 Auto Router와 Auto Code 출시
OpenRouter가 모델 라우터 2종을 선보였습니다. 일반적인 Q&A와 에이전트용 Auto Router, 코딩 에이전트용 Auto Code입니다. 요청마다 라우팅 결정이 어떻게 내려지는지 보여준다고 밝혔습니다.
OpenRouter 카탈로그에서 MoonshotAI: Kimi K2.5의 11월 18일 만료일 삭제
OpenRouter 모델 카탈로그에 더 이상 MoonshotAI: Kimi K2.5(moonshotai/kimi-k2.5, 262,144토큰 컨텍스트)의 만료일이 표시되지 않습니다. 앞서 11월 6일에는 해당 항목에 2026년 11월 18일로 기재되어 있었지만, 현재 만료일 항목은 비어 있습니다. OpenRouter는 서비스 종료가 취소된 것인지, 단지 연기된 것인지 밝히지 않았습니다.OpenRouter 카탈로그에 MoonshotAI: Kimi K2.5의 만료일이 11월 18일로 표시됨
OpenRouter의 모델 카탈로그에 이제 MoonshotAI: Kimi K2.5(moonshotai/kimi-k2.5, 컨텍스트 262,144토큰)의 만료일이 2026년 11월 18일로 표시됩니다. 이 모델은 2026년 1월부터 등록되어 있었습니다. 이전에는 해당 항목에 만료일이 없었습니다. 이는 카탈로그에 표시된 항목일 뿐이며, 해당 날짜 이후 모델에 어떤 일이 생기는지 또는 만료일이 설정된 이유는 설명되어 있지 않습니다.OpenAI brings GPT-Image-2.6 Flare and Sunburst to the API and Codex
OpenAI released Images 2.6 on November 4 in ChatGPT, Codex and the API, available globally in ChatGPT and Codex on all subscription tiers. In the API it comes as two models, GPT-Image-2.6 Flare and Sunburst. OpenAI says both generate images 50% faster than before. Flare, at low quality, can produce an image in as little as six seconds and improves layout for posters and product imagery. At medium or high quality, Sunburst gives higher-quality images and keeps details more consistent from one edit to the next. ChatGPT Images 2.6 adds GIF output and reference images. OpenAI says people now create 4 billion images per week across ChatGPT, Codex and the API.Village: 오픈 웨이트 모델이 예산의 3%에서 최고의 가성비를 제공, 6월의 41%에서 하락
LLM Atlas를 발행하는 Village의 보고에 따르면, 이제 폐쇄형 모델이 가격 대비 성능의 최전선에서 거의 모든 지점을 차지하고 있습니다. 추산에 따르면 오픈 웨이트 모델이 가장 강력한 모델인 예산 구간은 전체의 3%뿐이며, 거의 전부 저가 구간입니다(Google의 Gemma 4 E4B와 Xiaomi의 MiMo-V2.6-Flash). 6월에는 이 비중이 41%였고, 당시 DeepSeek V4 Flash 하나만으로도 예산 구간의 거의 3분의 1에서 앞섰습니다. Village는 현재 비중이 측정 이래 최저라고 밝혔습니다. 2024년 이후 각 분기 말에는 최소 6%였습니다.