 AI Tracker
Actus modèles,
pour les devs.
Les dernières actus « modèles » de tous les fournisseurs d'IA : lancements, changements de prix et retraits, résumés avec ce qu'ils changent pour vous.
Le catalogue d’OpenRouter retire la date d’expiration du 31 décembre pour Z.ai: GLM 4.7
Le catalogue de modèles d’OpenRouter n’affiche plus de date d’expiration pour Z.ai: GLM 4.7 (z-ai/glm-4.7, contexte de 204 800 tokens). Jusqu’à présent, l’entrée indiquait le 31 décembre 2026 ; le champ est désormais vide. OpenRouter n’a pas précisé si le retrait est annulé ou simplement reporté.Le catalogue d’OpenRouter supprime la date d’expiration du 20 novembre pour Meta: Llama 3.2 3B Instruct
Le catalogue de modèles d’OpenRouter n’affiche plus de date d’expiration pour Meta: Llama 3.2 3B Instruct (meta-llama/llama-3.2-3b-instruct, contexte de 131 072 tokens). Jusqu’à présent, l’entrée indiquait le 20 novembre 2026 ; le champ est désormais vide. OpenRouter n’a pas précisé si le retrait est annulé ou simplement reporté.Anthropic fait commercer et voler des flottes à Claude dans EVE Online et EVE Frontier
Anthropic a publié « Project EVE », une recherche menée dans le cadre de son programme Fellows (avril–juillet 2026) avec Fenris Creations, dans laquelle Claude a joué à deux jeux de l’univers EVE. Voici les résultats rapportés par Anthropic.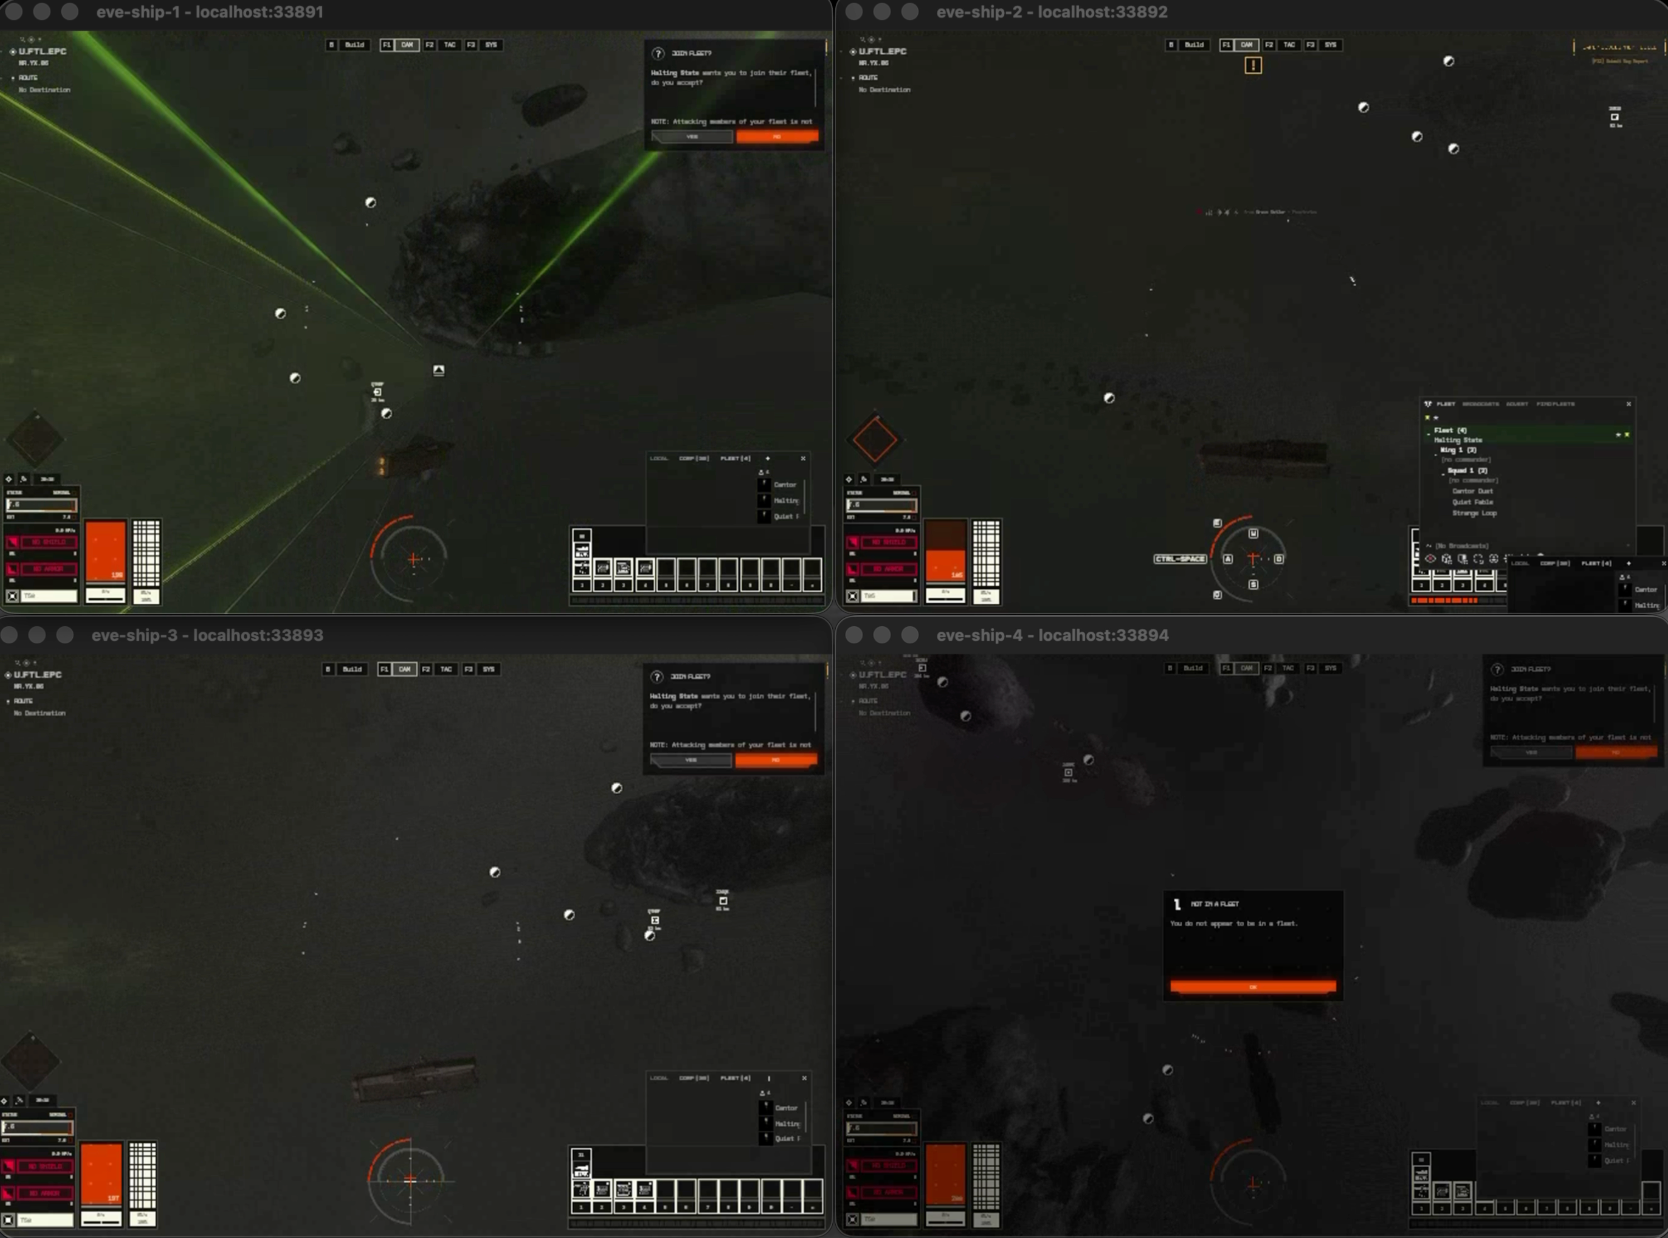
Artificial Analysis : Qwen-Audio-3.1-TTS-Plus domine la synthèse vocale en anglais américain, HeyGen Voice domine en anglais britannique et au classement général
Selon Artificial Analysis, dans son Controlled Voice Arena, qui évalue chaque modèle de synthèse vocale à partir des mêmes huit voix clonées (quatre américaines et quatre britanniques), Qwen-Audio-3.1-TTS-Plus arrive en tête du classement en anglais américain, tandis que HeyGen Voice obtient de meilleurs résultats en anglais britannique et domine le classement général.Le catalogue d’OpenRouter indique le 13 novembre comme date d’expiration pour LiquidAI: LFM2.5-2.6B
Le catalogue de modèles d’OpenRouter affiche désormais le 13 novembre 2026 comme date d’expiration pour LiquidAI: LFM2.5-2.6B (liquid/lfm-2.5-2.6b, contexte de 128 000 tokens), référencé depuis août 2026. L’entrée n’avait auparavant aucune date d’expiration. Il s’agit uniquement d’un champ du catalogue ; l’entrée n’indique ni pourquoi cette date a été choisie ni ce qu’il adviendra du modèle après cette date.Nous Research lance Arete-27B, un Qwen3.8-27B post-entraîné pour faire passer le taux de « ligne du parti » de 22 % à 1 %
Nous Research a annoncé Arete-27B sur X le 6 novembre. Il s’agit d’un Qwen3.8-27B post-entraîné, selon les termes du laboratoire, « pour renforcer les valeurs occidentales ». Nous soutient que les meilleurs modèles ouverts sont chinois et intègrent dans leurs poids des comportements alignés sur l’État.Anthropic explique les composantes de la mémoire des agents et le « dreaming »
Anthropic a publié le 6 novembre un article intitulé « The components of agent memory », dans lequel l’entreprise explique sa conception de la mémoire des agents Claude et le rôle du « dreaming ». Anthropic définit la mémoire d’un agent comme ce que Claude apprend de son expérience et conserve entre les sessions sous forme de notes qu’il pourra relire plus tard ; les modifications des poids, l’apprentissage en contexte et la compaction ne relèvent pas de cette définition. Le « dreaming » désigne le processus par lequel l’agent réfléchit à ses journaux et transcriptions entre les sessions afin de corriger ses erreurs, rédiger de nouvelles notes et créer de nouvelles représentations de sa mémoire.
OpenAI présente BioBasicsBench, un benchmark de tâches courantes en laboratoire expérimental
OpenAI présente BioBasicsBench, un benchmark de 100 tâches courantes en laboratoire expérimental, développé avec Ligo, une entreprise de biotechnologie spécialisée dans la conception d’enzymes. Les tâches s’appuient sur des données expérimentales brutes (images de gels, boîtes de culture, images de microscopie, fichiers de séquençage, exports d’instruments et vidéos de manipulations à la paillasse) et couvrent les méthodes liées aux protéines, l’imagerie et la cytométrie, la quantification et les tests, les méthodes liées aux acides nucléiques et le clonage moléculaire. Des scientifiques les ont élaborées à partir de leurs propres expériences, et les réponses sont évaluées à l’aide de grilles de notation rédigées par des experts, qui accordent des points partiels.Artificial Analysis : sur AA-PersonalityBench, Qwen3.8 27B rédige les réponses les plus longues et GPT-6 Sol les plus courtes
Selon Artificial Analysis, la longueur moyenne des réponses sur AA-PersonalityBench varie d’environ 6 fois parmi les modèles évalués, de 174 à environ 1 030 mots pour les mêmes questions. Ces chiffres proviennent du site lui-même.Artificial Analysis lance VIALS-AA, un classement du raisonnement visuel en sciences de la vie où Gemini 4 Carbon arrive en tête avec 64 %
Artificial Analysis a lancé VIALS-AA, un classement fondé sur le benchmark VIALS de Handshake AI. VIALS comprend 161 tâches réparties dans huit domaines. Pour chacune, un modèle doit interpréter un document scientifique (blots de gels, graphiques de cytométrie en flux, cartes plasmidiques, phylogénies) et en tirer une conclusion précise.
Le catalogue d’OpenRouter reporte du 15 au 20 novembre la date d’expiration de deux modèles Meta Llama 3.2
Le catalogue de modèles d’OpenRouter indique désormais une date d’expiration au 20 novembre 2026 pour Meta: Llama 3.2 3B Instruct (meta-llama/llama-3.2-3b-instruct, contexte de 131 072 tokens) et Meta: Llama 3.2 1B Instruct (meta-llama/llama-3.2-1b-instruct, 60 000 tokens). Jusqu’à présent, les deux fiches indiquaient le 15 novembre 2026. Il s’agit uniquement d’un champ du catalogue : les fiches n’expliquent pas pourquoi la date a changé ni ce qu’il adviendra des modèles après cette date.OpenRouter lance Auto Router et Auto Code, une nouvelle génération de routeurs de modèles
OpenRouter a présenté deux routeurs de modèles : Auto Router, destiné aux questions-réponses générales et aux agents, et Auto Code, conçu pour les agents de programmation. L’entreprise indique que le système montre comment la décision de routage est prise pour chaque requête.
Le catalogue d’OpenRouter supprime la date d’expiration du 18 novembre pour MoonshotAI: Kimi K2.5
Le catalogue de modèles d’OpenRouter n’affiche plus de date d’expiration pour MoonshotAI: Kimi K2.5 (moonshotai/kimi-k2.5, contexte de 262 144 tokens). Le 6 novembre, l’entrée indiquait auparavant le 18 novembre 2026 ; le champ est désormais vide. OpenRouter n’a pas précisé si le retrait est annulé ou simplement reporté.Le catalogue d’OpenRouter indique le 18 novembre comme date d’expiration pour MoonshotAI: Kimi K2.5
Le catalogue de modèles d’OpenRouter indique désormais le 18 novembre 2026 comme date d’expiration pour MoonshotAI: Kimi K2.5 (moonshotai/kimi-k2.5, contexte de 262 144 tokens), répertorié depuis janvier 2026. L’entrée ne comportait auparavant aucune date d’expiration. Il s’agit uniquement d’un champ du catalogue : l’entrée n’indique ni la raison ni ce qu’il adviendra du modèle après cette date.OpenAI brings GPT-Image-2.6 Flare and Sunburst to the API and Codex
OpenAI released Images 2.6 on November 4 in ChatGPT, Codex and the API, available globally in ChatGPT and Codex on all subscription tiers. In the API it comes as two models, GPT-Image-2.6 Flare and Sunburst. OpenAI says both generate images 50% faster than before. Flare, at low quality, can produce an image in as little as six seconds and improves layout for posters and product imagery. At medium or high quality, Sunburst gives higher-quality images and keeps details more consistent from one edit to the next. ChatGPT Images 2.6 adds GIF output and reference images. OpenAI says people now create 4 billion images per week across ChatGPT, Codex and the API.Village : les modèles à poids ouverts sont le meilleur choix pour 3 % des budgets, contre 41 % en juin
Village, qui publie le LLM Atlas, rapporte que les modèles propriétaires occupent désormais presque tous les points du meilleur rapport prix-performances. Selon ses estimations, un modèle à poids ouverts est le plus performant pour 3 % des budgets, presque tous situés dans le bas de gamme (Gemma 4 E4B de Google et MiMo-V2.6-Flash de Xiaomi). En juin, cette part était de 41 %, DeepSeek V4 Flash étant alors à lui seul en tête pour près d’un tiers des budgets. Village indique que la part actuelle est la plus faible qu’il ait mesurée ; à la fin de chaque trimestre depuis 2024, elle était d’au moins 6 %.