 AI Tracker
Noticias de modelos,
para desarrolladores.
Lo último en modelos de todos los proveedores de IA: lanzamientos, cambios de precio y retiradas, resumidos con lo que significan para ti.
El catálogo de OpenRouter elimina la fecha de vencimiento del modelo Z.ai: GLM 4.7
El catálogo de modelos de OpenRouter ya no muestra una fecha de vencimiento para Z.ai: GLM 4.7 (z-ai/glm-4.7, contexto de 204.800 tokens). Hasta ahora, la entrada indicaba el 31 de diciembre de 2026; ahora el campo está vacío. OpenRouter no ha dicho si la retirada se cancela o solo se aplaza.El catálogo de OpenRouter elimina la fecha de caducidad del 20 de noviembre de Meta: Llama 3.2 3B Instruct
El catálogo de modelos de OpenRouter ya no muestra una fecha de caducidad para Meta: Llama 3.2 3B Instruct (meta-llama/llama-3.2-3b-instruct, contexto de 131.072 tokens). La entrada indicaba el 20 de noviembre de 2026 hasta ahora; el campo está vacío. OpenRouter no ha dicho si la retirada se cancela o solo se pospone.Anthropic tiene flotas de comercio y combate de Claude en EVE Online y EVE Frontier
Anthropic publicó «Project EVE», una investigación del programa Fellows (abril–julio de 2026) realizada con Fenris Creations, en la que Claude jugó a dos juegos del universo EVE. Anthropic informa lo siguiente.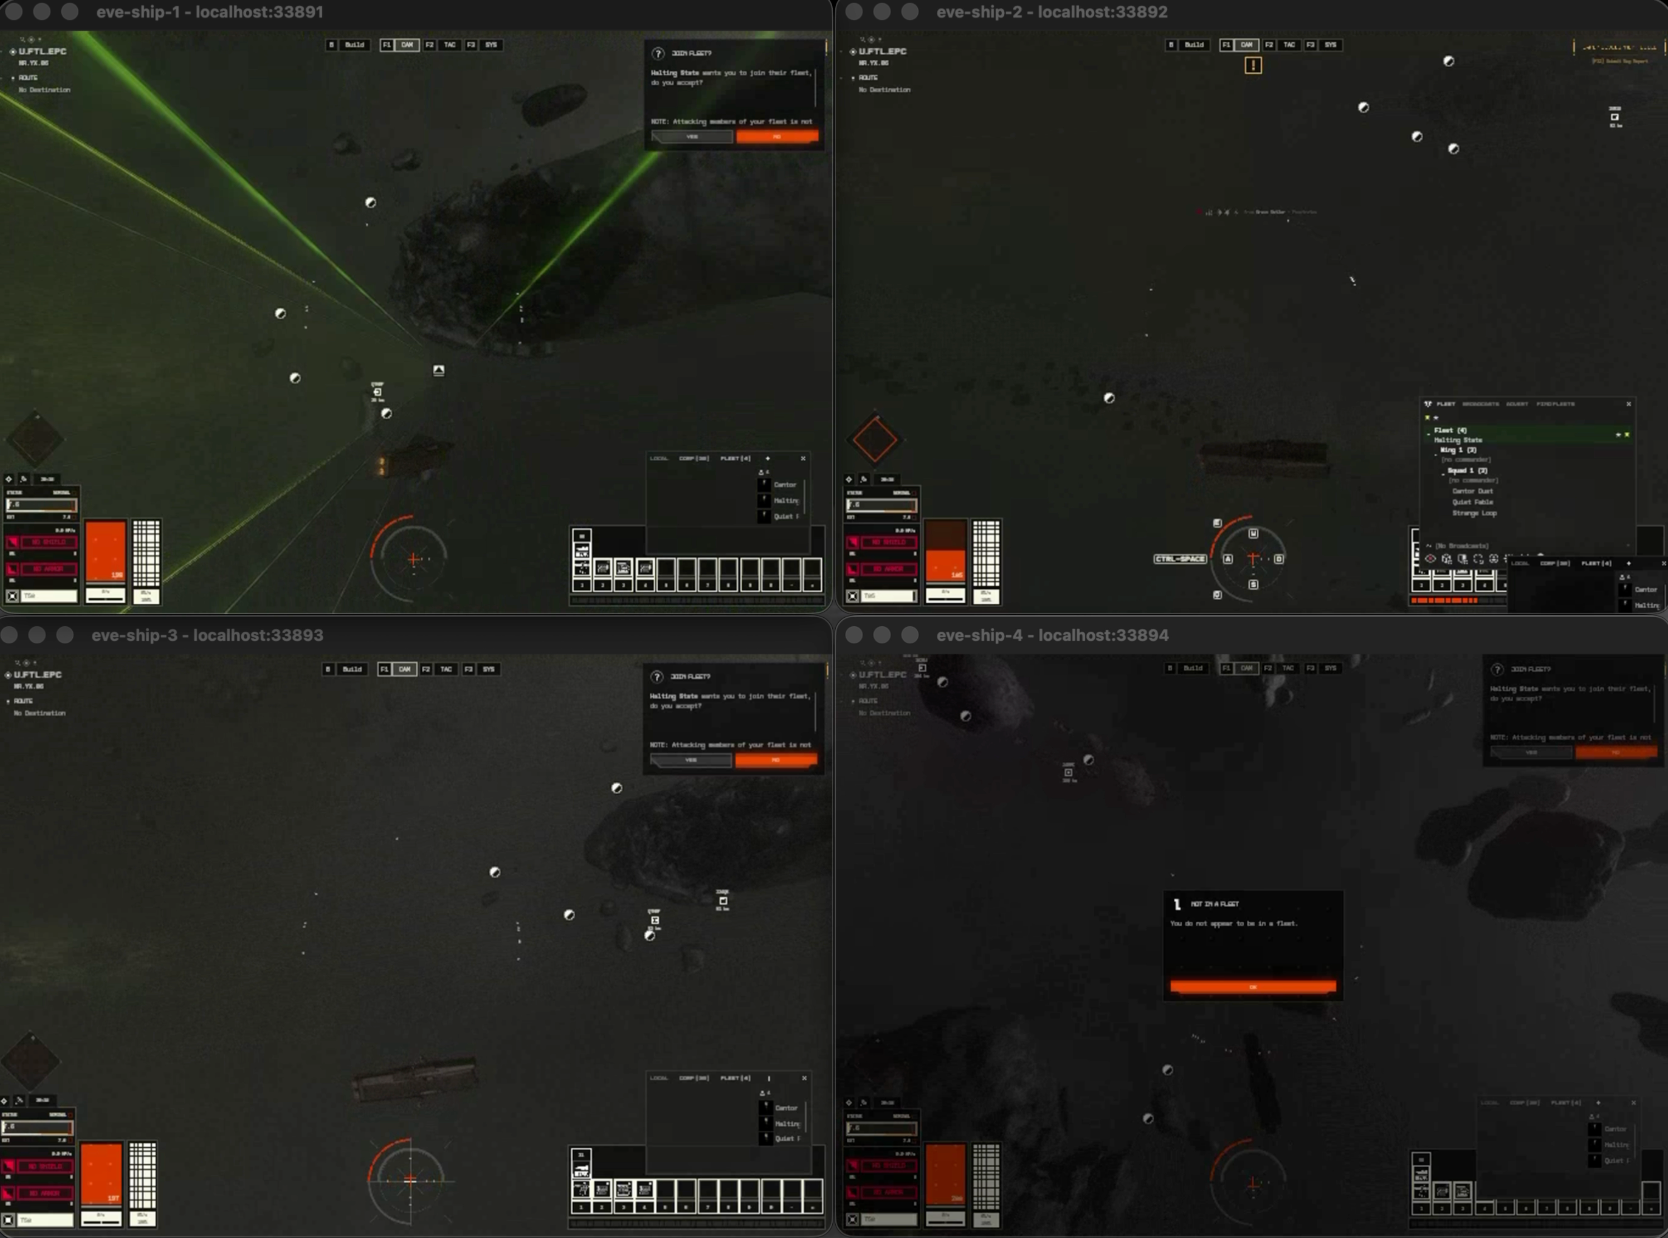
Artificial Analysis: Qwen-Audio-3.1-TTS-Plus lidera en texto a voz en inglés de EE. UU.; HeyGen Voice lidera en inglés del Reino Unido y en la clasificación general
Artificial Analysis afirma que, en su Controlled Voice Arena, que puntúa todos los modelos de texto a voz con las mismas ocho voces clonadas (cuatro de EE. UU. y cuatro del Reino Unido), Qwen-Audio-3.1-TTS-Plus lidera la clasificación en inglés de EE. UU., mientras que HeyGen Voice obtiene mejores resultados en inglés del Reino Unido y encabeza la clasificación general.El catálogo de OpenRouter asigna a LiquidAI: LFM2.5-2.6B una fecha de expiración del 13 de noviembre
El catálogo de modelos de OpenRouter ahora muestra el 13 de noviembre de 2026 como fecha de expiración de LiquidAI: LFM2.5-2.6B (liquid/lfm-2.5-2.6b, contexto de 128.000 tokens), disponible desde agosto de 2026. Antes, la ficha no tenía fecha de expiración. Se trata solo de un campo del catálogo; la ficha no indica el motivo ni qué ocurrirá con el modelo después de esa fecha.Nous Research lanza Arete-27B, Qwen3.8-27B con posentrenamiento para reducir del 22 % al 1 % la tasa de adhesión a la «línea del partido»
Nous Research anunció Arete-27B en X el 6 de noviembre. Se trata de Qwen3.8-27B con posentrenamiento, según palabras del laboratorio, «para reforzar los valores occidentales». Nous sostiene que los modelos abiertos más potentes son chinos y vienen con comportamientos alineados con el Estado incorporados en sus pesos.Anthropic explica los componentes de la memoria de agentes y el «dreaming»
Anthropic publicó el 6 de noviembre una entrada titulada «The components of agent memory», en la que explica cómo concibe la memoria de los agentes Claude y cómo ayuda el «dreaming». Anthropic define la memoria de agentes como aquello que Claude aprende de la experiencia y conserva entre sesiones en forma de notas que puede leer más adelante; los cambios en los pesos, el aprendizaje en contexto y la compactación quedan fuera de esa definición. Describe el dreaming como un proceso en el que el agente reflexiona sobre sus registros y transcripciones entre sesiones para corregir errores, escribir notas nuevas y crear nuevas representaciones de la memoria.
OpenAI presenta BioBasicsBench, una prueba de referencia de tareas cotidianas de ciencia de laboratorio húmedo
OpenAI presenta BioBasicsBench, una prueba de referencia de 100 tareas rutinarias de laboratorio húmedo, creada junto con Ligo, una empresa biotecnológica centrada en el diseño de enzimas. Las tareas utilizan evidencia experimental sin procesar (imágenes de geles, placas de colonias, microscopía, archivos de secuenciación, exportaciones de instrumentos y videos del trabajo en el laboratorio) en métodos de proteínas, imagenología y citometría, cuantificación y ensayos, métodos de ácidos nucleicos y clonación molecular. Científicos las diseñaron a partir de sus propios experimentos, y las respuestas se califican con rúbricas redactadas por expertos que otorgan crédito parcial.Artificial Analysis: en AA-PersonalityBench, Qwen3.8 27B escribe las respuestas más largas y GPT-6 Sol las más cortas
Artificial Analysis informa que la longitud promedio de las respuestas en AA-PersonalityBench varía unas 6 veces entre los modelos que midió: de 174 a unos 1.030 palabras para las mismas preguntas. Las cifras son propias del sitio.Artificial Analysis lanza VIALS-AA, una clasificación de razonamiento visual en ciencias de la vida en la que Gemini 4 Carbon lidera con un 64 %
Artificial Analysis ha lanzado VIALS-AA, una clasificación para el benchmark VIALS de Handshake AI. VIALS tiene 161 tareas en ocho dominios, en las que un modelo debe leer un elemento científico (transferencias Western blot, gráficos de citometría de flujo, mapas de plásmidos, filogenias) y extraer una conclusión específica.
El catálogo de OpenRouter cambia del 15 al 20 de noviembre la fecha de vencimiento de dos modelos Meta Llama 3.2
El catálogo de modelos de OpenRouter ahora muestra como fecha de vencimiento el 20 de noviembre de 2026 para Meta: Llama 3.2 3B Instruct (meta-llama/llama-3.2-3b-instruct, contexto de 131.072 tokens) y Meta: Llama 3.2 1B Instruct (meta-llama/llama-3.2-1b-instruct, 60.000 tokens). Hasta ahora, ambas entradas indicaban el 15 de noviembre de 2026. Este cambio solo afecta a un campo del catálogo: las entradas no explican por qué se modificó la fecha ni qué ocurrirá con los modelos después de esa fecha.OpenRouter lanza Auto Router y Auto Code, una nueva generación de enrutadores de modelos
OpenRouter presentó dos enrutadores de modelos: Auto Router, para preguntas y respuestas generales y agentes, y Auto Code, para agentes de programación. Afirma que muestra cómo se toma la decisión de enrutamiento para cada solicitud.
El catálogo de OpenRouter elimina la fecha de caducidad del 18 de noviembre de MoonshotAI: Kimi K2.5
El catálogo de modelos de OpenRouter ya no muestra una fecha de caducidad para MoonshotAI: Kimi K2.5 (moonshotai/kimi-k2.5, contexto de 262,144 tokens). El 6 de noviembre, la entrada indicaba el 18 de noviembre de 2026; ahora el campo está vacío. OpenRouter no ha dicho si la retirada se ha cancelado o solo se ha pospuesto.El catálogo de OpenRouter asigna a MoonshotAI: Kimi K2.5 una fecha de vencimiento del 18 de noviembre
El catálogo de modelos de OpenRouter ahora muestra el 18 de noviembre de 2026 como fecha de vencimiento de MoonshotAI: Kimi K2.5 (moonshotai/kimi-k2.5, contexto de 262.144 tokens), que figura en el catálogo desde enero de 2026. Antes, la entrada no tenía fecha de vencimiento. Se trata únicamente de un campo del catálogo; la entrada no indica por qué ni qué ocurrirá con el modelo después de esa fecha.OpenAI brings GPT-Image-2.6 Flare and Sunburst to the API and Codex
OpenAI released Images 2.6 on November 4 in ChatGPT, Codex and the API, available globally in ChatGPT and Codex on all subscription tiers. In the API it comes as two models, GPT-Image-2.6 Flare and Sunburst. OpenAI says both generate images 50% faster than before. Flare, at low quality, can produce an image in as little as six seconds and improves layout for posters and product imagery. At medium or high quality, Sunburst gives higher-quality images and keeps details more consistent from one edit to the next. ChatGPT Images 2.6 adds GIF output and reference images. OpenAI says people now create 4 billion images per week across ChatGPT, Codex and the API.Village: los modelos de pesos abiertos son la mejor opción en apenas el 3% de los presupuestos, frente al 41% en junio
Village, que publica LLM Atlas, informa que los modelos cerrados ahora ocupan casi todos los puntos de la frontera de precio-rendimiento. Según sus estimaciones, un modelo de pesos abiertos es el más potente en el 3% de los presupuestos, casi todos en el extremo más barato (Gemma 4 E4B de Google y MiMo-V2.6-Flash de Xiaomi). En junio, la proporción era del 41%, cuando DeepSeek V4 Flash por sí solo lideraba casi un tercio de los presupuestos. Village afirma que la proporción actual es la más baja que ha medido; al cierre de cada trimestre desde 2024 había sido de al menos el 6%.