 AI Tracker
Tin mô hình,
cho nhà phát triển.
Tin mới nhất về mô hình từ mọi nhà cung cấp AI: ra mắt, thay đổi giá và ngừng hỗ trợ, tóm tắt kèm ý nghĩa với bạn.
Danh mục của OpenRouter đã gỡ ngày hết hạn 31 tháng 12 khỏi Z.ai: GLM 4.7
Danh mục mô hình của OpenRouter hiện không còn hiển thị ngày hết hạn của Z.ai: GLM 4.7 (z-ai/glm-4.7, ngữ cảnh 204.800 token). Trước đây, mục này ghi ngày 31 tháng 12 năm 2026; hiện trường này để trống. OpenRouter chưa cho biết liệu việc ngừng cung cấp đã bị hủy hay chỉ được hoãn lại.Danh mục của OpenRouter xóa ngày hết hạn 20 tháng 11 khỏi Meta: Llama 3.2 3B Instruct
Danh mục mô hình của OpenRouter hiện không còn hiển thị ngày hết hạn cho Meta: Llama 3.2 3B Instruct (meta-llama/llama-3.2-3b-instruct, ngữ cảnh 131.072 token). Trước đây, mục này ghi ngày 20 tháng 11 năm 2026; hiện trường này đang để trống. OpenRouter chưa cho biết liệu việc ngừng cung cấp đã bị hủy hay chỉ được hoãn lại.Anthropic cho Claude giao dịch và điều khiển hạm đội trong EVE Online và EVE Frontier
Anthropic công bố “Project EVE”, nghiên cứu thuộc chương trình Fellows Program (tháng 4–7/2026), được thực hiện cùng Fenris Creations, trong đó Claude chơi hai trò chơi trong EVE Universe. Anthropic đưa ra các kết quả sau.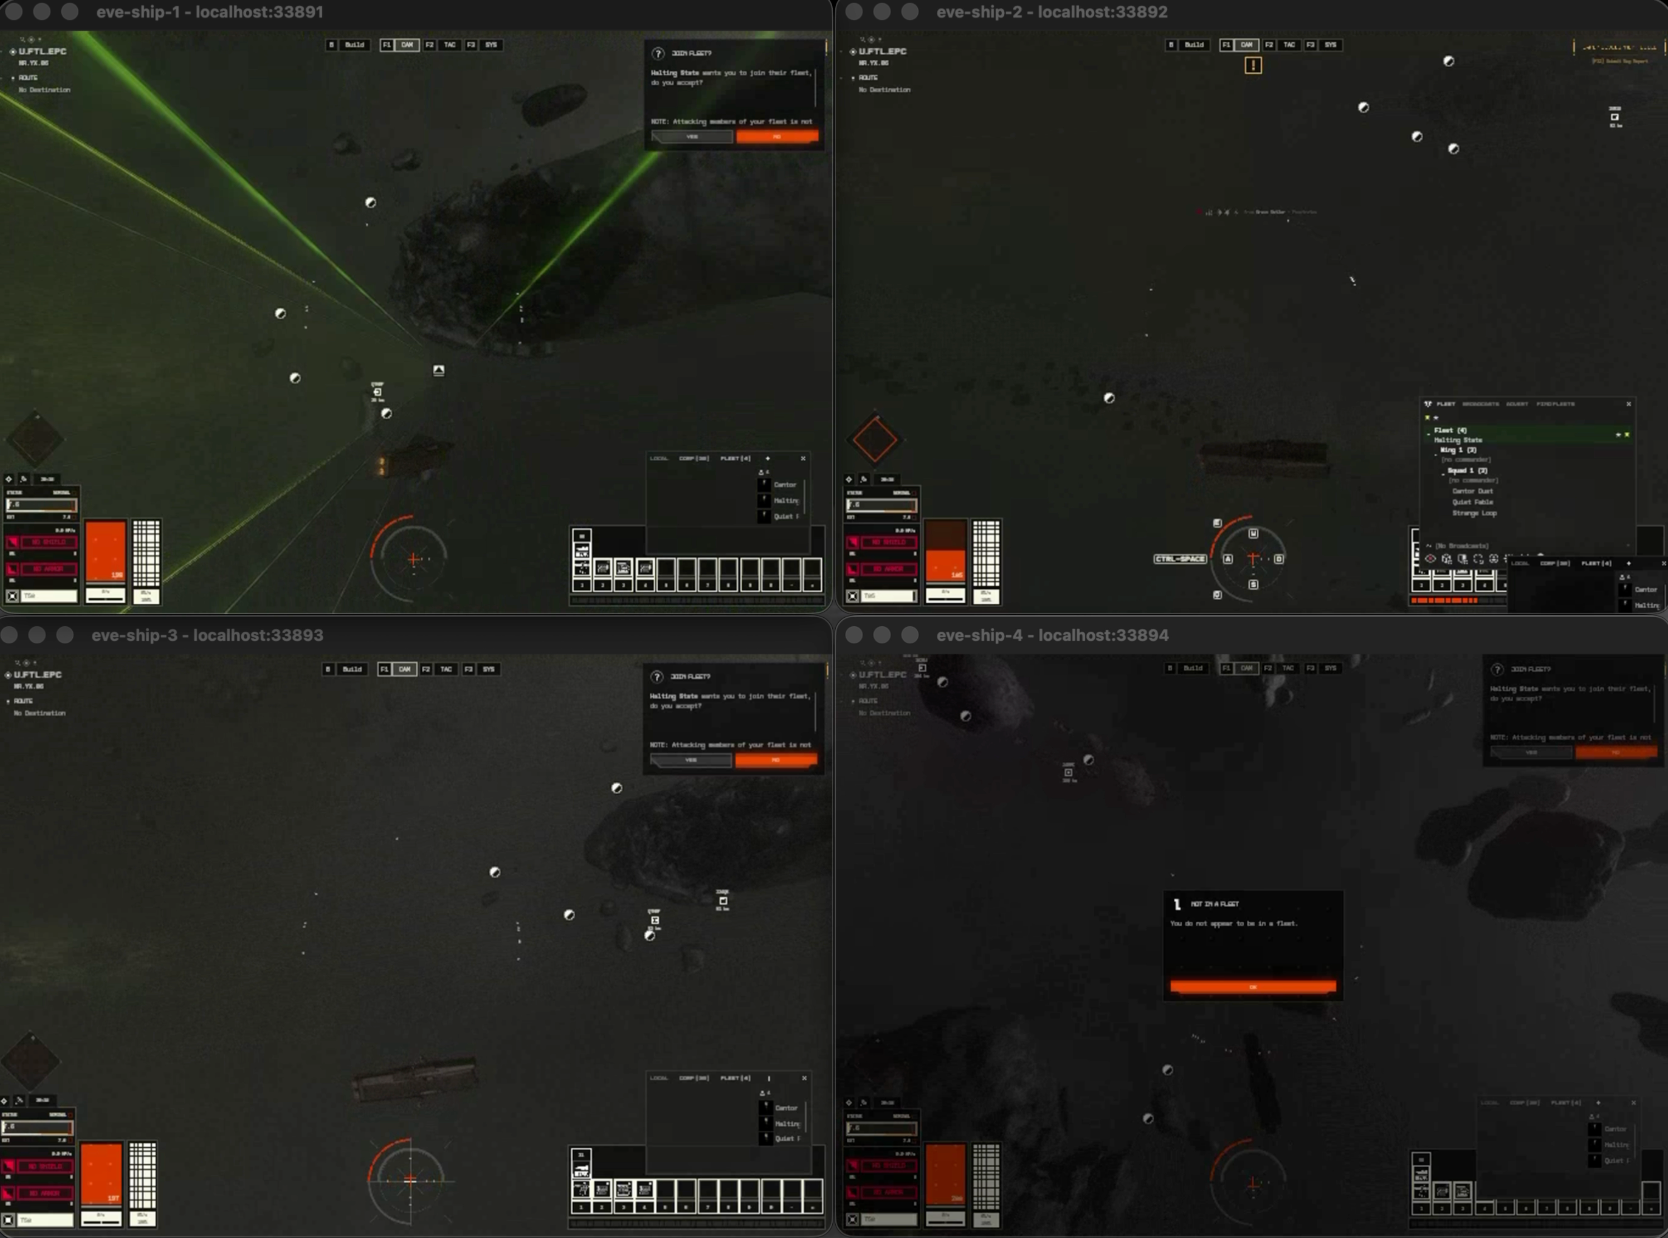
Artificial Analysis: Qwen-Audio-3.1-TTS-Plus dẫn đầu về chuyển văn bản thành giọng nói tiếng Anh Mỹ, HeyGen Voice dẫn đầu tiếng Anh Anh và bảng xếp hạng tổng thể
Artificial Analysis cho biết trong Controlled Voice Arena, nơi chấm điểm mọi mô hình chuyển văn bản thành giọng nói trên cùng tám giọng nói được nhân bản (bốn giọng Mỹ, bốn giọng Anh), Qwen-Audio-3.1-TTS-Plus dẫn đầu bảng xếp hạng tiếng Anh Mỹ, trong khi HeyGen Voice hoạt động tốt hơn với tiếng Anh Anh và dẫn đầu bảng xếp hạng tổng thể.Danh mục của OpenRouter ghi ngày hết hạn 13 tháng 11 cho LiquidAI: LFM2.5-2.6B
Danh mục mô hình của OpenRouter hiện ghi ngày hết hạn là 13 tháng 11 năm 2026 cho LiquidAI: LFM2.5-2.6B (liquid/lfm-2.5-2.6b, ngữ cảnh 128.000 token), được niêm yết từ tháng 8 năm 2026. Trước đây, mục này chưa có ngày hết hạn. Đây chỉ là một trường trong danh mục; mục này không cho biết lý do hay điều gì sẽ xảy ra với mô hình sau ngày đó.Nous Research ra mắt Arete-27B, Qwen3.8-27B được hậu huấn luyện để giảm tỷ lệ theo “đường lối của Đảng” từ 22% xuống 1%
Nous Research công bố Arete-27B trên X vào ngày 6 tháng 11. Đây là Qwen3.8-27B được hậu huấn luyện, theo lời phòng thí nghiệm, “để củng cố các giá trị phương Tây”. Nous cho rằng những mô hình mở mạnh nhất hiện nay là của Trung Quốc và được phát hành với hành vi phù hợp với định hướng của nhà nước đã tích hợp trong trọng số.Anthropic giải thích các thành phần của bộ nhớ tác tử và «mơ»
Ngày 6 tháng 11, Anthropic đăng bài viết «The components of agent memory», trình bày cách hãng nhìn nhận bộ nhớ dành cho các tác tử Claude và vai trò của «mơ». Anthropic định nghĩa bộ nhớ tác tử là những gì Claude học được qua trải nghiệm và lưu giữ giữa các phiên dưới dạng ghi chú có thể đọc lại sau này; thay đổi trọng số, học trong ngữ cảnh và nén không thuộc định nghĩa này. Hãng mô tả «mơ» là quá trình tác tử xem lại nhật ký và bản ghi hội thoại giữa các phiên để sửa lỗi, viết ghi chú mới và xây dựng các biểu diễn bộ nhớ mới.
OpenAI giới thiệu BioBasicsBench, bộ chuẩn đánh giá các tác vụ khoa học wet-lab thường ngày
OpenAI giới thiệu BioBasicsBench, bộ chuẩn đánh giá gồm 100 tác vụ wet-lab thường lệ, được xây dựng cùng Ligo, một công ty công nghệ sinh học tập trung vào thiết kế enzyme. Các tác vụ sử dụng bằng chứng thực nghiệm thô (ảnh gel, đĩa khuẩn lạc, ảnh hiển vi, tệp giải trình tự, dữ liệu xuất từ thiết bị và video thao tác trong phòng thí nghiệm) thuộc các lĩnh vực phương pháp nghiên cứu protein, chụp ảnh và đo tế bào, định lượng và xét nghiệm, phương pháp axit nucleic và nhân dòng phân tử. Các nhà khoa học xây dựng tác vụ dựa trên thí nghiệm của chính họ, còn câu trả lời được chấm theo bộ tiêu chí do chuyên gia soạn, có tính điểm một phần.Artificial Analysis: trên AA-PersonalityBench, Qwen3.8 27B viết câu trả lời dài nhất, còn GPT-6 Sol ngắn nhất
Artificial Analysis cho biết độ dài phản hồi trung bình trên AA-PersonalityBench chênh lệch khoảng 6 lần giữa các mô hình được đo, từ 174 đến khoảng 1.030 từ cho cùng một câu hỏi. Đây là số liệu do chính trang này đưa ra.Artificial Analysis ra mắt VIALS-AA, bảng xếp hạng suy luận hình ảnh trong khoa học sự sống, với Gemini 4 Carbon dẫn đầu ở mức 64%
Artificial Analysis đã ra mắt VIALS-AA, bảng xếp hạng dành cho benchmark VIALS của Handshake AI. VIALS gồm 161 tác vụ thuộc tám lĩnh vực, trong đó mô hình phải đọc một tư liệu khoa học (ảnh gel blot, biểu đồ đo tế bào dòng chảy, bản đồ plasmid, cây phát sinh chủng loại) và đưa ra một kết luận cụ thể.
Danh mục của OpenRouter dời ngày hết hạn của hai mô hình Meta Llama 3.2 từ ngày 15 tháng 11 sang ngày 20 tháng 11
Danh mục mô hình của OpenRouter hiện ghi ngày hết hạn là 20 tháng 11 năm 2026 cho Meta: Llama 3.2 3B Instruct (meta-llama/llama-3.2-3b-instruct, ngữ cảnh 131.072 token) và Meta: Llama 3.2 1B Instruct (meta-llama/llama-3.2-1b-instruct, 60.000 token). Cho đến nay, cả hai mục đều ghi ngày 15 tháng 11 năm 2026. Đây chỉ là trường thông tin trong danh mục; các mục này không cho biết lý do ngày được dời hoặc điều gì sẽ xảy ra với các mô hình sau ngày đó.OpenRouter ra mắt Auto Router và Auto Code, thế hệ bộ định tuyến mô hình mới
OpenRouter giới thiệu hai bộ định tuyến mô hình: Auto Router dành cho hỏi đáp tổng quát và agent, còn Auto Code dành cho agent lập trình. OpenRouter cho biết họ hiển thị cách đưa ra quyết định định tuyến cho từng yêu cầu.
Danh mục của OpenRouter bỏ ngày hết hạn 18 tháng 11 của MoonshotAI: Kimi K2.5
Danh mục mô hình của OpenRouter hiện không còn hiển thị ngày hết hạn của MoonshotAI: Kimi K2.5 (moonshotai/kimi-k2.5, ngữ cảnh 262.144 token). Trước đó, vào ngày 6 tháng 11, mục này ghi ngày 18 tháng 11 năm 2026; hiện trường này để trống. OpenRouter chưa cho biết việc ngừng cung cấp đã bị hủy hay chỉ được hoãn lại.Danh mục của OpenRouter ghi ngày hết hạn 18 tháng 11 cho MoonshotAI: Kimi K2.5
Danh mục mô hình của OpenRouter hiện hiển thị ngày hết hạn 18 tháng 11 năm 2026 cho MoonshotAI: Kimi K2.5 (moonshotai/kimi-k2.5, ngữ cảnh 262.144 token), vốn đã được liệt kê từ tháng 1 năm 2026. Trước đó, mục này không có ngày hết hạn. Đây chỉ là một trường trong danh mục; mục này không nêu lý do hoặc điều gì sẽ xảy ra với mô hình sau ngày đó.OpenAI brings GPT-Image-2.6 Flare and Sunburst to the API and Codex
OpenAI released Images 2.6 on November 4 in ChatGPT, Codex and the API, available globally in ChatGPT and Codex on all subscription tiers. In the API it comes as two models, GPT-Image-2.6 Flare and Sunburst. OpenAI says both generate images 50% faster than before. Flare, at low quality, can produce an image in as little as six seconds and improves layout for posters and product imagery. At medium or high quality, Sunburst gives higher-quality images and keeps details more consistent from one edit to the next. ChatGPT Images 2.6 adds GIF output and reference images. OpenAI says people now create 4 billion images per week across ChatGPT, Codex and the API.Village: các mô hình trọng số mở là lựa chọn đáng tiền nhất ở 3% ngân sách, giảm từ 41% hồi tháng 6
Village, đơn vị xuất bản LLM Atlas, cho biết hiện nay các mô hình đóng chiếm gần như mọi điểm trên đường biên hiệu năng/giá. Theo ước tính của tổ chức này, mô hình trọng số mở là lựa chọn mạnh nhất ở 3% ngân sách, gần như toàn bộ ở phân khúc giá rẻ (Gemma 4 E4B của Google và MiMo-V2.6-Flash của Xiaomi). Hồi tháng 6, tỷ lệ này là 41%, khi riêng DeepSeek V4 Flash dẫn đầu ở gần một phần ba mức ngân sách. Village cho biết tỷ lệ hiện nay là thấp nhất mà họ từng ghi nhận; vào cuối mỗi quý kể từ năm 2024, tỷ lệ này đều ở mức ít nhất 6%.