 AI Tracker
News zu Modelle,
für Entwickler.
Die neuesten News zu Modelle von allen AI-Anbietern: Launches, Preisänderungen und Abkündigungen, zusammengefasst mit dem, was sie für dich bedeuten.
OpenRouters Modellkatalog entfernt das Ablaufdatum am 31. Dezember für Z.ai: GLM 4.7
Im Modellkatalog von OpenRouter wird für Z.ai: GLM 4.7 (z-ai/glm-4.7, Kontext mit 204.800 Token) kein Ablaufdatum mehr angezeigt. Bislang war dort der 31. Dezember 2026 angegeben; das Feld ist jetzt leer. OpenRouter hat nicht mitgeteilt, ob die Einstellung des Modells abgesagt oder lediglich verschoben wurde.OpenRouters Katalog entfernt das Ablaufdatum am 20. November für Meta: Llama 3.2 3B Instruct
Im Modellkatalog von OpenRouter wird für Meta: Llama 3.2 3B Instruct (meta-llama/llama-3.2-3b-instruct, Kontextfenster mit 131.072 Tokens) kein Ablaufdatum mehr angezeigt. Bislang war dort der 20. November 2026 angegeben; nun ist das Feld leer. OpenRouter hat nicht mitgeteilt, ob die Einstellung des Modells abgesagt oder lediglich verschoben wurde.Anthropic lässt Claude in EVE Online handeln und in EVE Frontier Flotten befehligen
Anthropic hat „Project EVE“ veröffentlicht, eine im Rahmen des Fellows Program (April–Juli 2026) gemeinsam mit Fenris Creations durchgeführte Studie, in der Claude zwei Spiele im EVE-Universum spielte. Anthropic berichtet Folgendes.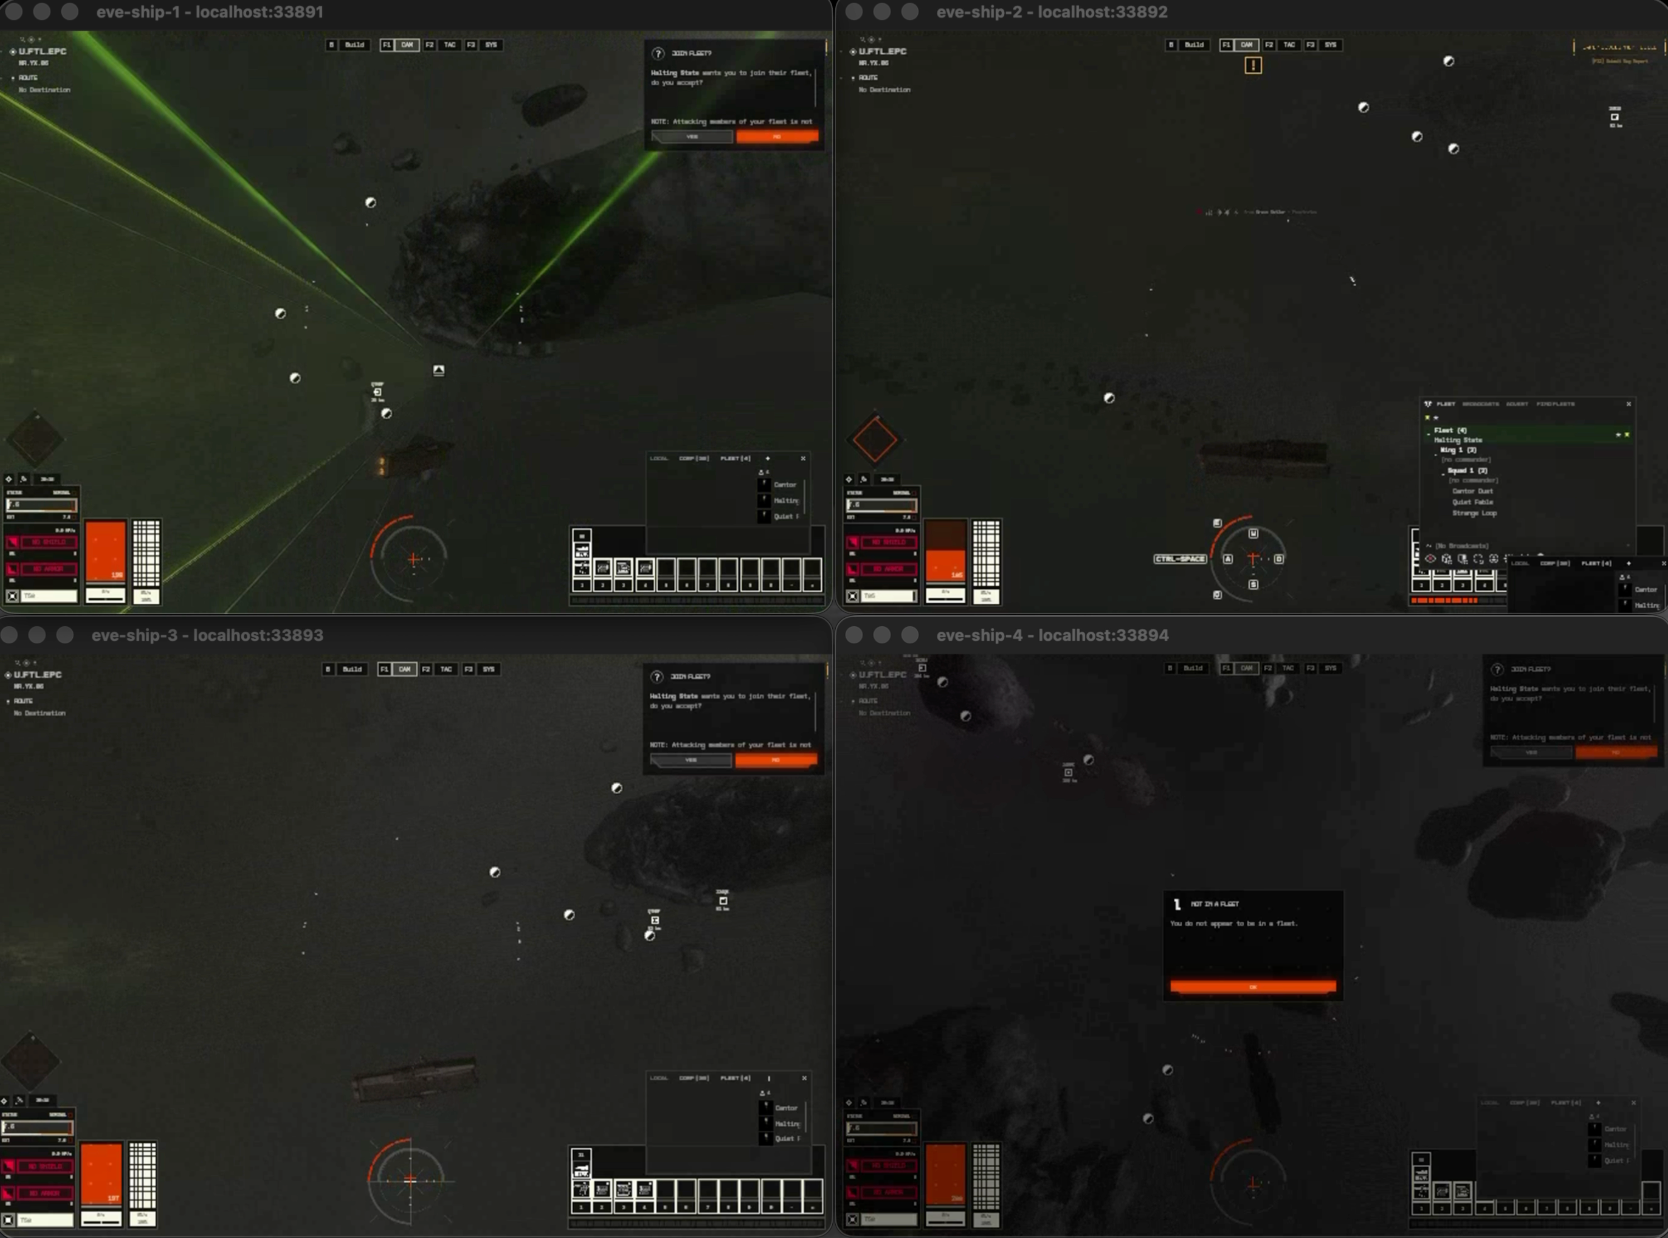
Artificial Analysis: Qwen-Audio-3.1-TTS-Plus führt bei US-englischer Sprachsynthese, HeyGen Voice bei britischem Englisch und insgesamt
Laut Artificial Analysis liegt Qwen-Audio-3.1-TTS-Plus in der Controlled Voice Arena bei US-Englisch vorn. Dort werden alle Text-to-Speech-Modelle mit denselben acht geklonten Stimmen bewertet (vier US-amerikanische, vier britische). Bei britischem Englisch schneidet HeyGen Voice besser ab und führt die Gesamtwertung an.Im Katalog von OpenRouter ist für LiquidAI: LFM2.5-2.6B der 13. November als Ablaufdatum angegeben
Der Modellkatalog von OpenRouter zeigt für LiquidAI: LFM2.5-2.6B (liquid/lfm-2.5-2.6b, Kontext mit 128.000 Tokens) nun den 13. November 2026 als Ablaufdatum an. Das Modell ist seit August 2026 gelistet. Zuvor war für den Eintrag kein Ablaufdatum angegeben. Es handelt sich lediglich um ein Katalogfeld; aus dem Eintrag geht weder hervor, warum dieses Datum angegeben ist, noch was danach mit dem Modell geschieht.Nous Research veröffentlicht Arete-27B: Qwen3.8-27B, nachtrainiert, um die Quote für die „Parteilinie“ von 22 % auf 1 % zu senken
Nous Research kündigte Arete-27B am 6. November auf X an. Das Modell ist ein nachtrainiertes Qwen3.8-27B, das laut dem Labor „westliche Werte stärken“ soll. Nous argumentiert, dass die leistungsstärksten offenen Modelle aus China stammen und in ihren Gewichten ein mit der Staatslinie abgestimmtes Verhalten mitbringen.Anthropic erläutert die Bestandteile des Agentengedächtnisses und das „Träumen“
Anthropic veröffentlichte am 6. November einen Beitrag mit dem Titel „The components of agent memory“ darüber, wie das Unternehmen das Gedächtnis von Claude-Agenten versteht und wie „Träumen“ dabei hilft. Anthropic definiert Agentengedächtnis als das, was Claude aus Erfahrungen lernt und zwischen Sitzungen in Notizen festhält, die es später wieder lesen kann; Änderungen an Modellgewichten, In-Context-Learning und Komprimierung fallen nicht unter diese Definition. „Träumen“ beschreibt das Reflektieren des Agenten über seine Protokolle und Transkripte zwischen Sitzungen, um Fehler zu beheben, neue Notizen zu schreiben und neue Gedächtnisrepräsentationen aufzubauen.
OpenAI stellt BioBasicsBench vor, einen Benchmark für alltägliche Aufgaben in der Nasslaborforschung
OpenAI stellt BioBasicsBench vor, einen Benchmark mit 100 routinemäßigen Aufgaben im Nasslabor, der gemeinsam mit Ligo entwickelt wurde, einem auf Enzymdesign spezialisierten Biotech-Unternehmen. Die Aufgaben basieren auf unverarbeiteten experimentellen Daten (Gelbildern, Kolonieplatten, Mikroskopie, Sequenzierungsdateien, Geräteexporten und Videos von Laborarbeiten) und decken Proteinmethoden, Bildgebung und Zytometrie, Quantifizierung und Assays, Nukleinsäuremethoden sowie molekulares Klonieren ab. Wissenschaftler entwickelten sie auf Grundlage ihrer eigenen Experimente; die Antworten werden anhand von von Experten verfassten Bewertungsrastern beurteilt, die Teilpunkte vergeben.Artificial Analysis: Auf AA-PersonalityBench schreibt Qwen3.8 27B die längsten und GPT-6 Sol die kürzesten Antworten
Laut Artificial Analysis unterscheidet sich die durchschnittliche Antwortlänge auf AA-PersonalityBench bei den gemessenen Modellen um etwa den Faktor 6: Bei denselben Fragen reicht sie von 174 bis etwa 1.030 Wörtern. Die Zahlen stammen von der Website selbst.Artificial Analysis startet VIALS-AA, ein Leaderboard für visuelles Schlussfolgern in den Biowissenschaften, auf dem Gemini 4 Carbon mit 64 % führt
Artificial Analysis hat VIALS-AA gestartet, ein Leaderboard für Handshake AIs VIALS-Benchmark. VIALS umfasst 161 Aufgaben aus acht Bereichen. Dabei muss ein Modell ein wissenschaftliches Artefakt (Gel-Blots, Durchflusszytometrie-Diagramme, Plasmidkarten, Phylogenien) auswerten und eine konkrete Schlussfolgerung ziehen.
OpenRouters Katalog verschiebt das Ablaufdatum zweier Meta-Llama-3.2-Modelle vom 15. auf den 20. November
OpenRouters Modellkatalog zeigt nun für Meta: Llama 3.2 3B Instruct (meta-llama/llama-3.2-3b-instruct, Kontextfenster mit 131.072 Tokens) und Meta: Llama 3.2 1B Instruct (meta-llama/llama-3.2-1b-instruct, 60.000 Tokens) ein Ablaufdatum am 20. November 2026. Bislang war bei beiden Einträgen der 15. November 2026 angegeben. Es handelt sich lediglich um ein Katalogfeld; aus den Einträgen geht weder hervor, warum das Datum verschoben wurde, noch was danach mit den Modellen geschieht.OpenRouter startet Auto Router und Auto Code, eine neue Generation von Modell-Routern
OpenRouter hat zwei Modell-Router vorgestellt: Auto Router für allgemeine Fragen und Antworten sowie Agenten und Auto Code für Coding-Agenten. Laut OpenRouter wird für jede Anfrage angezeigt, wie die Routing-Entscheidung zustande kommt.
OpenRouters Katalog entfernt das Ablaufdatum am 18. November für MoonshotAI: Kimi K2.5
Im Modellkatalog von OpenRouter wird für MoonshotAI: Kimi K2.5 (moonshotai/kimi-k2.5, Kontext mit 262.144 Token) kein Ablaufdatum mehr angezeigt. Noch am 6. November war dort der 18. November 2026 angegeben; das Feld ist jetzt leer. OpenRouter hat nicht mitgeteilt, ob die Einstellung des Modells abgesagt oder lediglich verschoben wurde.Im Katalog von OpenRouter ist für MoonshotAI: Kimi K2.5 der 18. November als Ablaufdatum angegeben
Im Modellkatalog von OpenRouter ist für MoonshotAI: Kimi K2.5 (moonshotai/kimi-k2.5, Kontext mit 262.144 Tokens) jetzt der 18. November 2026 als Ablaufdatum angegeben. Das Modell ist seit Januar 2026 gelistet. Zuvor war für den Eintrag kein Ablaufdatum angegeben. Dabei handelt es sich lediglich um ein Katalogfeld; im Eintrag steht weder, warum das Datum festgelegt wurde, noch, was danach mit dem Modell geschieht.OpenAI brings GPT-Image-2.6 Flare and Sunburst to the API and Codex
OpenAI released Images 2.6 on November 4 in ChatGPT, Codex and the API, available globally in ChatGPT and Codex on all subscription tiers. In the API it comes as two models, GPT-Image-2.6 Flare and Sunburst. OpenAI says both generate images 50% faster than before. Flare, at low quality, can produce an image in as little as six seconds and improves layout for posters and product imagery. At medium or high quality, Sunburst gives higher-quality images and keeps details more consistent from one edit to the next. ChatGPT Images 2.6 adds GIF output and reference images. OpenAI says people now create 4 billion images per week across ChatGPT, Codex and the API.Village: Open-Weight-Modelle bieten bei 3 % der Budgets das beste Preis-Leistungs-Verhältnis, gegenüber 41 % im Juni
Village, Herausgeber des LLM Atlas, berichtet, dass geschlossene Modelle inzwischen fast jeden Punkt auf der Preis-Leistungs-Grenze besetzen. Schätzungen zufolge ist ein Open-Weight-Modell bei 3 % der Budgets das leistungsstärkste Modell – fast ausschließlich am günstigen Ende (Googles Gemma 4 E4B und Xiaomis MiMo-V2.6-Flash). Im Juni lag der Anteil bei 41 %, als DeepSeek V4 Flash allein bei fast einem Drittel der Budgets an der Spitze lag. Laut Village ist der heutige Anteil der niedrigste, den das Unternehmen bisher gemessen hat; zum Ende jedes Quartals seit 2024 lag er bei mindestens 6 %.