 AI Tracker
OpenRouter 的模型目錄移除了 Z.ai: GLM 4.7 的 12 月 31 日到期日
OpenRouter 的模型目錄不再顯示 Z.ai: GLM 4.7 的到期日(z-ai/glm-4.7,204,800-token context)。該項目原本標示到期日為 2026 年 12 月 31 日;目前此欄位已空白。OpenRouter 尚未說明退役是否取消或只是延期。OpenRouter 目錄移除 Meta: Llama 3.2 3B Instruct 的 11 月 20 日到期日
OpenRouter 的模型目錄不再顯示 Meta: Llama 3.2 3B Instruct(meta-llama/llama-3.2-3b-instruct,131,072-token context)的到期日。該項目先前標示為 2026 年 11 月 20 日;目前此欄位已空白。OpenRouter 尚未說明這代表停用計畫已取消,還是僅延後。Anthropic 讓 Claude 在 EVE Online 和 EVE Frontier 中進行交易並駕駛艦隊
Anthropic 發表了「Project EVE」,這是其 Fellows Program(2026 年 4 月至 7 月)與 Fenris Creations 合作完成的研究;Claude 在其中玩了 EVE Universe 的兩款遊戲。Anthropic 報告如下。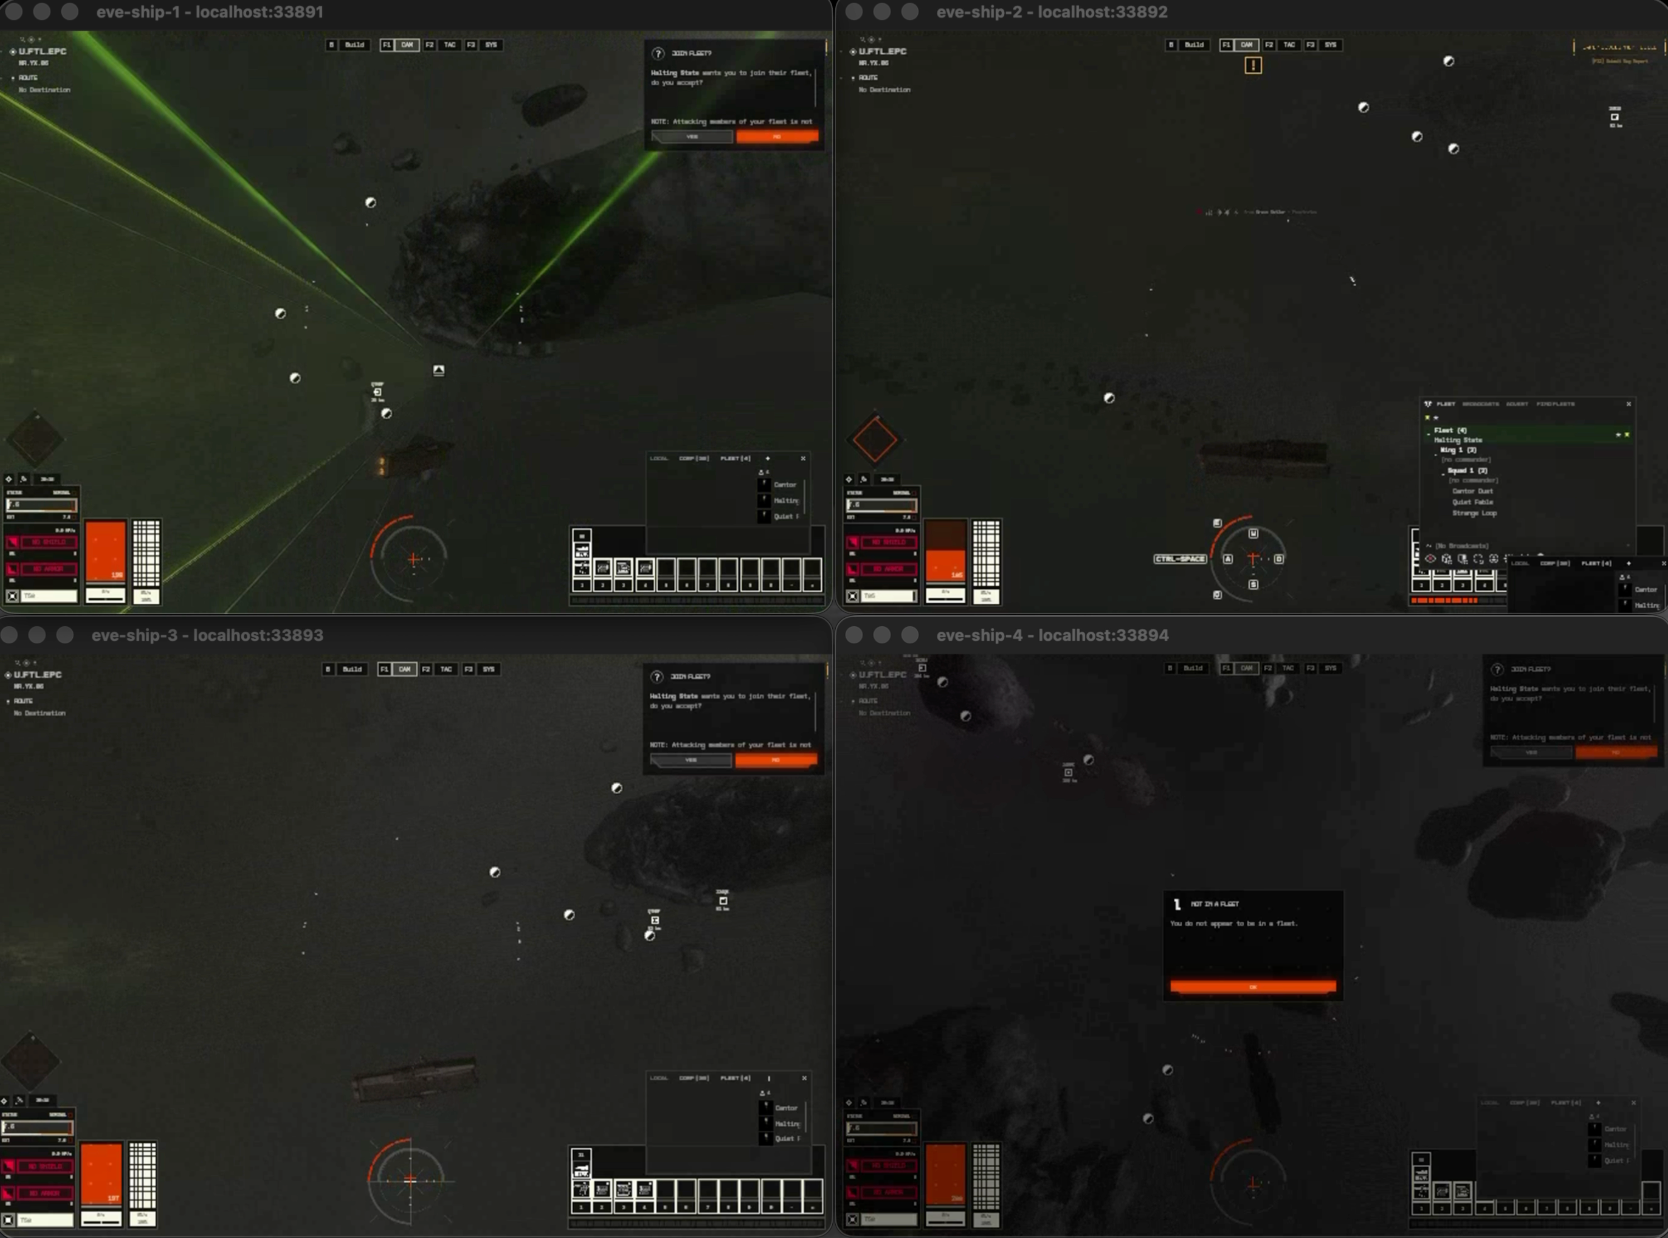
Artificial Analysis:Qwen-Audio-3.1-TTS-Plus 在美式英語文字轉語音中居首,HeyGen Voice 則在英式英語及整體排名中領先
Artificial Analysis 表示,在其 Controlled Voice Arena 中,所有文字轉語音模型都使用相同的八種克隆語音(四種美式、四種英式)進行評分。Qwen-Audio-3.1-TTS-Plus 在美式英語排名中居首,而 HeyGen Voice 在英式英語的表現更好,並在整體排行榜中領先。OpenRouter 的目錄為 LiquidAI: LFM2.5-2.6B 標示 11 月 13 日到期
OpenRouter 的模型目錄目前為 LiquidAI: LFM2.5-2.6B(liquid/lfm-2.5-2.6b,128,000-token context)標示到期日為 2026 年 11 月 13 日。該模型自 2026 年 8 月起列入目錄,此前沒有標示到期日。這只是目錄中的欄位;該項目並未說明原因,也未說明該日期之後模型會如何處置。Nous Research 推出 Arete-27B:經後訓練的 Qwen3.8-27B,將「黨的立場」回應率從 22% 降至 1%
Nous Research 於 11 月 6 日在 X 上宣布推出 Arete-27B。這款模型以 Qwen3.8-27B 為基礎進行後訓練,依該實驗室的說法,目的是「強化西方價值觀」。Nous 認為,最強大的開放模型來自中國,且其權重中帶有與國家立場一致的行為傾向。Anthropic 說明代理記憶與「夢境」的組成
Anthropic 於 11 月 6 日發布文章〈代理記憶的組成〉,說明它如何看待 Claude 代理的記憶,以及「夢境」如何發揮作用。Anthropic 將代理記憶定義為 Claude 從經驗中學到、並在工作階段之間保留下來、供日後讀取的筆記;權重變更、上下文學習和壓縮則不在此定義範圍內。Anthropic 描述的夢境,是代理在工作階段之間回顧記錄和逐字稿,以修正錯誤、撰寫新筆記並建立新的記憶表徵。
OpenAI 推出 BioBasicsBench,評測日常濕實驗科學任務的基準
OpenAI 與專注於酵素設計的生技公司 Ligo 合作,推出 BioBasicsBench。這項基準涵蓋 100 項常規濕實驗任務,使用原始實驗證據(凝膠影像、菌落培養皿、顯微影像、定序檔案、儀器匯出資料和實驗桌操作影片),涵蓋蛋白質方法、成像與流式細胞分析、定量與分析測定、核酸方法,以及分子選殖。這些任務由科學家根據自己的實驗撰寫,並依照專家編寫、可給予部分分數的評分規準評分。Artificial Analysis:在 AA-PersonalityBench 中,Qwen3.8 27B 的回答最長,GPT-6 Sol 最短
Artificial Analysis 報告指出,在 AA-PersonalityBench 中,受測模型的平均回答長度相差約 6 倍;針對相同問題,回答長度從 174 字到約 1,030 字不等。這些數據來自該網站自身。Artificial Analysis 推出 VIALS-AA:生命科學視覺推理排行榜,Gemini 4 Carbon 以 64% 領先
Artificial Analysis 推出了 VIALS-AA,這是 Handshake AI 的 VIALS 基準測試排行榜。VIALS 包含八個領域的 161 項任務,模型必須讀取科學圖像資料(凝膠轉漬圖、流式細胞儀圖表、質體圖譜、系統發育樹),並得出特定結論。
OpenRouter 的模型目錄將兩款 Meta Llama 3.2 模型的到期日從 11 月 15 日延至 11 月 20 日
OpenRouter 的模型目錄目前顯示,Meta: Llama 3.2 3B Instruct(meta-llama/llama-3.2-3b-instruct,131,072-token context)和 Meta: Llama 3.2 1B Instruct(meta-llama/llama-3.2-1b-instruct,60,000 tokens)的到期日為 2026 年 11 月 20 日。直到現在,這兩個項目的日期都顯示為 2026 年 11 月 15 日。這只是目錄欄位的變更;項目並未說明日期為何調整,或模型屆時會如何處理。OpenRouter 推出新一代模型路由器 Auto Router 和 Auto Code
OpenRouter 推出兩款模型路由器:適用於一般問答和代理程式的 Auto Router,以及適用於程式設計代理程式的 Auto Code。OpenRouter 表示,系統會顯示每個請求的路由決策是如何做出的。
OpenRouter 的型錄移除了 MoonshotAI: Kimi K2.5 的 11 月 18 日到期日
OpenRouter 的模型型錄目前不再顯示 MoonshotAI: Kimi K2.5 的到期日(moonshotai/kimi-k2.5,262,144-token context)。11 月 6 日稍早,該項目標示的日期為 2026 年 11 月 18 日;現在該欄位已空白。OpenRouter 尚未說明這代表停用計畫取消,還是僅延後。OpenRouter 的模型目錄將 MoonshotAI: Kimi K2.5 的到期日列為 11 月 18 日
OpenRouter 的模型目錄現在將 MoonshotAI: Kimi K2.5(moonshotai/kimi-k2.5,262,144 個 token 的上下文長度)的到期日列為 2026 年 11 月 18 日;該模型自 2026 年 1 月起便已上架。此前,這個項目沒有列出到期日。這只是目錄欄位;該項目並未說明原因,也未說明模型在該日期之後會如何處理。OpenAI brings GPT-Image-2.6 Flare and Sunburst to the API and Codex
OpenAI released Images 2.6 on November 4 in ChatGPT, Codex and the API, available globally in ChatGPT and Codex on all subscription tiers. In the API it comes as two models, GPT-Image-2.6 Flare and Sunburst. OpenAI says both generate images 50% faster than before. Flare, at low quality, can produce an image in as little as six seconds and improves layout for posters and product imagery. At medium or high quality, Sunburst gives higher-quality images and keeps details more consistent from one edit to the next. ChatGPT Images 2.6 adds GIF output and reference images. OpenAI says people now create 4 billion images per week across ChatGPT, Codex and the API.Village:開放權重模型僅占 3% 的預算,低於 6 月的 41%
發布 LLM Atlas 的 Village 報告指出,封閉模型如今幾乎占據價格效能前沿的所有位置。根據其估算,開放權重模型在 3% 的預算範圍內是能力最強的模型,且幾乎全都落在低價端(Google 的 Gemma 4 E4B 和 Xiaomi 的 MiMo-V2.6-Flash)。6 月時這個占比為 41%,當時僅 DeepSeek V4 Flash 就在近三分之一的預算範圍內領先。Village 表示,這是它測得的最低占比;自 2024 年以來,每季末的占比都至少有 6%。