 AI Tracker
Modelli: le notizie,
per chi sviluppa.
Le ultime notizie su modelli da ogni provider AI: lanci, cambi di prezzo e dismissioni, riassunti con cosa significano per te.
Il catalogo di OpenRouter rimuove la data di scadenza del 31 dicembre per Z.ai: GLM 4.7
Il catalogo dei modelli di OpenRouter non mostra più una data di scadenza per Z.ai: GLM 4.7 (z-ai/glm-4.7, contesto di 204.800 token). Fino a oggi, la voce riportava il 31 dicembre 2026; ora il campo è vuoto. OpenRouter non ha chiarito se il ritiro sia stato annullato o soltanto rinviato.Il catalogo di OpenRouter rimuove la data di scadenza del 20 novembre per Meta: Llama 3.2 3B Instruct
Il catalogo dei modelli di OpenRouter non mostra più una data di scadenza per Meta: Llama 3.2 3B Instruct (meta-llama/llama-3.2-3b-instruct, contesto da 131.072 token). Finora la scheda riportava il 20 novembre 2026; ora il campo è vuoto. OpenRouter non ha dichiarato se il ritiro sia stato annullato o soltanto posticipato.Anthropic ha fatto fare trading e pilotare flotte a Claude in EVE Online ed EVE Frontier
Anthropic ha pubblicato «Project EVE», una ricerca del suo Fellows Program (aprile–luglio 2026) realizzata con Fenris Creations, in cui Claude ha giocato a due giochi dell’universo di EVE. Anthropic riferisce quanto segue.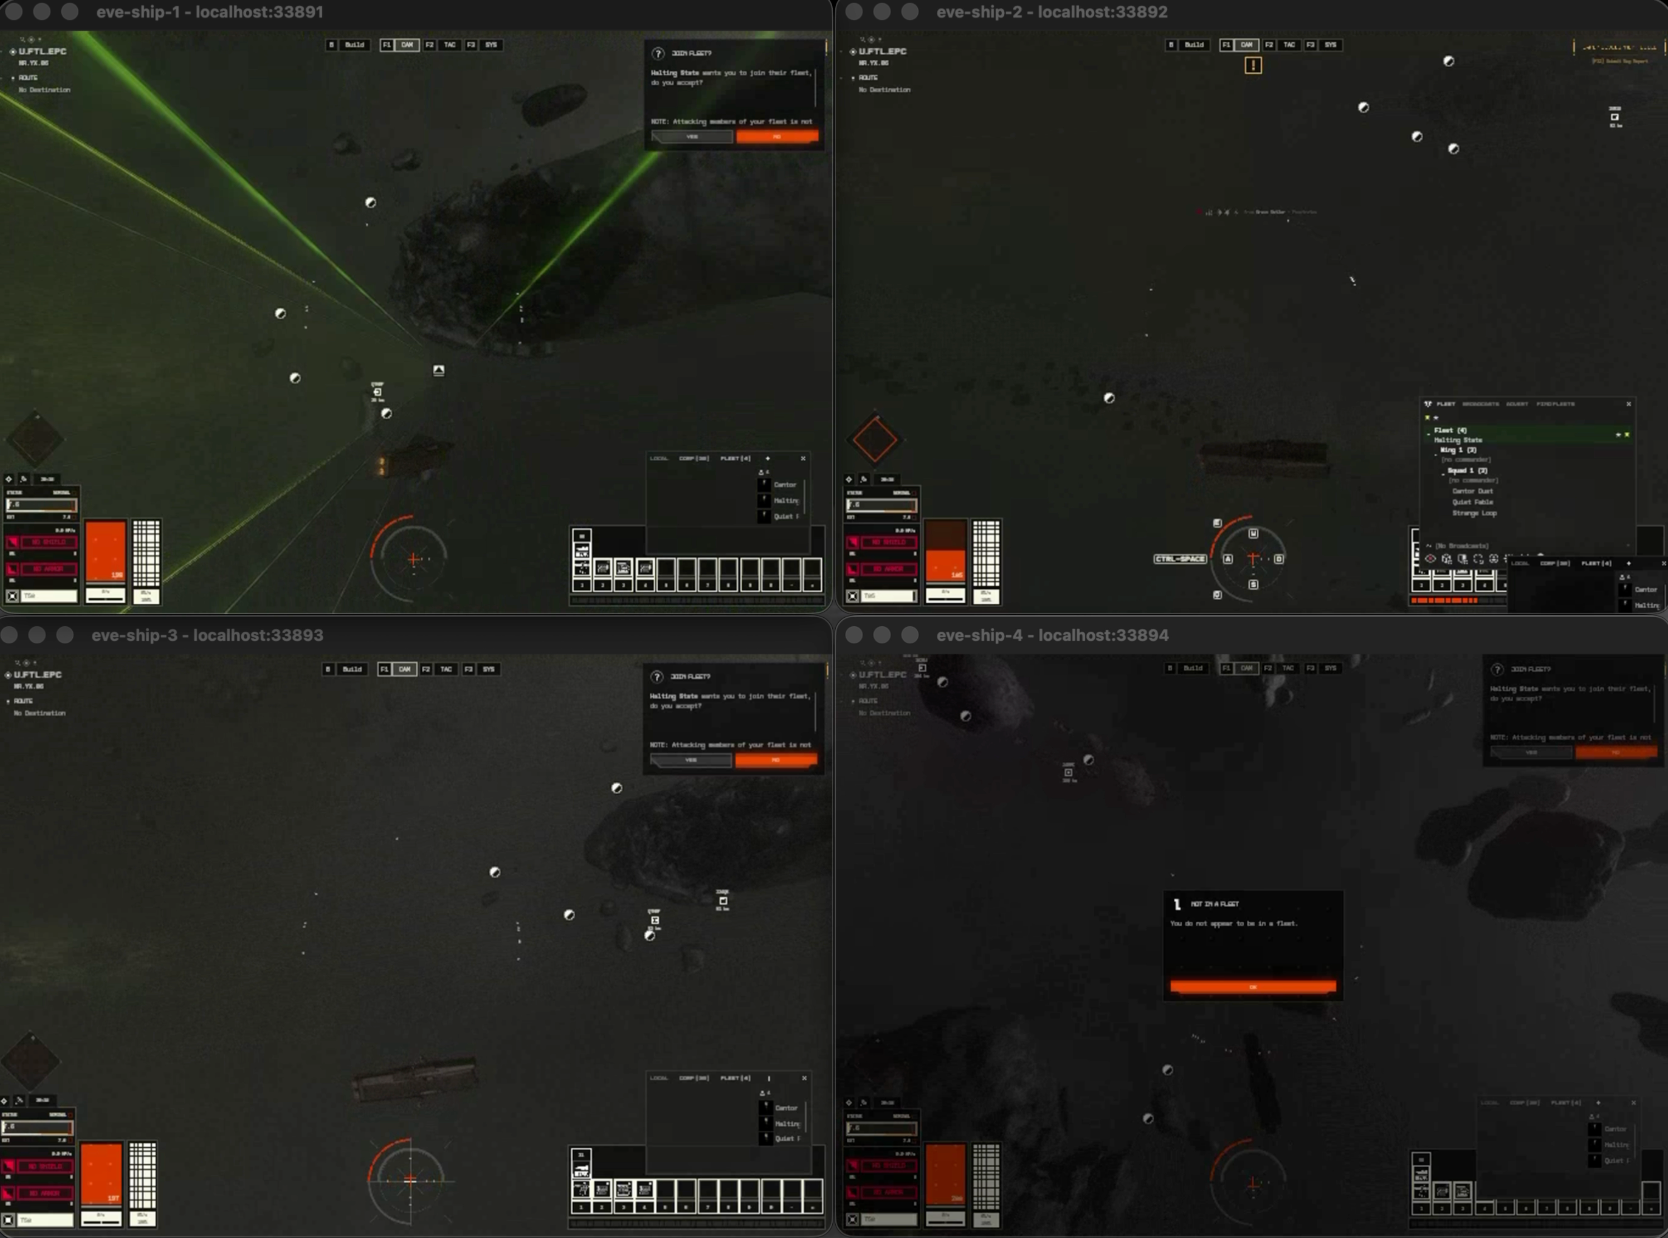
Artificial Analysis: Qwen-Audio-3.1-TTS-Plus è in testa nella sintesi vocale in inglese americano, HeyGen Voice in quella in inglese britannico e nella classifica generale
Artificial Analysis afferma che nella sua Controlled Voice Arena, che valuta ogni modello di sintesi vocale usando le stesse otto voci clonate (quattro americane e quattro britanniche), Qwen-Audio-3.1-TTS-Plus è in testa alla classifica dell’inglese americano, mentre HeyGen Voice ottiene risultati migliori in inglese britannico e guida la classifica generale.Il catalogo di OpenRouter indica il 13 novembre come data di scadenza per LiquidAI: LFM2.5-2.6B
Il catalogo dei modelli di OpenRouter mostra ora il 13 novembre 2026 come data di scadenza per LiquidAI: LFM2.5-2.6B (liquid/lfm-2.5-2.6b, contesto di 128.000 token), presente nel catalogo da agosto 2026. In precedenza la voce non riportava alcuna data di scadenza. Si tratta solo di un campo del catalogo: la voce non spiega il motivo né cosa accadrà al modello dopo quella data.Nous Research lancia Arete-27B, Qwen3.8-27B post-addestrato per ridurre il tasso di «allineamento alla linea del Partito» dal 22% all’1%
Nous Research ha annunciato Arete-27B su X il 6 novembre. Si tratta di Qwen3.8-27B post-addestrato, secondo le parole del laboratorio, «per rafforzare i valori occidentali». Nous sostiene che i più potenti modelli open siano cinesi e incorporino nei propri pesi comportamenti allineati allo Stato.Anthropic spiega i componenti della memoria degli agenti e il «dreaming»
Anthropic ha pubblicato il 6 novembre un post, «The components of agent memory», in cui spiega come concepisce la memoria per gli agenti Claude e in che modo il «dreaming» può essere d’aiuto. Anthropic definisce la memoria degli agenti come ciò che Claude apprende dall’esperienza e conserva tra una sessione e l’altra sotto forma di note che può rileggere in seguito; le modifiche ai pesi, l’apprendimento in contesto e la compattazione non rientrano in questa definizione. Descrive il dreaming come un processo in cui, tra una sessione e l’altra, l’agente riflette sui propri log e sulle trascrizioni per correggere gli errori, scrivere nuove note e creare nuove rappresentazioni della memoria.
OpenAI presenta BioBasicsBench, un benchmark di attività scientifiche di routine in laboratorio umido
OpenAI presenta BioBasicsBench, un benchmark di 100 attività di routine in laboratorio umido, sviluppato con Ligo, un’azienda biotecnologica specializzata nella progettazione di enzimi. Le attività si basano su prove sperimentali grezze (immagini di gel, piastre con colonie, microscopia, file di sequenziamento, esportazioni degli strumenti e video del lavoro al banco) e riguardano metodi per le proteine, imaging e citometria, quantificazione e saggi, metodi per gli acidi nucleici e clonaggio molecolare. Gli scienziati le hanno ideate sulla base dei propri esperimenti; le risposte vengono valutate con rubriche redatte da esperti che assegnano anche punteggi parziali.Artificial Analysis: su AA-PersonalityBench, Qwen3.8 27B scrive le risposte più lunghe e GPT-6 Sol le più brevi
Secondo Artificial Analysis, la lunghezza media delle risposte su AA-PersonalityBench varia di circa 6 volte tra i modelli misurati: da 174 a circa 1.030 parole alle stesse domande. I dati sono elaborati dal sito.Artificial Analysis lancia VIALS-AA, una classifica di ragionamento visivo nelle scienze della vita in cui Gemini 4 Carbon è in testa con il 64%
Artificial Analysis ha lanciato VIALS-AA, una classifica basata sul benchmark VIALS di Handshake AI. VIALS comprende 161 attività in otto ambiti, in cui un modello deve leggere un artefatto scientifico (immagini di gel, grafici di citometria a flusso, mappe plasmidiche, filogenie) e trarne una conclusione specifica.
Il catalogo di OpenRouter sposta dal 15 al 20 novembre la scadenza di due modelli Meta Llama 3.2
Il catalogo dei modelli di OpenRouter indica ora il 20 novembre 2026 come data di scadenza per Meta: Llama 3.2 3B Instruct (meta-llama/llama-3.2-3b-instruct, contesto di 131.072 token) e Meta: Llama 3.2 1B Instruct (meta-llama/llama-3.2-1b-instruct, 60.000 token). Fino a oggi, entrambe le voci riportavano il 15 novembre 2026. Si tratta solo di un campo del catalogo: le voci non spiegano perché la data sia stata spostata né cosa accadrà ai modelli in seguito.OpenRouter lancia Auto Router e Auto Code, una nuova generazione di router per modelli
OpenRouter ha presentato due router per modelli: Auto Router, per domande e risposte generali e agenti, e Auto Code, per agenti di programmazione. L’azienda afferma che mostra come viene presa la decisione di instradamento per ogni richiesta.
Il catalogo di OpenRouter rimuove la data di scadenza del 18 novembre per MoonshotAI: Kimi K2.5
Il catalogo dei modelli di OpenRouter non mostra più una data di scadenza per MoonshotAI: Kimi K2.5 (moonshotai/kimi-k2.5, contesto di 262.144 token). In precedenza, il 6 novembre, la scheda indicava il 18 novembre 2026; ora il campo è vuoto. OpenRouter non ha dichiarato se il ritiro sia stato annullato o solo rinviato.Il catalogo di OpenRouter indica il 18 novembre come data di scadenza di MoonshotAI: Kimi K2.5
Il catalogo dei modelli di OpenRouter mostra ora il 18 novembre 2026 come data di scadenza per MoonshotAI: Kimi K2.5 (moonshotai/kimi-k2.5, contesto di 262.144 token), presente nel catalogo da gennaio 2026. In precedenza, la voce non riportava una data di scadenza. Si tratta solo di un campo del catalogo: la voce non specifica il motivo né cosa succederà al modello dopo tale data.OpenAI brings GPT-Image-2.6 Flare and Sunburst to the API and Codex
OpenAI released Images 2.6 on November 4 in ChatGPT, Codex and the API, available globally in ChatGPT and Codex on all subscription tiers. In the API it comes as two models, GPT-Image-2.6 Flare and Sunburst. OpenAI says both generate images 50% faster than before. Flare, at low quality, can produce an image in as little as six seconds and improves layout for posters and product imagery. At medium or high quality, Sunburst gives higher-quality images and keeps details more consistent from one edit to the next. ChatGPT Images 2.6 adds GIF output and reference images. OpenAI says people now create 4 billion images per week across ChatGPT, Codex and the API.Village: i modelli open-weight sono l’acquisto migliore per il 3% dei budget, in calo dal 41% di giugno
Village, che pubblica LLM Atlas, riferisce che i modelli closed occupano ormai quasi tutti i punti sulla frontiera prezzo-prestazioni. Secondo le sue stime, un modello open-weight è il più performante per il 3% dei budget, quasi tutti nella fascia più economica (Gemma 4 E4B di Google e MiMo-V2.6-Flash di Xiaomi). A giugno la quota era del 41%, quando DeepSeek V4 Flash da solo guidava quasi un terzo dei budget. Village afferma che la quota attuale è la più bassa mai rilevata; alla fine di ogni trimestre dal 2024 era stata almeno del 6%.