 AI Tracker
Modelos: as notícias,
para devs.
As últimas notícias de modelos de todos os provedores de IA: lançamentos, mudanças de preço e descontinuações, resumidos com o que significam para você.
Catálogo da OpenRouter remove a data de expiração de 31 de dezembro do Z.ai: GLM 4.7
O catálogo de modelos da OpenRouter não exibe mais uma data de expiração para o Z.ai: GLM 4.7 (z-ai/glm-4.7, contexto de 204.800 tokens). Até agora, a entrada indicava 31 de dezembro de 2026; o campo está vazio. A OpenRouter não informou se a descontinuação foi cancelada ou apenas adiada.Catálogo da OpenRouter remove a data de expiração de 20 de novembro de Meta: Llama 3.2 3B Instruct
O catálogo de modelos da OpenRouter não exibe mais uma data de expiração para Meta: Llama 3.2 3B Instruct (meta-llama/llama-3.2-3b-instruct, contexto de 131.072 tokens). Até agora, a entrada indicava 20 de novembro de 2026; o campo está vazio. A OpenRouter não informou se a desativação foi cancelada ou apenas adiada.Anthropic faz Claude negociar e pilotar frotas em EVE Online e EVE Frontier
A Anthropic publicou “Project EVE”, uma pesquisa do seu Fellows Program (abril a julho de 2026), realizada com a Fenris Creations, na qual Claude jogou dois jogos do universo EVE. A Anthropic relata o seguinte.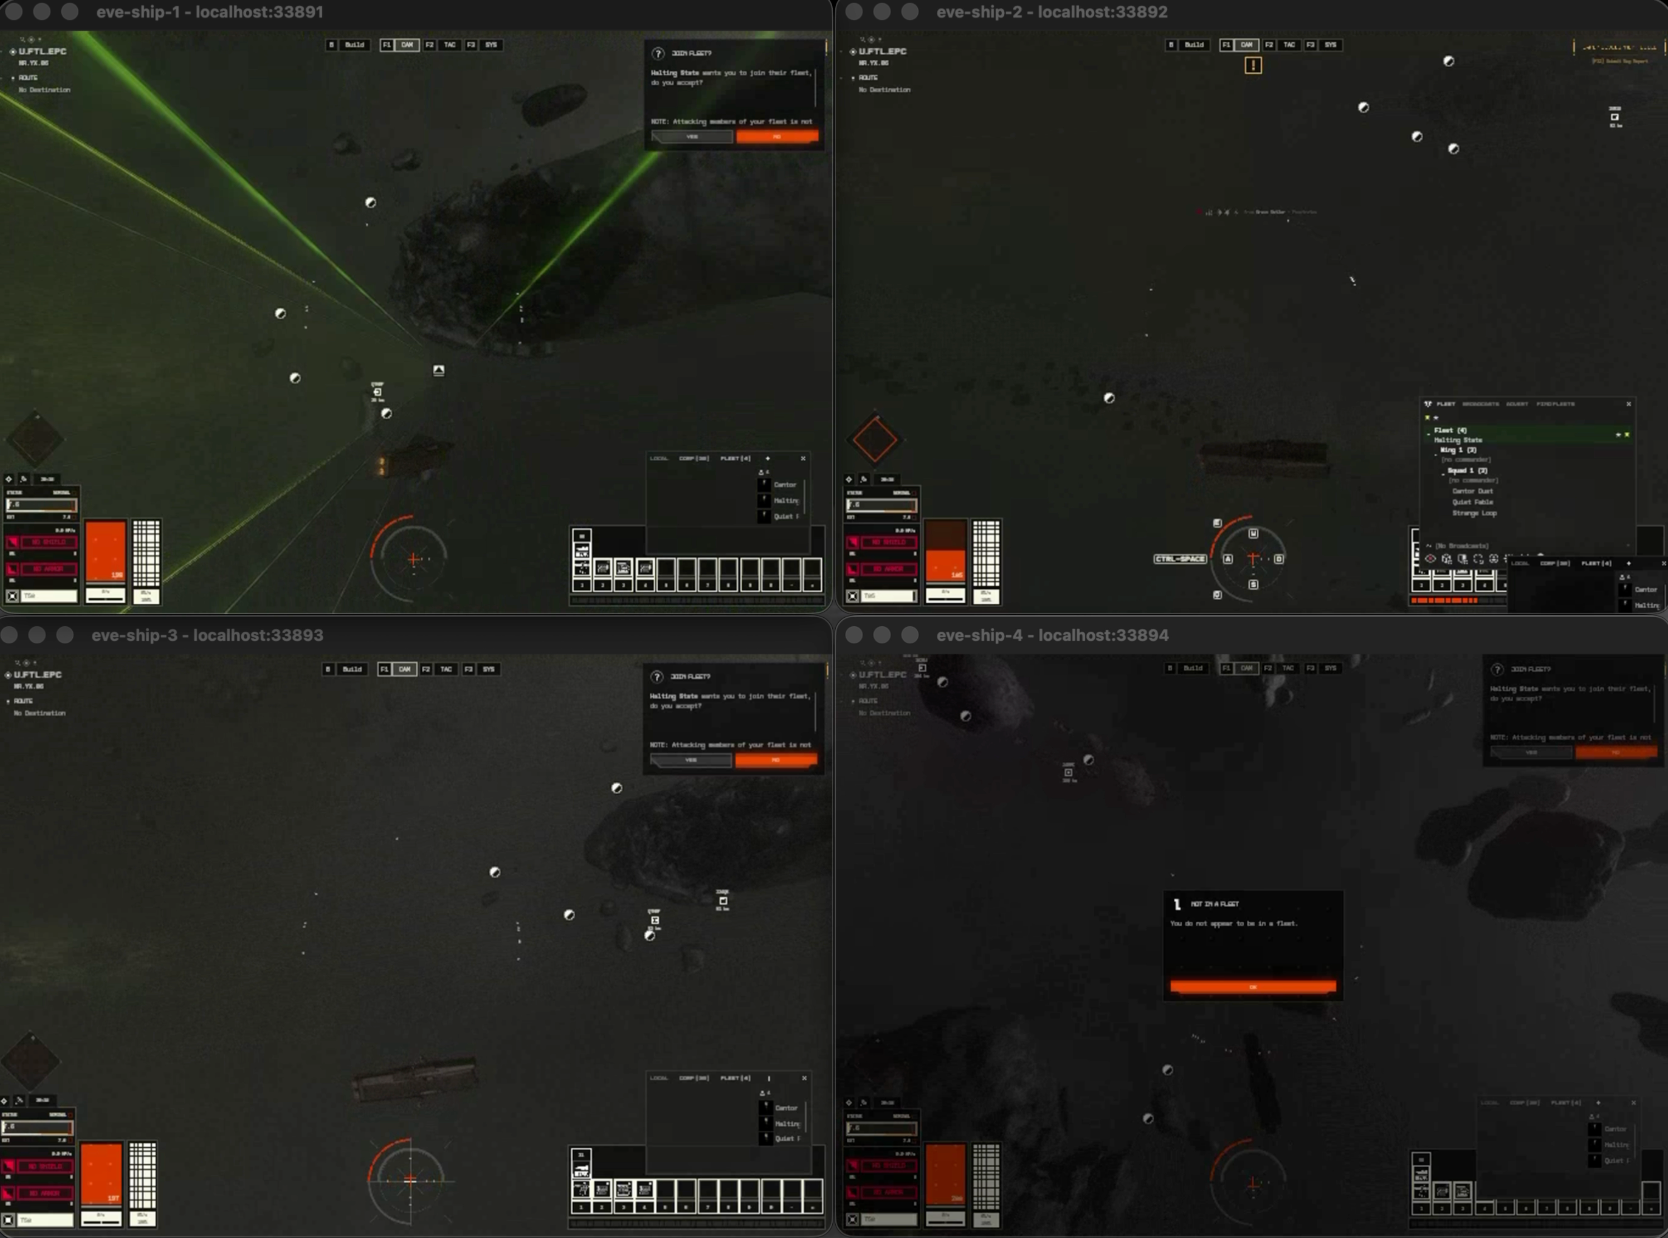
Artificial Analysis: Qwen-Audio-3.1-TTS-Plus lidera em síntese de fala em inglês dos EUA; HeyGen Voice lidera em inglês do Reino Unido e no geral
A Artificial Analysis afirma que, em sua Controlled Voice Arena, que avalia todos os modelos de síntese de fala usando as mesmas oito vozes clonadas (quatro dos EUA e quatro do Reino Unido), Qwen-Audio-3.1-TTS-Plus lidera o ranking de inglês dos EUA, enquanto HeyGen Voice tem desempenho melhor em inglês do Reino Unido e lidera o ranking geral.Catálogo da OpenRouter informa que LiquidAI: LFM2.5-2.6B tem data de expiração em 13 de novembro
O catálogo de modelos da OpenRouter agora mostra 13 de novembro de 2026 como data de expiração de LiquidAI: LFM2.5-2.6B (liquid/lfm-2.5-2.6b, contexto de 128.000 tokens), listado desde agosto de 2026. A entrada não tinha data de expiração anteriormente. Esse é apenas um campo do catálogo; a entrada não informa o motivo nem o que acontecerá com o modelo após essa data.Nous Research lança Arete-27B, Qwen3.8-27B pós-treinado para reduzir a taxa de « alinhamento com a linha do partido » de 22% para 1%
A Nous Research anunciou o Arete-27B no X em 6 de novembro. Trata-se de um Qwen3.8-27B pós-treinado, nas palavras do laboratório, « para reforçar os valores ocidentais ». A Nous argumenta que os modelos abertos mais fortes são chineses e vêm com comportamentos alinhados ao Estado incorporados em seus pesos.Anthropic explica os componentes da memória de agentes e o “sonhar”
Em 6 de novembro, a Anthropic publicou o texto “The components of agent memory”, sobre como entende a memória para agentes Claude e como o “sonhar” pode ajudar. A Anthropic define memória de agente como aquilo que Claude aprende com a experiência e conserva entre sessões em anotações que pode ler depois; mudanças nos pesos, aprendizado em contexto e compactação não fazem parte dessa definição. A empresa descreve o “sonhar” como o agente refletindo sobre seus registros e transcrições entre sessões para corrigir erros, escrever novas anotações e criar novas representações da memória.
OpenAI apresenta o BioBasicsBench, um benchmark de tarefas cotidianas de ciência em laboratório
OpenAI apresenta o BioBasicsBench, um benchmark de 100 tarefas rotineiras de laboratório desenvolvido com a Ligo, uma empresa de biotecnologia focada em design de enzimas. As tarefas usam evidências experimentais brutas (imagens de gel, placas de colônias, microscopia, arquivos de sequenciamento, exportações de instrumentos e vídeos de trabalho no laboratório) em métodos de proteínas, imagem e citometria, quantificação e ensaios, métodos de ácidos nucleicos e clonagem molecular. Cientistas criaram as tarefas com base em seus próprios experimentos, e as respostas são avaliadas segundo rubricas elaboradas por especialistas, que atribuem crédito parcial.Artificial Analysis: no AA-PersonalityBench, Qwen3.8 27B escreve as respostas mais longas, e GPT-6 Sol, as mais curtas
A Artificial Analysis informa que o tamanho médio das respostas no AA-PersonalityBench varia cerca de 6x entre os modelos avaliados: de 174 a cerca de 1.030 palavras para as mesmas perguntas. Os números são da própria plataforma.Artificial Analysis lança o VIALS-AA, um ranking de raciocínio visual em ciências da vida no qual Gemini 4 Carbon lidera com 64%
A Artificial Analysis lançou o VIALS-AA, um ranking para o benchmark VIALS da Handshake AI. O VIALS tem 161 tarefas em oito domínios, nas quais um modelo precisa ler um material científico (blots de gel, gráficos de citometria de fluxo, mapas de plasmídeos, filogenias) e chegar a uma conclusão específica.
O catálogo da OpenRouter adia de 15 para 20 de novembro o vencimento de dois modelos Meta Llama 3.2
O catálogo de modelos da OpenRouter agora exibe a data de vencimento de 20 de novembro de 2026 para Meta: Llama 3.2 3B Instruct (meta-llama/llama-3.2-3b-instruct, contexto de 131.072 tokens) e Meta: Llama 3.2 1B Instruct (meta-llama/llama-3.2-1b-instruct, 60.000 tokens). Até agora, as duas entradas indicavam 15 de novembro de 2026. Trata-se apenas de um campo do catálogo; as entradas não informam por que a data mudou nem o que acontecerá com os modelos depois dela.OpenRouter lança Auto Router e Auto Code, uma nova geração de roteadores de modelos
A OpenRouter apresentou dois roteadores de modelos: Auto Router, para perguntas e respostas gerais e agentes, e Auto Code, para agentes de programação. A empresa diz que mostra como a decisão de roteamento é tomada para cada solicitação.
Catálogo da OpenRouter remove a data de expiração de 18 de novembro do MoonshotAI: Kimi K2.5
O catálogo de modelos da OpenRouter não exibe mais uma data de expiração para MoonshotAI: Kimi K2.5 (moonshotai/kimi-k2.5, contexto de 262.144 tokens). Antes, em 6 de novembro, a entrada indicava 18 de novembro de 2026; agora, o campo está vazio. A OpenRouter não informou se a descontinuação foi cancelada ou apenas adiada.Catálogo da OpenRouter indica 18 de novembro como data de expiração do MoonshotAI: Kimi K2.5
O catálogo de modelos da OpenRouter agora mostra 18 de novembro de 2026 como data de expiração do MoonshotAI: Kimi K2.5 (moonshotai/kimi-k2.5, contexto de 262.144 tokens), listado desde janeiro de 2026. Antes, a entrada não tinha data de expiração. Esse é apenas um campo do catálogo; a entrada não informa o motivo nem o que acontecerá com o modelo após essa data.OpenAI brings GPT-Image-2.6 Flare and Sunburst to the API and Codex
OpenAI released Images 2.6 on November 4 in ChatGPT, Codex and the API, available globally in ChatGPT and Codex on all subscription tiers. In the API it comes as two models, GPT-Image-2.6 Flare and Sunburst. OpenAI says both generate images 50% faster than before. Flare, at low quality, can produce an image in as little as six seconds and improves layout for posters and product imagery. At medium or high quality, Sunburst gives higher-quality images and keeps details more consistent from one edit to the next. ChatGPT Images 2.6 adds GIF output and reference images. OpenAI says people now create 4 billion images per week across ChatGPT, Codex and the API.Village: modelos de pesos abertos são a melhor opção em apenas 3% dos orçamentos, ante 41% em junho
A Village, que publica o LLM Atlas, informa que os modelos fechados agora ocupam quase todos os pontos da fronteira de custo-benefício. Segundo suas estimativas, um modelo de pesos abertos é o mais forte em 3% dos orçamentos, quase todos na faixa mais barata (Gemma 4 E4B, do Google, e MiMo-V2.6-Flash, da Xiaomi). Em junho, essa fatia era de 41%, quando o DeepSeek V4 Flash, sozinho, liderava em quase um terço dos orçamentos. A Village diz que a fatia atual é a menor que já mediu; no fim de cada trimestre desde 2024, ela foi de pelo menos 6%.