 AI Tracker
モデルのニュースを、
開発者向けに。
各 AI プロバイダーのモデルに関する最新ニュース。リリース、価格改定、提供終了を、あなたへの影響とともに要約します。
OpenRouterのカタログでZ.ai: GLM 4.7の12月31日の有効期限が削除
OpenRouterのモデルカタログで、Z.ai: GLM 4.7(z-ai/glm-4.7、コンテキスト長204,800トークン)の有効期限が表示されなくなった。これまでは2026年12月31日と記載されていたが、現在は空欄になっている。OpenRouterは、提供終了が取り消されたのか、延期されただけなのかについて発表していない。OpenRouterのカタログからMeta: Llama 3.2 3B Instructの11月20日の提供終了日が削除
OpenRouterのモデルカタログで、Meta: Llama 3.2 3B Instruct(meta-llama/llama-3.2-3b-instruct、コンテキスト長131,072トークン)の提供終了日が表示されなくなりました。これまでは2026年11月20日と記載されていましたが、現在は欄が空白です。OpenRouterは、提供終了が中止されたのか、延期されただけなのかを明らかにしていません。Anthropic、EVE Onlineで取引し、EVE Frontierで艦隊を飛ばすClaudeを実現
Anthropicは、Fenris Creationsと共同で実施したFellows Program(2026年4月~7月)の研究「Project EVE」を公開しました。ClaudeがEVE Universeの2つのゲームをプレイした研究です。Anthropicの報告は以下のとおりです。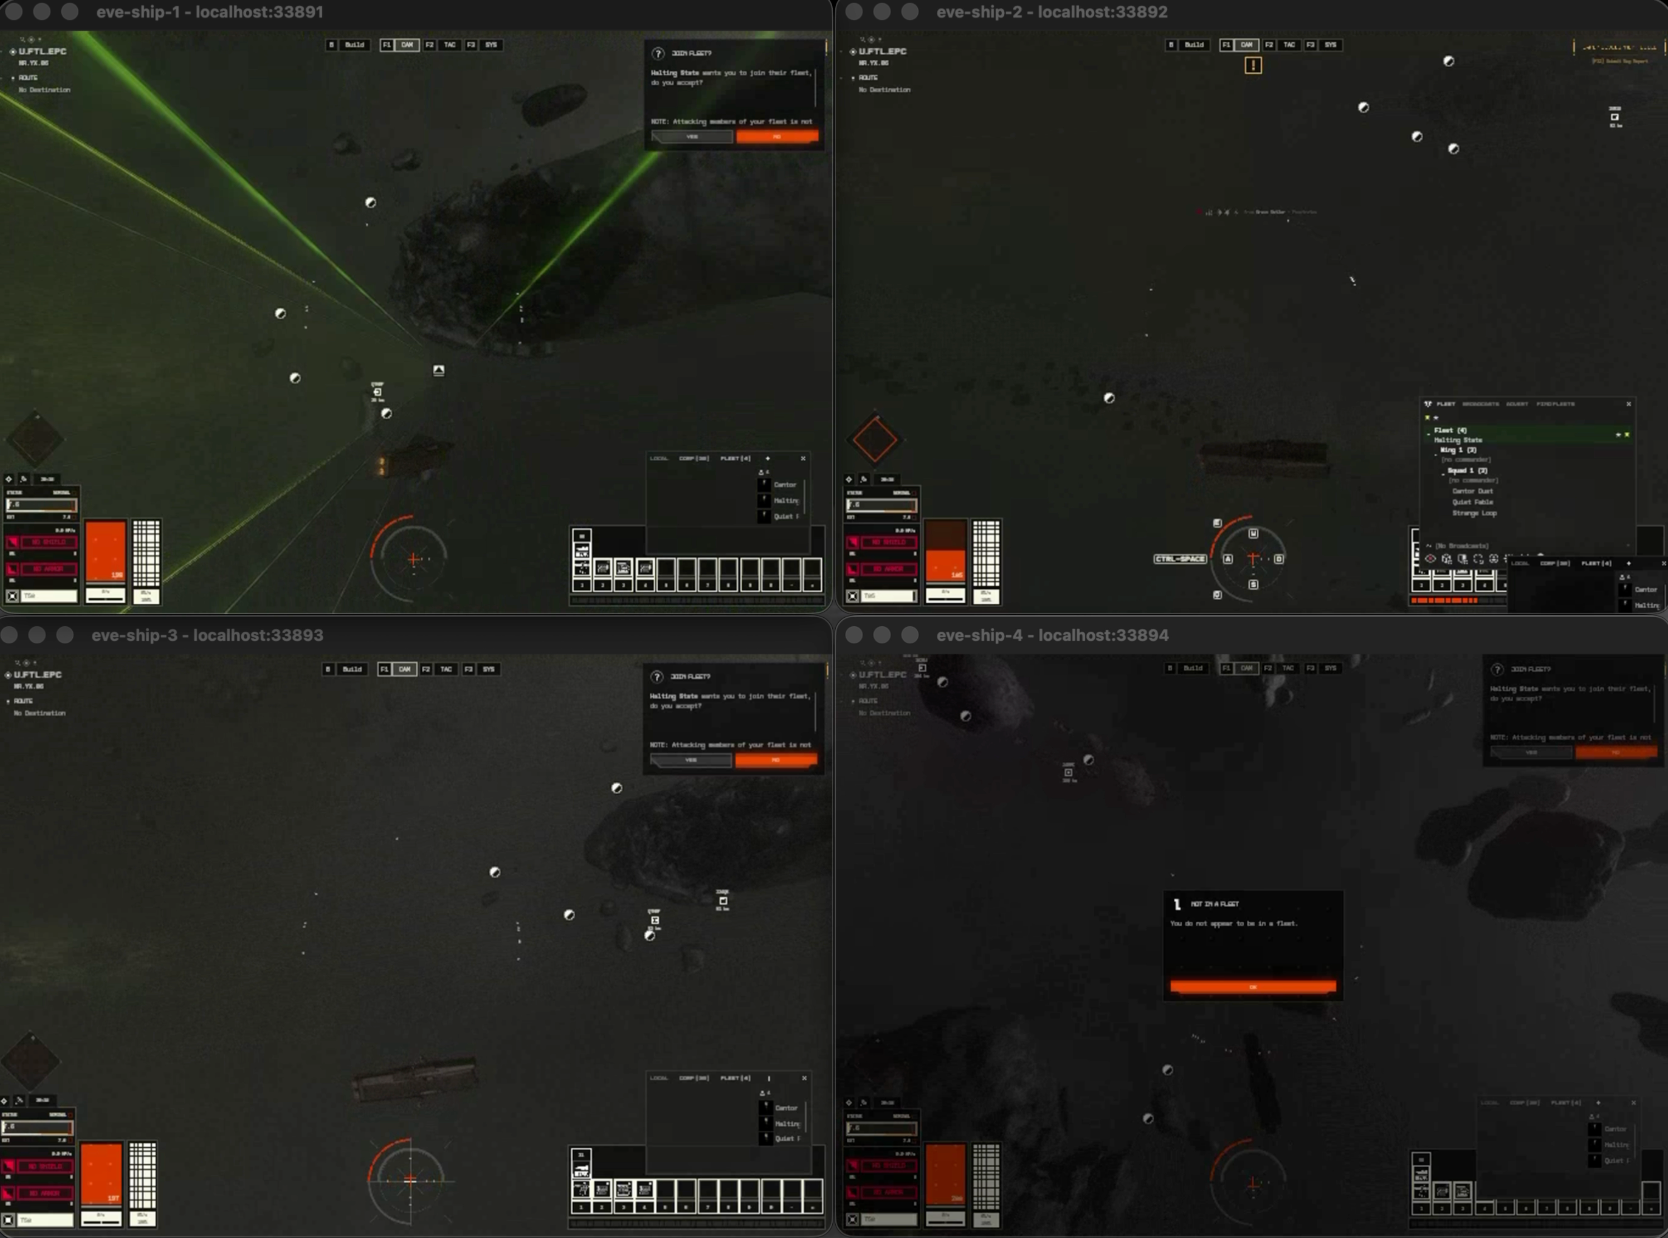
Artificial Analysis:Qwen-Audio-3.1-TTS-Plusは米国英語の音声合成で首位、英国英語と総合ではHeyGen Voiceが首位
Artificial Analysisによると、同社のControlled Voice Arenaでは、すべてのテキスト読み上げモデルを同じ8種類のクローン音声(米国英語4種類、英国英語4種類)で評価しています。Qwen-Audio-3.1-TTS-Plusは米国英語ランキングで首位となり、英国英語ではHeyGen Voiceの成績がより高く、総合ランキングでも首位です。OpenRouterのカタログで、LiquidAI: LFM2.5-2.6Bに11月13日の終了日が設定
OpenRouterのモデルカタログに、LiquidAI: LFM2.5-2.6B(liquid/lfm-2.5-2.6b、コンテキスト長128,000トークン)の終了日として2026年11月13日が表示されるようになった。同モデルは2026年8月から掲載されている。以前、このエントリーに終了日は記載されていなかった。これはカタログ上の項目にすぎず、その理由や当日以降にモデルがどうなるかは記載されていない。Nous Research、Arete-27Bを公開。Qwen3.8-27Bを追加学習し、「党の方針」に沿う回答率を22%から1%に低減
Nous Researchは11月6日、XでArete-27Bを発表した。研究所の言葉を借りれば、これは「西洋の価値観を強化する」ために追加学習したQwen3.8-27Bだ。Nousは、最も性能の高いオープンモデルは中国製で、重みには国家の方針に沿った振る舞いが組み込まれていると主張している。Anthropic、エージェントのメモリの構成要素と「夢想」について説明
Anthropicは11月6日、「The components of agent memory(エージェントのメモリの構成要素)」と題する記事を公開し、Claudeエージェントのメモリをどのように捉えているか、また「夢想」がどう役立つかを説明した。Anthropicはエージェントのメモリを、Claudeが経験から学び、後で読み返せるメモとしてセッション間で保持するものと定義している。重みの変更、コンテキスト内学習、コンパクションはこの定義に含まれない。夢想とは、エージェントがセッション間にログやトランスクリプトを振り返り、間違いを修正し、新たなメモを書き、メモリの新しい表現を構築することだと説明している。
OpenAI、日常的なウェットラボ科学タスクのベンチマーク「BioBasicsBench」を発表
OpenAIは、酵素設計に注力するバイオテクノロジー企業Ligoと共同で作成した、日常的なウェットラボ作業100件のベンチマーク「BioBasicsBench」を発表しました。タスクでは、タンパク質手法、イメージングとサイトメトリー、定量とアッセイ、核酸手法、分子クローニングにわたる、未加工の実験データ(ゲル画像、コロニープレート、顕微鏡画像、シーケンスファイル、機器の出力データ、実験台での作業を撮影した動画)を使用します。科学者が自身の実験に基づいてタスクを作成し、専門家が作成した部分点付きの採点基準で回答を評価します。Artificial Analysis:AA-PersonalityBenchではQwen3.8 27Bが最も長く回答し、GPT-6 Solが最も短い
Artificial Analysisによると、AA-PersonalityBenchで測定対象となったモデルの平均回答長には約6倍の差があり、同じ質問に対して174語から約1,030語まで幅がある。数値は同サイト独自のもの。Artificial Analysis、ライフサイエンス分野の視覚推論を評価するVIALS-AAを公開 Gemini 4 Carbonが64%で首位
Artificial Analysisは、Handshake AIのVIALSベンチマークを対象とするリーダーボード「VIALS-AA」を公開しました。VIALSには8領域にわたる161のタスクがあり、モデルは科学的な資料(ゲルブロット、フローサイトメトリーのプロット、プラスミドマップ、系統樹など)を読み取り、具体的な結論を導く必要があります。
OpenRouterのカタログで、Meta Llama 3.2の2モデルの提供終了日が11月15日から11月20日に変更
OpenRouterのモデルカタログでは、Meta: Llama 3.2 3B Instruct(meta-llama/llama-3.2-3b-instruct、コンテキスト長131,072トークン)とMeta: Llama 3.2 1B Instruct(meta-llama/llama-3.2-1b-instruct、60,000トークン)の提供終了日が、2026年11月20日と表示されるようになりました。これまでは両方の項目に2026年11月15日と記載されていました。これはカタログ上の項目変更のみで、日付が変更された理由や、その後モデルがどうなるかは記載されていません。OpenRouter、新世代のモデルルーター「Auto Router」と「Auto Code」を発表
OpenRouterは、2つのモデルルーターを導入しました。一般的なQ&Aやエージェント向けのAuto Routerと、コーディングエージェント向けのAuto Codeです。リクエストごとにルーティングの判断がどのように行われたかを表示するとしています。
OpenRouterのカタログからMoonshotAI: Kimi K2.5の11月18日の提供終了日が削除
OpenRouterのモデルカタログで、MoonshotAI: Kimi K2.5(moonshotai/kimi-k2.5、コンテキスト長262,144トークン)の提供終了日が表示されなくなりました。11月6日時点では終了日が2026年11月18日と記載されていましたが、現在は空欄です。提供終了が取り消されたのか、延期されただけなのか、OpenRouterは明らかにしていません。OpenRouterのカタログで、MoonshotAI: Kimi K2.5に11月18日の有効期限が記載
OpenRouterのモデルカタログに、MoonshotAI: Kimi K2.5(moonshotai/kimi-k2.5、コンテキスト長262,144トークン)の有効期限として2026年11月18日が表示されるようになりました。同モデルは2026年1月から掲載されています。以前、この項目に有効期限はありませんでした。これはカタログ上の項目にすぎず、その理由や期日以降にモデルがどうなるかは記載されていません。OpenAI brings GPT-Image-2.6 Flare and Sunburst to the API and Codex
OpenAI released Images 2.6 on November 4 in ChatGPT, Codex and the API, available globally in ChatGPT and Codex on all subscription tiers. In the API it comes as two models, GPT-Image-2.6 Flare and Sunburst. OpenAI says both generate images 50% faster than before. Flare, at low quality, can produce an image in as little as six seconds and improves layout for posters and product imagery. At medium or high quality, Sunburst gives higher-quality images and keeps details more consistent from one edit to the next. ChatGPT Images 2.6 adds GIF output and reference images. OpenAI says people now create 4 billion images per week across ChatGPT, Codex and the API.Village:オープンウェイトモデルが予算の3%で最もお買い得に、6月の41%から低下
LLM Atlasを公開するVillageの報告によると、価格性能のフロンティアでは、現在ほぼすべての領域をクローズドモデルが占めている。Villageの推定では、オープンウェイトモデルが最強なのは予算の3%にとどまり、ほぼすべてが低価格帯(GoogleのGemma 4 E4BとXiaomiのMiMo-V2.6-Flash)だ。6月にはこの割合は41%で、DeepSeek V4 Flashだけで予算のほぼ3分の1を占めていた。Villageによれば、現在の割合は同社が測定してきた中で最低で、2024年以降、各四半期末の時点では少なくとも6%だった。