 AI Tracker
Berita Model,
untuk developer.
Berita Model terbaru dari setiap penyedia AI: peluncuran, perubahan harga, dan penghentian, diringkas beserta artinya bagi Anda.
Katalog OpenRouter menghapus tanggal kedaluwarsa 31 Desember dari Z.ai: GLM 4.7
Katalog model OpenRouter tidak lagi menampilkan tanggal kedaluwarsa untuk Z.ai: GLM 4.7 (z-ai/glm-4.7, konteks 204.800 token). Entri tersebut sebelumnya mencantumkan 31 Desember 2026; kini kolom itu kosong. OpenRouter belum mengatakan apakah penghentian model dibatalkan atau hanya ditunda.Katalog OpenRouter menghapus tanggal kedaluwarsa 20 November untuk Meta: Llama 3.2 3B Instruct
Katalog model OpenRouter kini tidak lagi menampilkan tanggal kedaluwarsa untuk Meta: Llama 3.2 3B Instruct (meta-llama/llama-3.2-3b-instruct, konteks 131.072 token). Sebelumnya, entri tersebut mencantumkan 20 November 2026; kini kolom itu kosong. OpenRouter belum menyampaikan apakah penghentiannya dibatalkan atau hanya ditunda.Anthropic menggunakan Claude untuk berdagang dan menerbangkan armada di EVE Online dan EVE Frontier
Anthropic menerbitkan “Project EVE”, riset dari Fellows Program mereka (April–Juli 2026) yang dilakukan bersama Fenris Creations, dengan Claude memainkan dua game di EVE Universe. Anthropic melaporkan hal-hal berikut.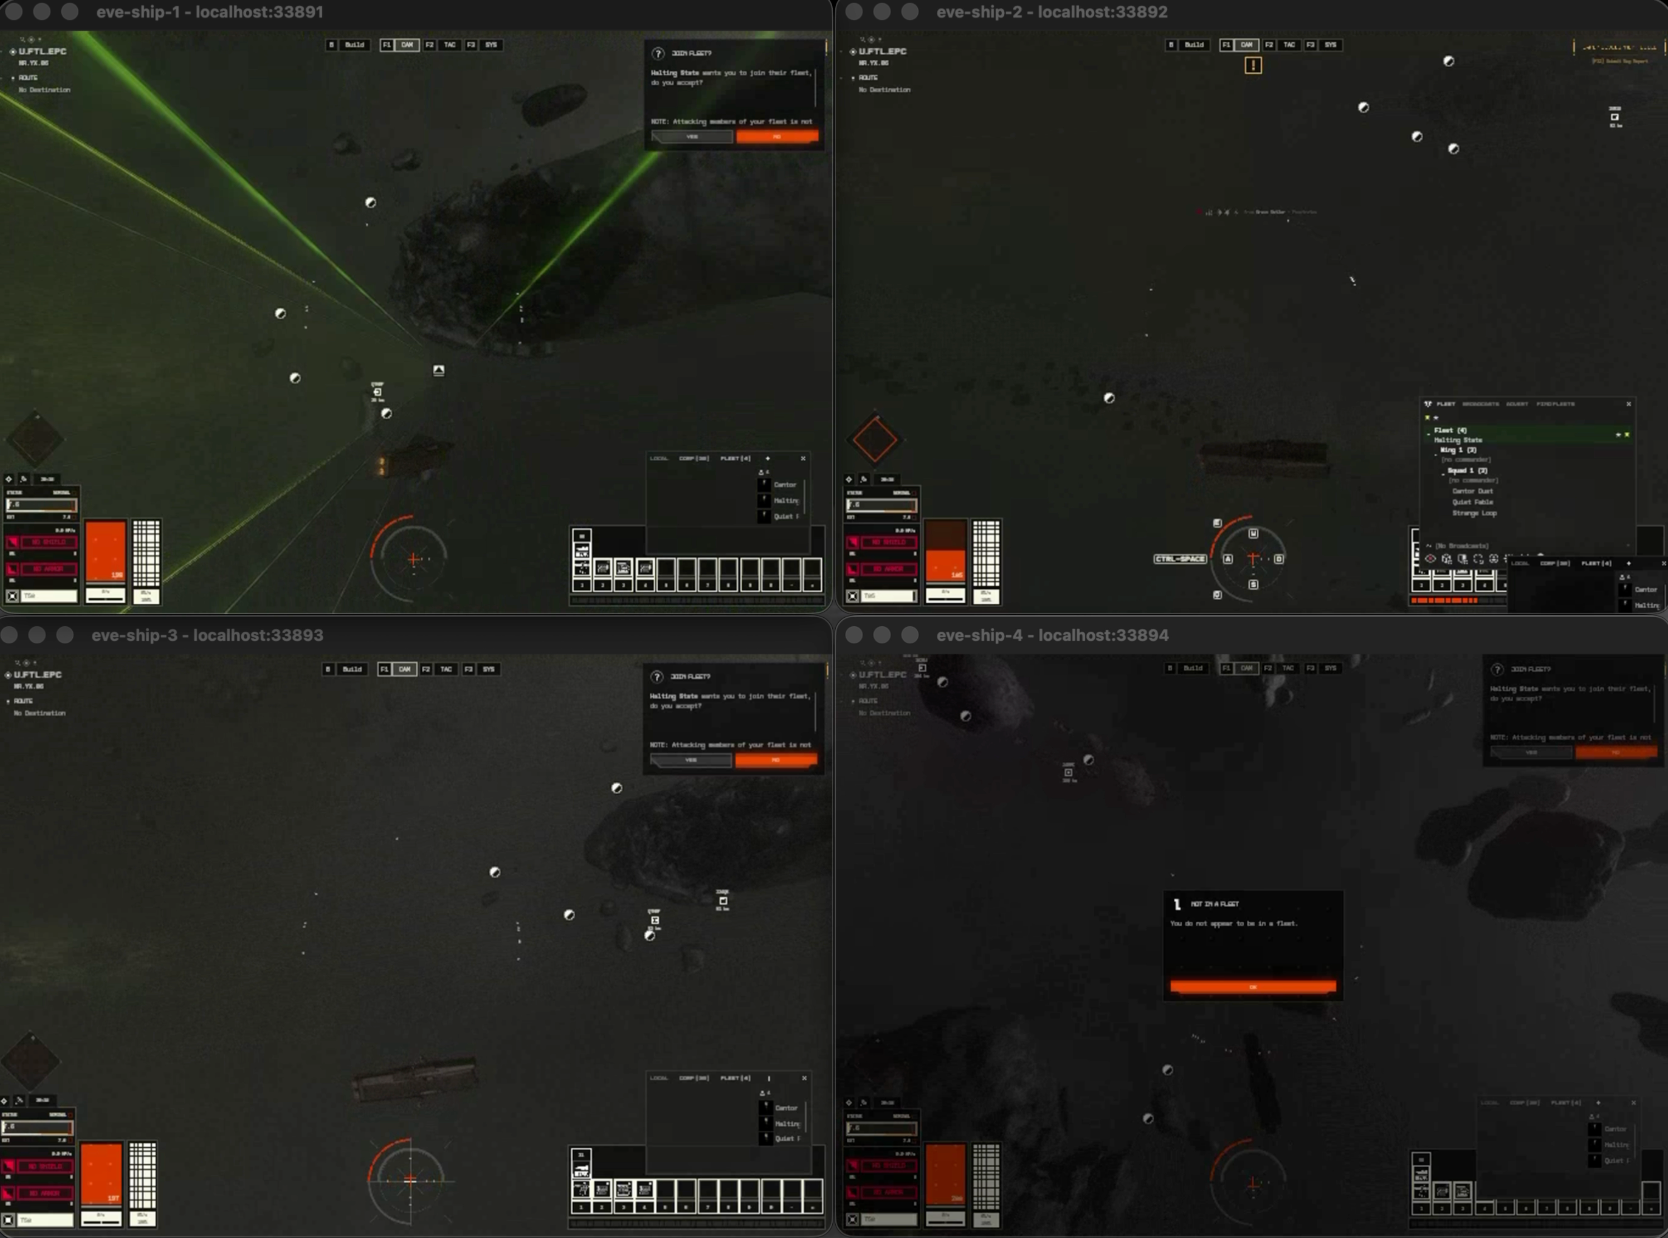
Artificial Analysis: Qwen-Audio-3.1-TTS-Plus memimpin untuk text-to-speech bahasa Inggris AS, HeyGen Voice memimpin untuk bahasa Inggris UK dan secara keseluruhan
Menurut Artificial Analysis, dalam Controlled Voice Arena, yang menilai setiap model text-to-speech menggunakan delapan suara tiruan yang sama (empat AS, empat UK), Qwen-Audio-3.1-TTS-Plus memimpin peringkat bahasa Inggris AS, sementara HeyGen Voice tampil lebih baik dalam bahasa Inggris UK dan memimpin papan peringkat keseluruhan.Katalog OpenRouter mencantumkan tanggal kedaluwarsa 13 November untuk LiquidAI: LFM2.5-2.6B
Katalog model OpenRouter kini menampilkan tanggal kedaluwarsa 13 November 2026 untuk LiquidAI: LFM2.5-2.6B (liquid/lfm-2.5-2.6b, konteks 128.000 token), yang tercantum sejak Agustus 2026. Sebelumnya, entri tersebut tidak memiliki tanggal kedaluwarsa. Ini hanya kolom dalam katalog; entri tersebut tidak menjelaskan alasannya atau apa yang akan terjadi pada model setelah tanggal itu.Nous Research merilis Arete-27B, Qwen3.8-27B yang dilatih pasca-prapelatihan untuk memangkas tingkat "garis partai" dari 22% menjadi 1%
Nous Research mengumumkan Arete-27B di X pada 6 November. Model ini adalah Qwen3.8-27B yang dilatih pasca-prapelatihan, menurut istilah lab tersebut, "untuk memperkuat nilai-nilai Barat". Nous berpendapat bahwa model terbuka terkuat berasal dari China dan menyertakan perilaku yang selaras dengan negara dalam bobotnya.Anthropic menjelaskan komponen memori agen dan «bermimpi»
Pada 6 November, Anthropic menerbitkan tulisan berjudul "The components of agent memory" tentang cara mereka memandang memori untuk agen Claude dan manfaat «bermimpi». Anthropic mendefinisikan memori agen sebagai hal yang dipelajari Claude dari pengalaman dan disimpan sebagai catatan agar dapat dibaca kembali di sesi berikutnya; perubahan bobot, pembelajaran dalam konteks, dan pemadatan tidak termasuk dalam definisi tersebut. Anthropic menggambarkan «bermimpi» sebagai proses agen meninjau log dan transkripnya di antara sesi untuk memperbaiki kesalahan, menulis catatan baru, dan membangun representasi memori baru.
OpenAI memperkenalkan BioBasicsBench, tolok ukur untuk tugas-tugas sains laboratorium basah sehari-hari
OpenAI memperkenalkan BioBasicsBench, tolok ukur untuk 100 tugas rutin di laboratorium basah yang dikembangkan bersama Ligo, perusahaan bioteknologi yang berfokus pada desain enzim. Tugas-tugas ini menggunakan bukti eksperimen mentah (gambar gel, cawan koloni, mikroskopi, berkas sekuensing, hasil ekspor instrumen, dan video pekerjaan di meja laboratorium) dalam berbagai bidang, termasuk metode protein, pencitraan dan sitometri, kuantifikasi dan pengujian, metode asam nukleat, serta kloning molekuler. Para ilmuwan menyusun tugas berdasarkan eksperimen mereka sendiri, dan jawaban dinilai menggunakan rubrik yang ditulis para ahli dan memberikan kredit parsial.Artificial Analysis: di AA-PersonalityBench, Qwen3.8 27B menulis jawaban terpanjang dan GPT-6 Sol terpendek
Artificial Analysis melaporkan bahwa panjang rata-rata respons di AA-PersonalityBench berbeda sekitar 6x di antara model yang diukurnya, mulai dari 174 hingga sekitar 1.030 kata untuk pertanyaan yang sama. Angka-angka tersebut berasal dari situs itu sendiri.Artificial Analysis meluncurkan VIALS-AA, papan peringkat penalaran visual ilmu hayati yang dipimpin Gemini 4 Carbon dengan skor 64%
Artificial Analysis telah meluncurkan VIALS-AA, papan peringkat untuk benchmark VIALS dari Handshake AI. VIALS memiliki 161 tugas dalam delapan domain. Untuk setiap tugas, model harus membaca artefak ilmiah (gel blot, plot flow cytometry, peta plasmid, filogeni) dan menarik kesimpulan tertentu.
Katalog OpenRouter menggeser tanggal kedaluwarsa dua model Meta Llama 3.2 dari 15 November ke 20 November
Katalog model OpenRouter kini mencantumkan tanggal kedaluwarsa 20 November 2026 untuk Meta: Llama 3.2 3B Instruct (meta-llama/llama-3.2-3b-instruct, konteks 131.072 token) dan Meta: Llama 3.2 1B Instruct (meta-llama/llama-3.2-1b-instruct, 60.000 token). Sebelumnya, kedua entri mencantumkan 15 November 2026. Ini hanya perubahan pada kolom katalog; entri tersebut tidak menjelaskan alasan perubahan tanggal atau apa yang akan terjadi pada model setelah tanggal itu.OpenRouter meluncurkan Auto Router dan Auto Code, generasi baru perute model
OpenRouter memperkenalkan dua perute model: Auto Router, untuk tanya jawab umum dan agen, serta Auto Code, untuk agen pemrograman. OpenRouter mengatakan bahwa sistem ini memperlihatkan cara keputusan perutean dibuat untuk setiap permintaan.
Katalog OpenRouter menghapus tanggal kedaluwarsa 18 November untuk MoonshotAI: Kimi K2.5
Katalog model OpenRouter kini tidak lagi menampilkan tanggal kedaluwarsa untuk MoonshotAI: Kimi K2.5 (moonshotai/kimi-k2.5, konteks 262.144 token). Sebelumnya, pada 6 November, entri tersebut mencantumkan tanggal 18 November 2026; kini kolom itu kosong. OpenRouter belum menyatakan apakah penghentian tersebut dibatalkan atau hanya ditunda.Katalog OpenRouter mencantumkan tanggal kedaluwarsa 18 November untuk MoonshotAI: Kimi K2.5
Katalog model OpenRouter kini menampilkan tanggal kedaluwarsa 18 November 2026 untuk MoonshotAI: Kimi K2.5 (moonshotai/kimi-k2.5, konteks 262.144 token), yang telah tercantum sejak Januari 2026. Sebelumnya, entri tersebut tidak memiliki tanggal kedaluwarsa. Ini hanya sebuah kolom dalam katalog; entri tersebut tidak menjelaskan alasannya atau apa yang akan terjadi pada model setelah tanggal itu.OpenAI brings GPT-Image-2.6 Flare and Sunburst to the API and Codex
OpenAI released Images 2.6 on November 4 in ChatGPT, Codex and the API, available globally in ChatGPT and Codex on all subscription tiers. In the API it comes as two models, GPT-Image-2.6 Flare and Sunburst. OpenAI says both generate images 50% faster than before. Flare, at low quality, can produce an image in as little as six seconds and improves layout for posters and product imagery. At medium or high quality, Sunburst gives higher-quality images and keeps details more consistent from one edit to the next. ChatGPT Images 2.6 adds GIF output and reference images. OpenAI says people now create 4 billion images per week across ChatGPT, Codex and the API.Village: model berbobot terbuka menjadi pilihan terbaik untuk 3% anggaran, turun dari 41% pada Juni
Village, penerbit LLM Atlas, melaporkan bahwa model tertutup kini menguasai hampir seluruh titik pada batas harga-kinerja. Menurut perkiraannya, model berbobot terbuka menjadi model terkuat untuk 3% anggaran, hampir semuanya berada di segmen termurah (Gemma 4 E4B dari Google dan MiMo-V2.6-Flash dari Xiaomi). Pada Juni, porsinya 41%, ketika DeepSeek V4 Flash saja memimpin hampir sepertiga anggaran. Village menyebut porsi saat ini sebagai yang terendah yang pernah diukurnya; pada akhir setiap kuartal sejak 2024, angkanya setidaknya 6%.