 AI Tracker
Nieuws over modellen,
voor bouwers.
Het laatste nieuws over modellen van elke AI-aanbieder: lanceringen, prijswijzigingen en uitfaseringen, samengevat met wat ze voor jou betekenen.
De catalogus van OpenRouter vermeldt geen vervaldatum van 31 december meer voor Z.ai: GLM 4.7
In de modelcatalogus van OpenRouter staat geen vervaldatum meer voor Z.ai: GLM 4.7 (z-ai/glm-4.7, context van 204.800 tokens). Tot nu toe stond bij de vermelding 31 december 2026; het veld is nu leeg. OpenRouter heeft niet gezegd of de uitfasering is afgeblazen of alleen uitgesteld.OpenRouters catalogus verwijdert de vervaldatum van 20 november voor Meta: Llama 3.2 3B Instruct
In de modelcatalogus van OpenRouter wordt geen vervaldatum meer vermeld voor Meta: Llama 3.2 3B Instruct (meta-llama/llama-3.2-3b-instruct, context van 131.072 tokens). Tot nu toe stond er 20 november 2026; het veld is nu leeg. OpenRouter heeft niet gezegd of de uitfasering is afgeblazen of alleen uitgesteld.Anthropic laat Claude handelen en vloten besturen in EVE Online en EVE Frontier
Anthropic publiceerde „Project EVE”, onderzoek van het Fellows Program (april–juli 2026), uitgevoerd met Fenris Creations, waarin Claude twee games in het EVE-universum speelde. Anthropic rapporteert het volgende.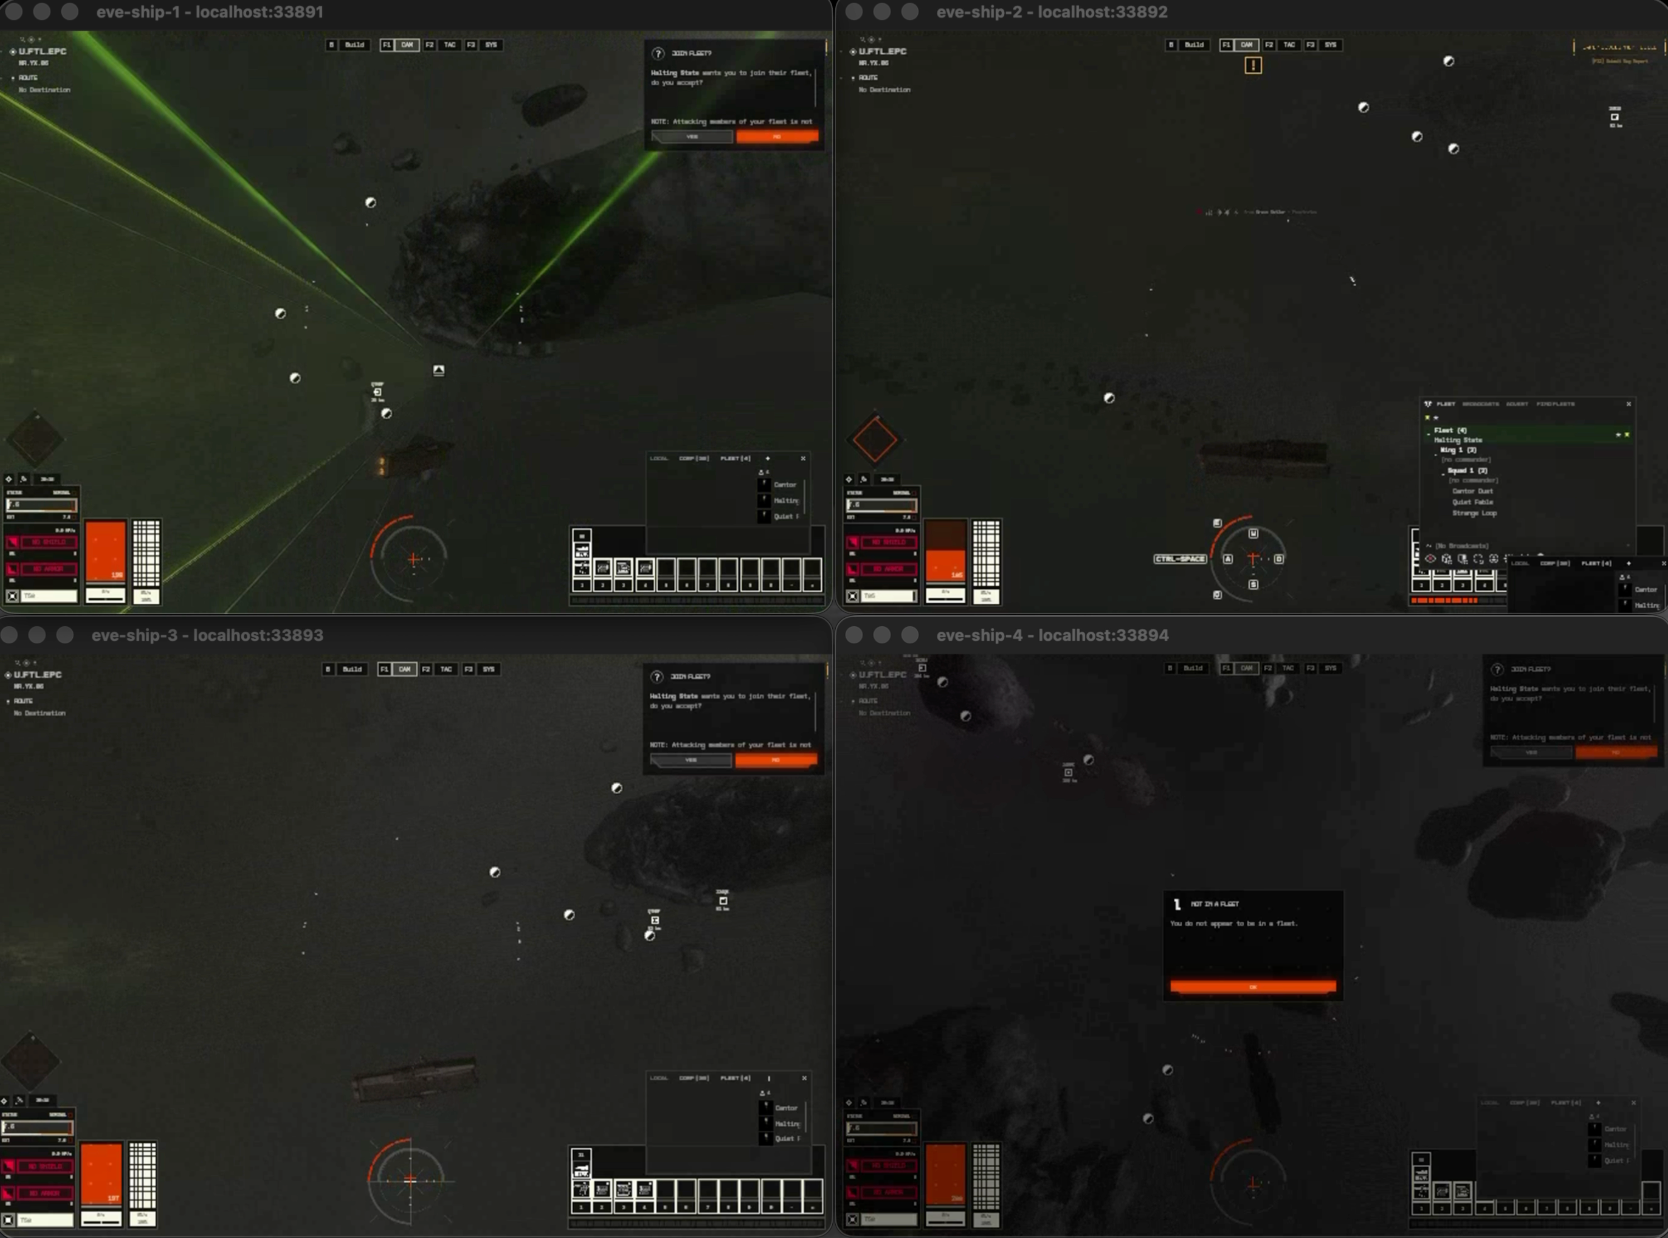
Artificial Analysis: Qwen-Audio-3.1-TTS-Plus voert de ranglijst voor Amerikaanse Engelse tekst-naar-spraak aan; HeyGen Voice leidt in Brits Engels en overall
Artificial Analysis zegt dat Qwen-Audio-3.1-TTS-Plus bovenaan staat in de Amerikaanse Engelse ranglijst van zijn Controlled Voice Arena, waarin elk tekst-naar-spraakmodel wordt beoordeeld met dezelfde acht gekloonde stemmen (vier Amerikaanse, vier Britse). HeyGen Voice presteert beter in Brits Engels en staat bovenaan de algemene ranglijst.In de catalogus van OpenRouter staat 13 november als einddatum voor LiquidAI: LFM2.5-2.6B
De modelcatalogus van OpenRouter vermeldt nu 13 november 2026 als einddatum voor LiquidAI: LFM2.5-2.6B (liquid/lfm-2.5-2.6b, context van 128.000 tokens), dat sinds augustus 2026 in de catalogus staat. Eerder had de vermelding geen einddatum. Dit is alleen een catalogusveld; er staat niet bij waarom deze datum is gekozen of wat er daarna met het model gebeurt.Nous Research brengt Arete-27B uit, Qwen3.8-27B dat na training het percentage dat de "partijlijn" volgt terugbrengt van 22% naar 1%
Nous Research kondigde Arete-27B op 6 november aan op X. Het is Qwen3.8-27B dat na training, in de woorden van het lab, is aangepast "om westerse waarden te versterken". Nous stelt dat de sterkste open modellen Chinees zijn en gedrag dat aansluit bij de staatslijn in hun gewichten hebben ingebakken.Anthropic legt de onderdelen van agentgeheugen en ‘dromen’ uit
Anthropic publiceerde op 6 november een artikel, ‘The components of agent memory’, over hoe het geheugen voor Claude-agents ziet en hoe ‘dromen’ daarbij helpt. Anthropic definieert agentgeheugen als wat Claude uit ervaring leert en tussen sessies bewaart als notities die het later kan lezen; veranderingen aan gewichten, leren binnen de context en compaction vallen buiten die definitie. Het beschrijft dromen als het terugblikken van de agent op zijn logboeken en transcripties tussen sessies door, om fouten te herstellen, nieuwe notities te schrijven en nieuwe geheugenstructuren op te bouwen.
OpenAI introduceert BioBasicsBench, een benchmark voor alledaagse taken in het natlab
OpenAI introduceert BioBasicsBench, een benchmark met 100 routinetaken in het natlab, ontwikkeld met Ligo, een biotechbedrijf dat zich richt op enzymontwerp. De taken zijn gebaseerd op ruwe experimentele gegevens (gelafbeeldingen, kweekplaten, microscopie, sequencingbestanden, exports van instrumenten en video's van laboratoriumwerk) en bestrijken eiwitmethoden, beeldvorming en cytometrie, kwantificering en assays, nucleïnezuurmethoden en moleculair kloneren. Wetenschappers stelden de taken op aan de hand van hun eigen experimenten; antwoorden worden beoordeeld met door experts opgestelde rubrics die gedeeltelijke punten toekennen.Artificial Analysis: op AA-PersonalityBench schrijft Qwen3.8 27B de langste antwoorden en GPT-6 Sol de kortste
Artificial Analysis meldt dat de gemiddelde lengte van antwoorden op AA-PersonalityBench ongeveer 6 keer verschilt tussen de gemeten modellen: van 174 tot ongeveer 1.030 woorden bij dezelfde vragen. De cijfers zijn afkomstig van de site zelf.Artificial Analysis lanceert VIALS-AA, een leaderboard voor visueel redeneren in de levenswetenschappen, waarop Gemini 4 Carbon aan kop gaat met 64%
Artificial Analysis heeft VIALS-AA gelanceerd, een leaderboard voor de VIALS-benchmark van Handshake AI. VIALS omvat 161 taken in acht domeinen. Een model moet daarbij een wetenschappelijk beeldmateriaal (zoals gelblots, flowcytometrieplots, plasmidekaarten en fylogenetische bomen) interpreteren en een specifieke conclusie trekken.
De catalogus van OpenRouter verschuift de vervaldatum van twee Meta Llama 3.2-modellen van 15 november naar 20 november
De modelcatalogus van OpenRouter vermeldt nu 20 november 2026 als vervaldatum voor Meta: Llama 3.2 3B Instruct (meta-llama/llama-3.2-3b-instruct, context van 131.072 tokens) en Meta: Llama 3.2 1B Instruct (meta-llama/llama-3.2-1b-instruct, 60.000 tokens). Tot nu toe stond bij beide vermeldingen 15 november 2026. Dit is alleen een catalogusveld; de vermeldingen geven niet aan waarom de datum is verschoven of wat er daarna met de modellen gebeurt.OpenRouter lanceert Auto Router en Auto Code, een nieuwe generatie modelrouters
OpenRouter introduceerde twee modelrouters: Auto Router, voor algemene vragen en agents, en Auto Code, voor codeeragents. Het zegt te laten zien hoe de routeringsbeslissing voor elk verzoek wordt genomen.
OpenRouter verwijdert de vervaldatum van 18 november van MoonshotAI: Kimi K2.5
In de modelcatalogus van OpenRouter wordt geen vervaldatum meer vermeld voor MoonshotAI: Kimi K2.5 (moonshotai/kimi-k2.5, context van 262.144 tokens). Op 6 november stond er nog 18 november 2026; het veld is nu leeg. OpenRouter heeft niet gezegd of de uitfasering is geannuleerd of alleen uitgesteld.In de catalogus van OpenRouter staat 18 november als vervaldatum voor MoonshotAI: Kimi K2.5
De modelcatalogus van OpenRouter vermeldt nu 18 november 2026 als vervaldatum voor MoonshotAI: Kimi K2.5 (moonshotai/kimi-k2.5, context van 262.144 tokens), dat sinds januari 2026 wordt vermeld. Eerder had de vermelding geen vervaldatum. Dit is alleen een catalogusveld; er staat niet waarom de datum is opgegeven of wat er daarna met het model gebeurt.OpenAI brings GPT-Image-2.6 Flare and Sunburst to the API and Codex
OpenAI released Images 2.6 on November 4 in ChatGPT, Codex and the API, available globally in ChatGPT and Codex on all subscription tiers. In the API it comes as two models, GPT-Image-2.6 Flare and Sunburst. OpenAI says both generate images 50% faster than before. Flare, at low quality, can produce an image in as little as six seconds and improves layout for posters and product imagery. At medium or high quality, Sunburst gives higher-quality images and keeps details more consistent from one edit to the next. ChatGPT Images 2.6 adds GIF output and reference images. OpenAI says people now create 4 billion images per week across ChatGPT, Codex and the API.Village: open-weightmodellen zijn de beste koop voor 3% van de budgetten, tegenover 41% in juni
Village, dat de LLM Atlas publiceert, meldt dat gesloten modellen nu bijna elk punt op de prijs-prestatiegrens bezetten. Volgens de schattingen van Village is een open-weightmodel het sterkste model voor 3% van de budgetten, vrijwel allemaal aan de goedkope kant (Gemma 4 E4B van Google en MiMo-V2.6-Flash van Xiaomi). In juni was dat aandeel 41%, toen DeepSeek V4 Flash in zijn eentje bijna een derde van de budgetten aanvoerde. Village zegt dat het huidige aandeel het laagste is dat het heeft gemeten; aan het einde van elk kwartaal sinds 2024 was het minstens 6%.