 AI Tracker
Models समाचार,
डेवलपर्स के लिए।
हर AI provider से Models से जुड़ी ताज़ा ख़बरें: लॉन्च, कीमत में बदलाव और बंद होने वाली सेवाएँ, संक्षेप में और आपके लिए उनका मतलब।
OpenRouter की कैटलॉग से Z.ai: GLM 4.7 की 31 दिसंबर की समाप्ति तिथि हटाई गई
OpenRouter की मॉडल कैटलॉग में अब Z.ai: GLM 4.7 (z-ai/glm-4.7, 204,800-टोकन संदर्भ) की समाप्ति तिथि नहीं दिखती। अब तक इस प्रविष्टि में 31 दिसंबर, 2026 लिखा था; अब यह फ़ील्ड खाली है। OpenRouter ने यह नहीं बताया है कि रिटायरमेंट रद्द कर दिया गया है या सिर्फ़ टाल दिया गया है।OpenRouter की कैटलॉग से Meta: Llama 3.2 3B Instruct की 20 नवंबर की समाप्ति तिथि हटाई गई
OpenRouter की मॉडल कैटलॉग में अब Meta: Llama 3.2 3B Instruct (meta-llama/llama-3.2-3b-instruct, 131,072-टोकन संदर्भ) की समाप्ति तिथि नहीं दिखती। अब तक इस प्रविष्टि में 20 नवंबर, 2026 दर्ज था; अब यह फ़ील्ड खाली है। OpenRouter ने यह नहीं बताया है कि मॉडल की सेवा समाप्ति रद्द की गई है या केवल टाली गई है।Anthropic ने EVE Online और EVE Frontier में Claude से व्यापार और बेड़े उड़वाए
Anthropic ने "Project EVE" प्रकाशित किया, जो उसके Fellows Program (अप्रैल–जुलाई 2026) का Fenris Creations के साथ किया गया शोध है। इसमें Claude ने EVE Universe के दो गेम खेले। Anthropic के मुताबिक: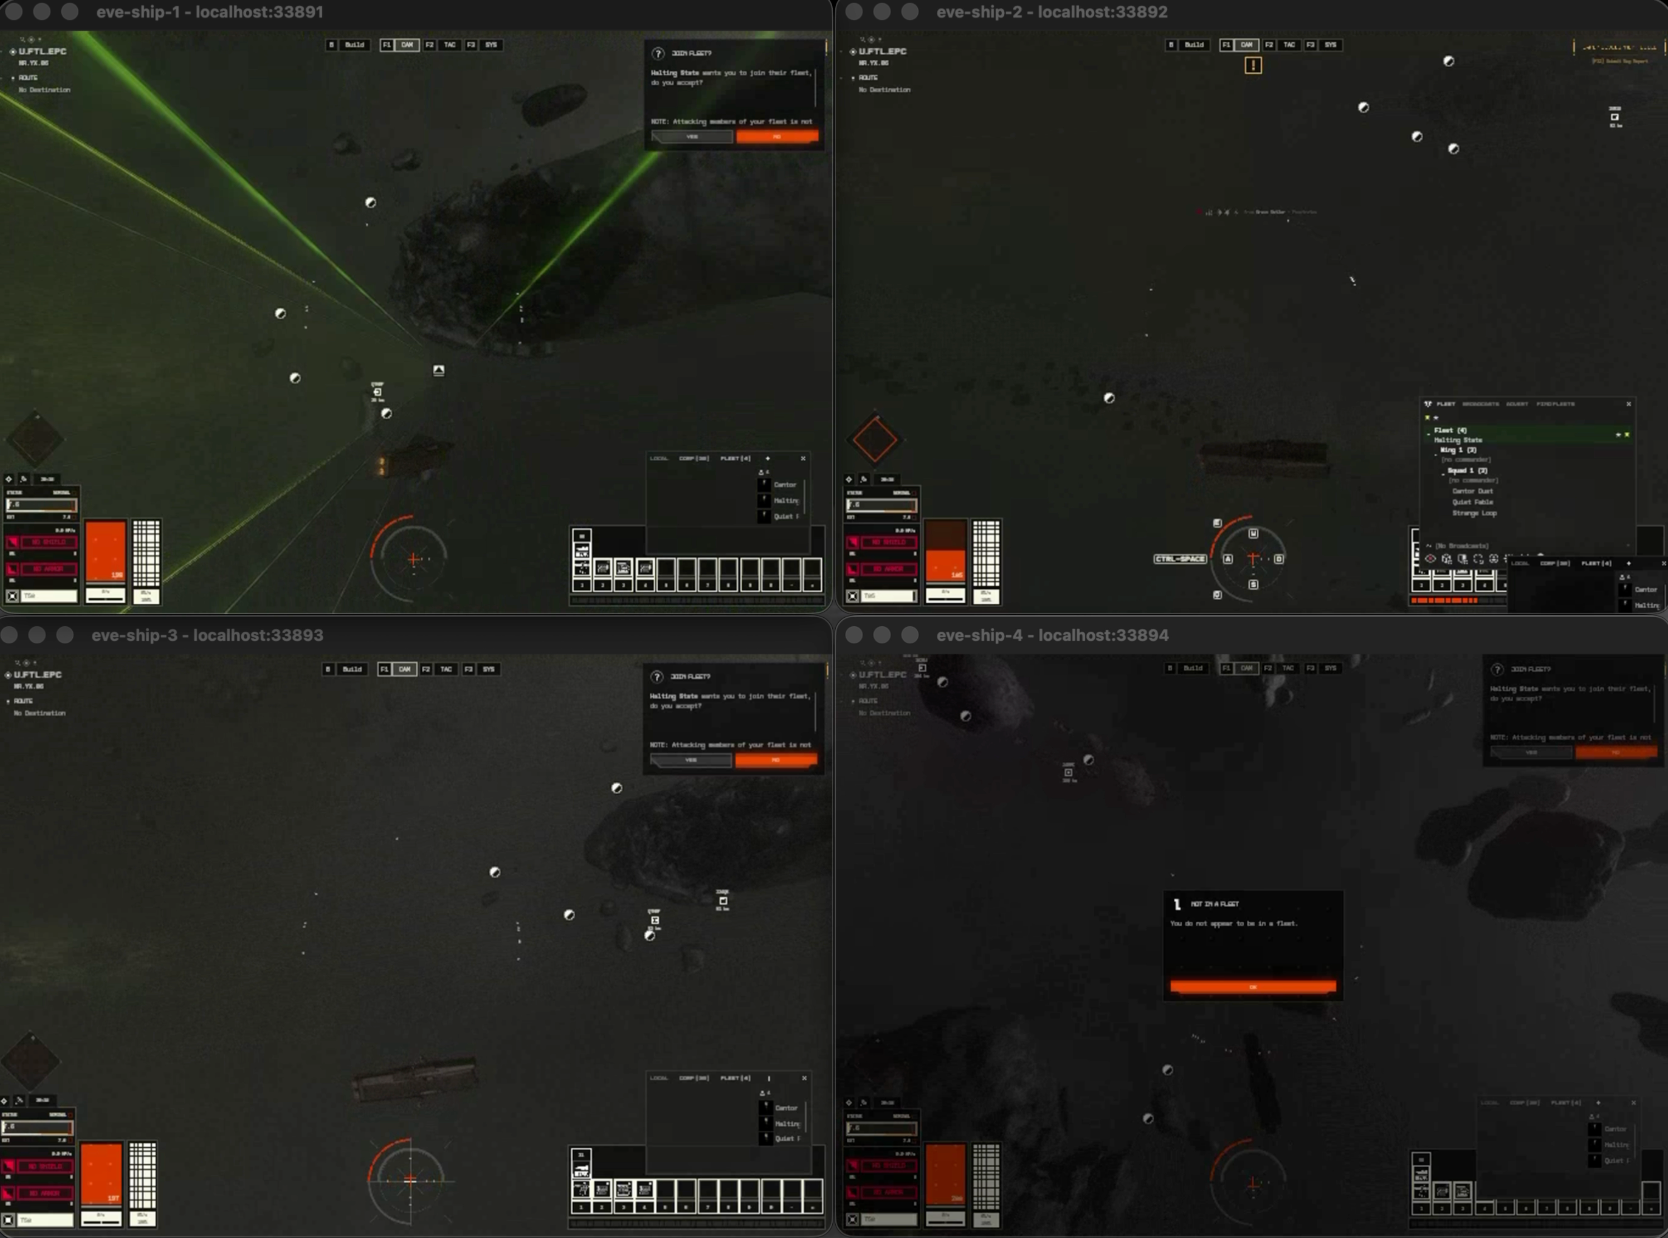
Artificial Analysis: Qwen-Audio-3.1-TTS-Plus अमेरिकी अंग्रेज़ी टेक्स्ट-टू-स्पीच में सबसे आगे, HeyGen Voice ब्रिटिश अंग्रेज़ी और कुल मिलाकर शीर्ष पर
Artificial Analysis के मुताबिक, उसके Controlled Voice Arena में—जहाँ हर टेक्स्ट-टू-स्पीच मॉडल को उन्हीं आठ क्लोन की गई आवाज़ों (चार अमेरिकी, चार ब्रिटिश) पर स्कोर किया जाता है—Qwen-Audio-3.1-TTS-Plus अमेरिकी अंग्रेज़ी रैंकिंग में सबसे आगे है, जबकि HeyGen Voice ब्रिटिश अंग्रेज़ी में बेहतर प्रदर्शन करता है और कुल लीडरबोर्ड में शीर्ष पर है।OpenRouter की कैटलॉग में LiquidAI: LFM2.5-2.6B की समाप्ति तिथि 13 नवंबर दी गई है
OpenRouter की मॉडल कैटलॉग में अब LiquidAI: LFM2.5-2.6B (liquid/lfm-2.5-2.6b, 128,000-टोकन संदर्भ) के लिए 13 नवंबर, 2026 की समाप्ति तिथि दिखाई गई है। यह मॉडल अगस्त 2026 से सूचीबद्ध है। पहले इस प्रविष्टि में समाप्ति तिथि नहीं थी। यह केवल कैटलॉग का एक फ़ील्ड है; प्रविष्टि में यह नहीं बताया गया कि ऐसा क्यों है या उस तारीख के बाद मॉडल का क्या होगा।Nous Research ने Arete-27B जारी किया, Qwen3.8-27B को पोस्ट-ट्रेन करके "पार्टी लाइन" की दर 22% से घटाकर 1% की
Nous Research ने 6 नवंबर को X पर Arete-27B की घोषणा की। लैब के शब्दों में, इसे "पश्चिमी मूल्यों को मज़बूत करने के लिए" Qwen3.8-27B को पोस्ट-ट्रेन करके बनाया गया है। Nous का तर्क है कि सबसे सक्षम ओपन मॉडल चीनी हैं और उनके वेट्स में राज्य के अनुरूप व्यवहार शामिल होता है।Anthropic ने एजेंट मेमोरी के घटकों और “ड्रीमिंग” के बारे में बताया
Anthropic ने 6 नवंबर को “एजेंट मेमोरी के घटक” शीर्षक से एक पोस्ट प्रकाशित की। इसमें बताया गया कि वह Claude एजेंटों की मेमोरी को किस तरह देखती है और “ड्रीमिंग” किस तरह मदद करती है। Anthropic के अनुसार, एजेंट मेमोरी वह है जो Claude अनुभव से सीखता है और सत्रों के बीच नोट्स के रूप में सहेजकर रखता है, जिन्हें वह बाद में पढ़ सकता है; वज़न में बदलाव, इन-कॉन्टेक्स्ट लर्निंग और कॉम्पैक्शन इस परिभाषा के दायरे में नहीं आते। Anthropic ने ड्रीमिंग को सत्रों के बीच एजेंट द्वारा अपने लॉग और ट्रांसक्रिप्ट पर विचार करने की प्रक्रिया बताया है, ताकि वह गलतियाँ सुधार सके, नए नोट्स लिख सके और मेमोरी के नए निरूपण बना सके।
OpenAI ने BioBasicsBench पेश किया, जो रोज़मर्रा के वेट-लैब विज्ञान कार्यों का बेंचमार्क है
OpenAI ने BioBasicsBench पेश किया, जो Ligo के साथ मिलकर बनाया गया 100 नियमित वेट-लैब कार्यों का बेंचमार्क है। Ligo एंज़ाइम डिज़ाइन पर केंद्रित एक बायोटेक कंपनी है। इन कार्यों में प्रोटीन विधियों, इमेजिंग और साइटोमेट्री, परिमाणीकरण और परीक्षणों, न्यूक्लिक एसिड विधियों तथा आणविक क्लोनिंग के लिए कच्चे प्रयोगात्मक साक्ष्य (जेल की छवियाँ, कॉलोनी प्लेटें, माइक्रोस्कोपी, सीक्वेंसिंग फ़ाइलें, उपकरणों से मिले डेटा और लैब-बेंच पर काम के वीडियो) का उपयोग किया जाता है। वैज्ञानिकों ने इन्हें अपने प्रयोगों के आधार पर लिखा, और विशेषज्ञों द्वारा तैयार रूब्रिक के अनुसार उत्तरों को अंक दिए जाते हैं, जिनमें आंशिक अंक भी मिलते हैं।Artificial Analysis: AA-PersonalityBench पर Qwen3.8 27B सबसे लंबे और GPT-6 Sol सबसे छोटे जवाब लिखता है
Artificial Analysis के अनुसार, AA-PersonalityBench पर उसके द्वारा मापे गए मॉडलों के बीच औसत जवाब की लंबाई में लगभग 6 गुना अंतर है—एक ही सवालों के जवाब 174 से लेकर लगभग 1,030 शब्दों तक के हैं। ये आंकड़े साइट के अपने हैं।Artificial Analysis ने VIALS-AA लॉन्च किया, जो जीवन-विज्ञान के दृश्य-तर्क के लिए एक लीडरबोर्ड है; इसमें Gemini 4 Carbon 64% के साथ सबसे आगे है
Artificial Analysis ने Handshake AI के VIALS बेंचमार्क के लिए एक लीडरबोर्ड VIALS-AA लॉन्च किया है। VIALS में आठ डोमेन के 161 कार्य हैं, जिनमें मॉडल को किसी वैज्ञानिक सामग्री (जेल ब्लॉट, फ़्लो साइटोमेट्री प्लॉट, प्लास्मिड मैप, फ़ाइलोजेनी) को पढ़कर एक विशिष्ट निष्कर्ष निकालना होता है।
OpenRouter की कैटलॉग में Meta Llama 3.2 के दो मॉडल की समाप्ति तिथि 15 नवंबर से बदलकर 20 नवंबर की गई
OpenRouter की मॉडल कैटलॉग में अब Meta: Llama 3.2 3B Instruct (meta-llama/llama-3.2-3b-instruct, 131,072-टोकन संदर्भ) और Meta: Llama 3.2 1B Instruct (meta-llama/llama-3.2-1b-instruct, 60,000 टोकन) की समाप्ति तिथि 20 नवंबर, 2026 दिखाई गई है। अब तक दोनों प्रविष्टियों में 15 नवंबर, 2026 लिखा था। यह केवल कैटलॉग का एक फ़ील्ड है; प्रविष्टियों में यह नहीं बताया गया है कि तारीख क्यों बदली या उसके बाद इन मॉडलों का क्या होगा।OpenRouter ने Auto Router और Auto Code लॉन्च किए, मॉडल राउटर की नई पीढ़ी
OpenRouter ने दो मॉडल राउटर पेश किए: सामान्य सवाल-जवाब और एजेंट्स के लिए Auto Router, और कोडिंग एजेंट्स के लिए Auto Code। कंपनी का कहना है कि यह दिखाता है कि हर अनुरोध के लिए रूटिंग का फ़ैसला कैसे लिया जाता है।
OpenRouter की कैटलॉग से MoonshotAI: Kimi K2.5 की 18 नवंबर की समाप्ति तिथि हटा दी गई
OpenRouter की मॉडल कैटलॉग में अब MoonshotAI: Kimi K2.5 (moonshotai/kimi-k2.5, 262,144-टोकन संदर्भ) की समाप्ति तिथि नहीं दिखती। इससे पहले, 6 नवंबर को इस प्रविष्टि में 18 नवंबर, 2026 की तारीख दर्ज थी; अब यह फ़ील्ड खाली है। OpenRouter ने यह नहीं बताया है कि सेवा-समापन रद्द हुआ है या केवल टाला गया है।OpenRouter की कैटलॉग में MoonshotAI: Kimi K2.5 की समाप्ति तिथि 18 नवंबर दी गई है
OpenRouter की मॉडल कैटलॉग में अब MoonshotAI: Kimi K2.5 (moonshotai/kimi-k2.5, 262,144-टोकन संदर्भ) की समाप्ति तिथि 18 नवंबर, 2026 दिखाई गई है। यह मॉडल जनवरी 2026 से सूचीबद्ध है। पहले इस प्रविष्टि में समाप्ति तिथि नहीं थी। यह केवल कैटलॉग का एक फ़ील्ड है; प्रविष्टि में यह नहीं बताया गया है कि ऐसा क्यों है या उस तारीख के बाद मॉडल का क्या होगा।OpenAI brings GPT-Image-2.6 Flare and Sunburst to the API and Codex
OpenAI released Images 2.6 on November 4 in ChatGPT, Codex and the API, available globally in ChatGPT and Codex on all subscription tiers. In the API it comes as two models, GPT-Image-2.6 Flare and Sunburst. OpenAI says both generate images 50% faster than before. Flare, at low quality, can produce an image in as little as six seconds and improves layout for posters and product imagery. At medium or high quality, Sunburst gives higher-quality images and keeps details more consistent from one edit to the next. ChatGPT Images 2.6 adds GIF output and reference images. OpenAI says people now create 4 billion images per week across ChatGPT, Codex and the API.Village: खुले वेट मॉडल बजट के 3% पर सबसे बेहतर सौदा हैं, जो जून के 41% से घटकर इतना रह गया
LLM Atlas प्रकाशित करने वाली Village की रिपोर्ट के अनुसार, अब मूल्य-प्रदर्शन की सीमा पर बंद मॉडल लगभग हर बजट में आगे हैं। उसके अनुमानों के मुताबिक, खुले वेट वाला मॉडल सिर्फ 3% बजट में सबसे बेहतर है—लगभग सभी सस्ते छोर पर (Google का Gemma 4 E4B और Xiaomi का MiMo-V2.6-Flash)। जून में यह हिस्सा 41% था, जब अकेले DeepSeek V4 Flash लगभग एक-तिहाई बजट में आगे था। Village का कहना है कि आज का हिस्सा उसके मापे गए स्तरों में सबसे कम है; 2024 से हर तिमाही के अंत में यह कम-से-कम 6% था।