 AI Tracker
Modele: wiadomości
dla twórców.
Najnowsze wiadomości z kategorii „Modele” od każdego dostawcy AI: premiery, zmiany cen i wycofania, w skrócie i z tym, co oznaczają dla Ciebie.
W katalogu OpenRouter usunięto datę wygaśnięcia 31 grudnia dla Z.ai: GLM 4.7
W katalogu modeli OpenRouter nie widnieje już data wygaśnięcia Z.ai: GLM 4.7 (z-ai/glm-4.7, kontekst o długości 204 800 tokenów). Dotychczas wpis wskazywał 31 grudnia 2026 r.; teraz pole jest puste. OpenRouter nie poinformował, czy wycofanie modelu zostało odwołane, czy tylko przełożone.Katalog OpenRouter usuwa datę wygaśnięcia 20 listopada dla Meta: Llama 3.2 3B Instruct
W katalogu modeli OpenRouter nie jest już wyświetlana data wygaśnięcia dla Meta: Llama 3.2 3B Instruct (meta-llama/llama-3.2-3b-instruct, kontekst o długości 131 072 tokenów). Dotychczas widniała tam data 20 listopada 2026 r.; pole jest teraz puste. OpenRouter nie poinformował, czy wycofanie modelu odwołano, czy tylko odłożono.Anthropic ma floty handlujące i latające w EVE Online i EVE Frontier
Anthropic opublikowało „Project EVE” — badanie przeprowadzone w ramach Fellows Program (kwiecień–lipiec 2026) we współpracy z Fenris Creations, w którym Claude grał w dwie gry z uniwersum EVE. Anthropic podaje, co następuje.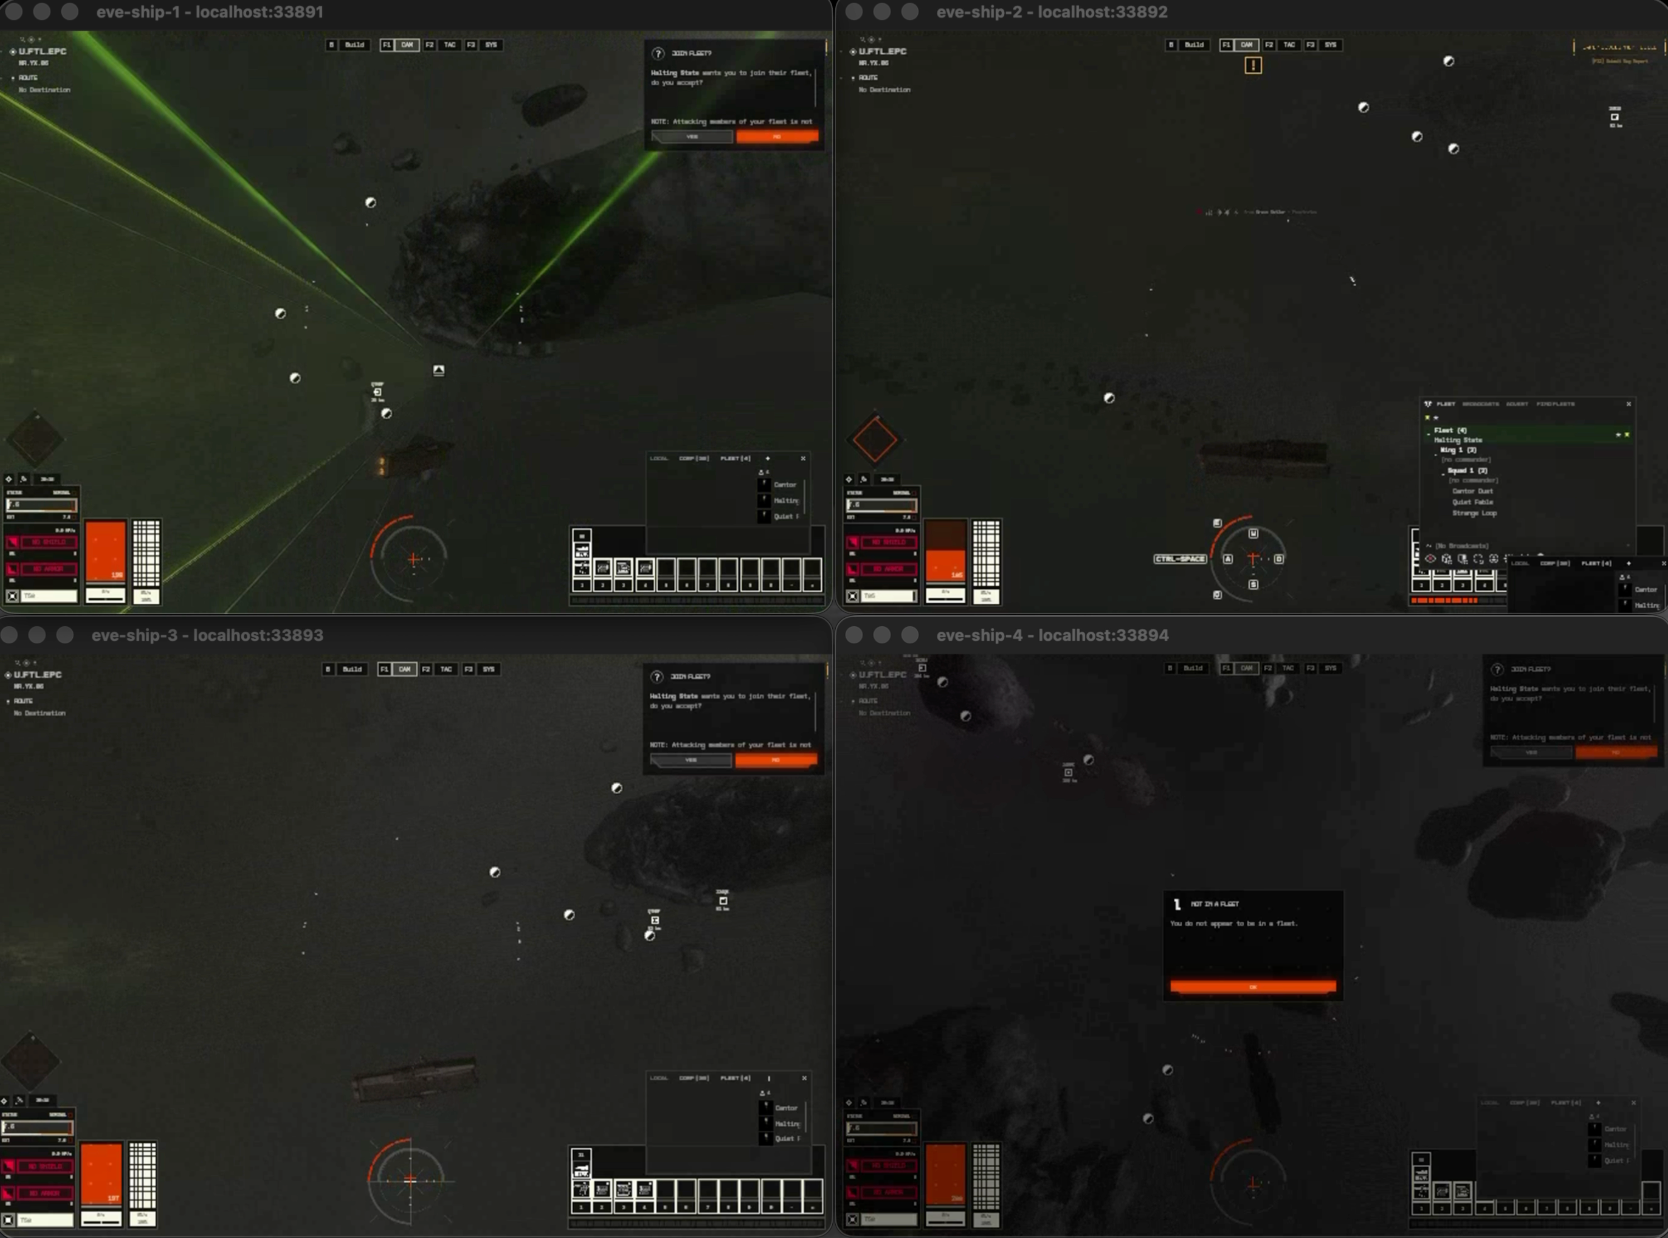
Artificial Analysis: Qwen-Audio-3.1-TTS-Plus prowadzi w syntezie mowy po amerykańsku, a HeyGen Voice — po brytyjsku i w klasyfikacji ogólnej
Artificial Analysis informuje, że w jego Controlled Voice Arena, gdzie każdy model syntezy mowy jest oceniany na podstawie tych samych ośmiu sklonowanych głosów (czterech amerykańskich i czterech brytyjskich), Qwen-Audio-3.1-TTS-Plus prowadzi w rankingu dla amerykańskiej odmiany angielskiego, a HeyGen Voice wypada lepiej w brytyjskiej odmianie i prowadzi w klasyfikacji ogólnej.W katalogu OpenRouter dla LiquidAI: LFM2.5-2.6B podano datę wygaśnięcia: 13 listopada
Katalog modeli OpenRouter pokazuje teraz datę wygaśnięcia 13 listopada 2026 r. dla LiquidAI: LFM2.5-2.6B (liquid/lfm-2.5-2.6b, kontekst o długości 128 000 tokenów), dostępnego w katalogu od sierpnia 2026 r. Wcześniej wpis nie zawierał daty wygaśnięcia. To tylko pole w katalogu — wpis nie wyjaśnia, dlaczego podano tę datę ani co stanie się z modelem po jej upływie.Nous Research udostępnia Arete-27B — model Qwen3.8-27B po dodatkowym treningu, który obniża odsetek odpowiedzi zgodnych z „linią partii” z 22% do 1%
6 listopada Nous Research ogłosiło na X model Arete-27B. To Qwen3.8-27B po dodatkowym treningu, którego celem — jak mówi laboratorium — jest „wzmocnienie zachodnich wartości”. Nous argumentuje, że najpotężniejsze otwarte modele pochodzą z Chin, a ich wagi odzwierciedlają zachowania zgodne z linią państwa.Anthropic wyjaśnia elementy pamięci agentów i „śnienia”
Anthropic opublikowało 6 listopada wpis „The components of agent memory” o tym, jak podchodzi do pamięci agentów Claude i jak pomaga „śnienie”. Anthropic definiuje pamięć agenta jako wiedzę, którą Claude zdobywa przez doświadczenie i zachowuje między sesjami w postaci notatek, do których może później wrócić; zmiany wag, uczenie w kontekście i kompakcja nie mieszczą się w tej definicji. „Śnienie” opisuje jako analizowanie przez agenta logów i transkrypcji między sesjami w celu korygowania błędów, tworzenia nowych notatek i budowania nowych reprezentacji pamięci.
OpenAI przedstawia BioBasicsBench — benchmark codziennych zadań z pracy w laboratorium biologicznym
OpenAI przedstawia BioBasicsBench — benchmark obejmujący 100 rutynowych zadań laboratoryjnych, opracowany we współpracy z Ligo, firmą biotechnologiczną zajmującą się projektowaniem enzymów. Zadania opierają się na surowych danych eksperymentalnych (zdjęciach żeli, płytkach z koloniami, obrazach mikroskopowych, plikach z sekwencjonowania, eksportach z urządzeń i nagraniach pracy przy stole laboratoryjnym) i dotyczą metod badania białek, obrazowania i cytometrii, ilościowego oznaczania i testów, metod pracy z kwasami nukleinowymi oraz klonowania molekularnego. Naukowcy opracowali je na podstawie własnych eksperymentów, a odpowiedzi ocenia się według kryteriów przygotowanych przez ekspertów, które przyznają również punkty częściowe.Artificial Analysis: w AA-PersonalityBench Qwen3.8 27B generuje najdłuższe odpowiedzi, a GPT-6 Sol — najkrótsze
Artificial Analysis podaje, że średnia długość odpowiedzi w AA-PersonalityBench różni się około 6-krotnie między zmierzonymi modelami — od 174 do około 1 030 słów przy tych samych pytaniach. Dane pochodzą z własnych pomiarów serwisu.Artificial Analysis uruchamia VIALS-AA — ranking modeli rozumowania wizualnego w naukach przyrodniczych, w którym prowadzi Gemini 4 Carbon z wynikiem 64%
Artificial Analysis uruchomiło VIALS-AA — ranking oparty na benchmarku VIALS firmy Handshake AI. VIALS obejmuje 161 zadań z ośmiu dziedzin. Model musi odczytać artefakt naukowy (blot żelowy, wykres cytometrii przepływowej, mapę plazmidu, drzewo filogenetyczne) i wyciągnąć konkretny wniosek.
W katalogu OpenRouter data wygaśnięcia dwóch modeli Meta Llama 3.2 została przesunięta z 15 na 20 listopada
W katalogu modeli OpenRouter widnieje teraz data wygaśnięcia 20 listopada 2026 r. dla Meta: Llama 3.2 3B Instruct (meta-llama/llama-3.2-3b-instruct, kontekst 131 072 tokenów) oraz Meta: Llama 3.2 1B Instruct (meta-llama/llama-3.2-1b-instruct, 60 000 tokenów). Do tej pory przy obu pozycjach widniała data 15 listopada 2026 r. To jedynie zmiana pola w katalogu — nie podano, dlaczego data została przesunięta ani co stanie się z modelami po tym terminie.OpenRouter wprowadza Auto Router i Auto Code — nową generację routerów modeli
OpenRouter wprowadził dwa routery modeli: Auto Router, przeznaczony do ogólnych pytań i odpowiedzi oraz agentów, a także Auto Code, przeznaczony dla agentów programistycznych. Firma twierdzi, że pokazuje, jak podejmowana jest decyzja o routingu dla każdego żądania.
Katalog OpenRouter usuwa datę wycofania 18 listopada dla MoonshotAI: Kimi K2.5
W katalogu modeli OpenRouter nie jest już wyświetlana data wycofania MoonshotAI: Kimi K2.5 (moonshotai/kimi-k2.5, kontekst o długości 262 144 tokenów). Jeszcze 6 listopada wpis wskazywał 18 listopada 2026 r.; teraz to pole jest puste. OpenRouter nie poinformował, czy wycofanie zostało anulowane, czy tylko przełożone.W katalogu OpenRouter widnieje data wygaśnięcia MoonshotAI: Kimi K2.5 — 18 listopada
Katalog modeli OpenRouter wskazuje teraz 18 listopada 2026 r. jako datę wygaśnięcia MoonshotAI: Kimi K2.5 (moonshotai/kimi-k2.5, kontekst o długości 262 144 tokenów), dostępnego w katalogu od stycznia 2026 r. Wcześniej wpis nie zawierał daty wygaśnięcia. To tylko pole w katalogu — wpis nie wyjaśnia, dlaczego podano tę datę ani co stanie się z modelem po jej upływie.OpenAI brings GPT-Image-2.6 Flare and Sunburst to the API and Codex
OpenAI released Images 2.6 on November 4 in ChatGPT, Codex and the API, available globally in ChatGPT and Codex on all subscription tiers. In the API it comes as two models, GPT-Image-2.6 Flare and Sunburst. OpenAI says both generate images 50% faster than before. Flare, at low quality, can produce an image in as little as six seconds and improves layout for posters and product imagery. At medium or high quality, Sunburst gives higher-quality images and keeps details more consistent from one edit to the next. ChatGPT Images 2.6 adds GIF output and reference images. OpenAI says people now create 4 billion images per week across ChatGPT, Codex and the API.Village: modele z otwartymi wagami to najlepszy wybór przy 3% budżetów, wobec 41% w czerwcu
Village, wydawca LLM Atlas, podaje, że zamknięte modele zajmują obecnie niemal wszystkie punkty na granicy stosunku ceny do wydajności. Według szacunków serwisu model z otwartymi wagami jest najmocniejszy przy 3% budżetów — niemal wyłącznie w najtańszym segmencie (Gemma 4 E4B od Google i MiMo-V2.6-Flash od Xiaomi). W czerwcu udział ten wynosił 41%, a sam DeepSeek V4 Flash prowadził wówczas w niemal jednej trzeciej budżetów. Village twierdzi, że obecny udział jest najniższy w historii pomiarów; na koniec każdego kwartału od 2024 roku wynosił co najmniej 6%.