AI Tracker
Мультимодальность:
новости для разработчиков.
Свежие новости по теме «Мультимодальность» от всех AI-провайдеров: запуски, изменения цен и снятие с поддержки — кратко и с тем, что это значит для вас.
Liquid AI представляет LFM3 — шесть небольших моделей для работы с текстом, изображениями, аудио и мультимодальными данными
Liquid AI объявила о выпуске LFM3 — нового поколения Liquid Foundation Models на базе, как утверждает компания, новой тригибридной архитектуры с новыми мультимодальными энкодерами. По словам компании, архитектура оптимизирована для 14 классов процессоров, включая GPU, CPU и NPU, а модели можно дообучать на одном GPU.Google DeepMind представляет Genie 4 — интерактивную модель мира, работающую в реальном времени
27 октября 2026 года Google DeepMind объявила о выпуске Genie 4, назвав её своей самой реалистичной и интерактивной моделью мира на сегодняшний день. В публикации DeepMind говорится, что пользователи могут исследовать динамичные среды в реальном времени и наблюдать, как меняется сцена, какие звуки в ней звучат и как люди в ней двигаются, реагируют и разговаривают. Компания опубликовала запись в блоге «Genie 4: новое поколение симуляции мира».MAI-Image-2.7-Preview от Microsoft занимает 2-е место в рейтинге Artificial Analysis по редактированию изображений
По данным Artificial Analysis, MAI-Image-2.7-Preview от Microsoft AI — новейшая модель для редактирования изображений и преемница MAI-Image-2.6, выпущенной в августе, — занимает второе место в рейтинге AA-Image-Editing v2.1, немного уступая GPT Image 2.5 Sunburst (max) от OpenAI. Результаты получены самой Artificial Analysis.SenseTime reportedly open-sources SenseNova 6.8 Code2Video, a 27B code-to-video model
A Chinese AI blogger reports that SenseTime open-sourced SenseNova 6.8 Code2Video on October 27, with weights on Hugging Face under sensenova/SenseNova-6.8-Code2Video. The report is second-hand; SenseTime's own announcement is not cited.Maya-2 — голосовая модель для индийских языков с открытыми весами
27 октября была опубликована Maya-2 — голосовая модель (синтез речи), ориентированная на Индию, с открытыми весами под именем maya-research/maya2-native на Hugging Face. В анонсе на X говорится, что модель охватывает более 1,5 миллиарда человек во всех 28 штатах и 8 союзных территориях.
Baidu открыла исходный код Unlimited OCR 2 — парсера документов с почти постоянными затратами на декодирование
26 октября Baidu объявила в X о выпуске Unlimited OCR 2; код доступен на GitHub, а веса — на Hugging Face. Модель предназначена для разбора документов практически любой длины в пределах конечного контекстного окна.Artificial Analysis запускает Code2Video-AA — бенчмарк маркетинговых видеороликов, созданных с помощью кода
Artificial Analysis представила Code2Video-AA — собственную реализацию Code2Video Bench от HeyGen, созданную в партнёрстве с HeyGen. Модели получают 114 брифов для маркетинговых роликов о продуктах и брендах и должны ответить на каждый из них композицией HyperFrames в формате HTML за один запрос, без использования инструментов; композиция преобразуется в видео без доступа к сети. Модель-судья (Gemini 4 Argon, high) сравнивает пары видео по вовлечённости, соответствию замыслу запроса, композиции, временной согласованности и мастерству исполнения, а оценки Elo по пяти критериям усредняются и формируют итоговый балл. Более 35 000 вердиктов позволяют ранжировать 27 моделей. Результаты принадлежат Artificial Analysis.Дообученная CNN 2015 года лучше GPT-6 Astra и Claude Fable 5.1 распознаёт поражения кожи, сообщает дерматолог
Доктор Магнус Линч, консультант-дерматолог в больнице Guy's Hospital и King's College London, опубликовал результаты тестирования GPT-6 Astra и Claude Fable 5.1 на 200 поражениях, подтверждённых биопсией и случайно выбранных из общедоступного набора данных MILK10k. Каждая модель получила клиническую фотографию и дерматоскопическое изображение, одинаковый запрос и настройки по умолчанию, а затем выбирала один из шести диагнозов. Для сравнения использовалась Inception v3 (выпущенная в 2015 году), дообученная на 68 011 изображениях из ISIC Archive на одном GPU H100; тестовые поражения были исключены из обучающих данных.Moonshot запускает Kimi K3.1 Pro; открытые веса обещают выпустить до 4 ноября
Moonshot представила Kimi K3.1 Pro, назвав его своей самой мощной моделью с открытыми весами класса 3T: мультимодальной моделью типа mixture-of-experts с 2,8T параметров всего и 104B активных параметров, а также контекстом на 1M токенов. По словам Moonshot, K3.1 Pro и K3.1 Pro Highspeed (в 2–3 раза быстрее) уже доступны на Kimi.ai, Kimi Work, Kimi Code и через Kimi API (идентификаторы моделей kimi-k3.1-pro и kimi-k3.1-pro-highspeed). Открытые веса обещают выпустить до 4 ноября 2026 года.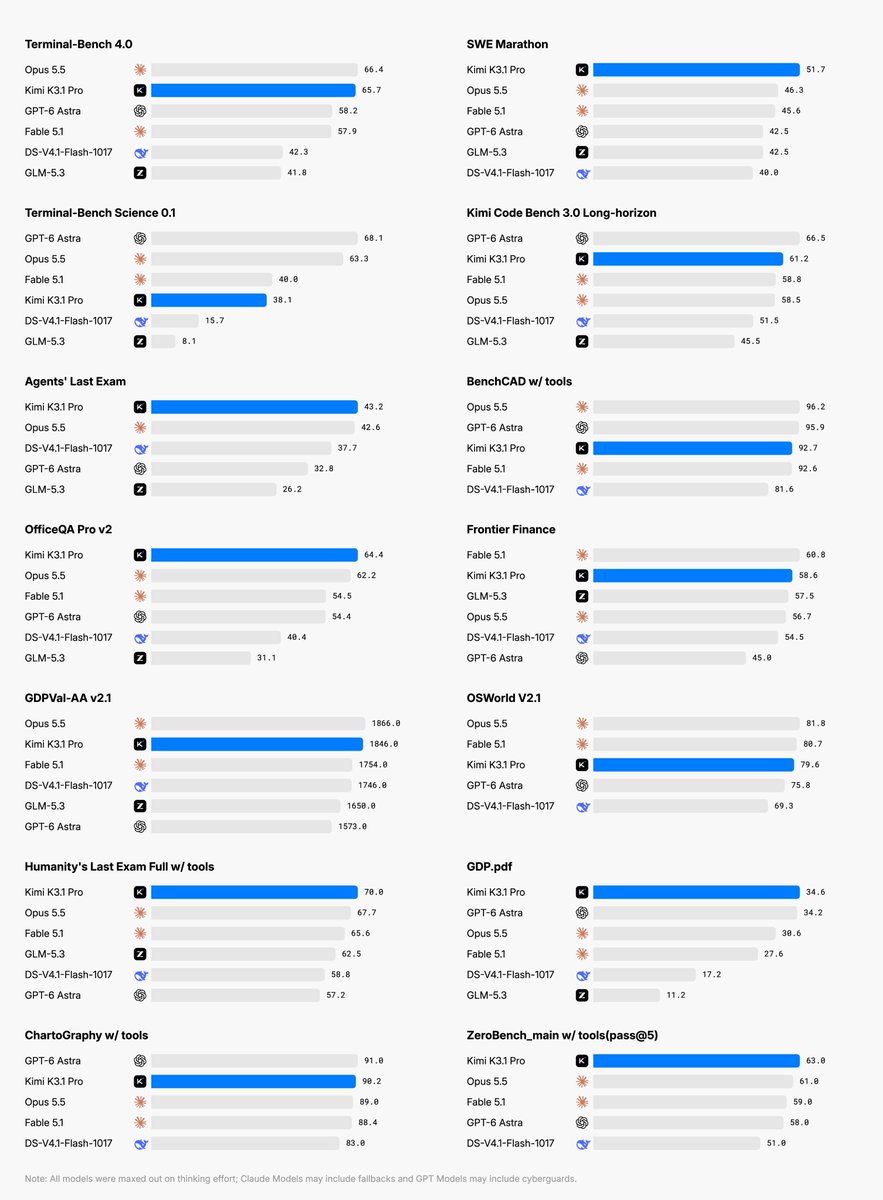
Block представляет Dessa — полно-дуплексную модель преобразования речи в речь в предварительном просмотре
Block, компания, стоящая за Square и Cash App, представила исследовательскую предварительную версию Dessa, которую называет «самой аутентичной полно-дуплексной речевой моделью из когда-либо созданных». В анонсе Джека Дорси говорится, что разговор с ней похож на разговор с человеком — с эмоциями, нюансами, паузами и естественным темпом речи.Google releases Gemini 4 Argon, its latest frontier model
Google released Gemini 4 Argon on October 13, 2026, and says it is available globally. Google's blog post was shared on Hacker News on October 20. The Gemini API changelog lists gemini-4-argon as generally available from October 13, describing it as Google's most capable model, built for complex coding, agentic, math and science tasks.Grok Bot 0.75.2 добавляет карточки в десктопные чаты и генерацию видео
Вышла версия Grok Bot 0.75.2, согласно публикации в X от участника команды Grok Bot со ссылкой на журнал изменений релиза на x.ai. В публикации перечислены три изменения:Ideogram introduces its first vector model
Ideogram announced its first vector model on X. According to Ideogram, it generates clean, editable SVGs with smooth gradients and sharp typography from a text prompt, or turns any image into a detailed, scalable vector.
Mistral releases Voxtral 3, speech models and a voice agent SDK
Mistral announced Voxtral 3 on October 20, 2026 (shared on Hacker News, where it had 735 points and 182 comments by October 20). Details and benchmarks below are Mistral's own claims from its announcement page.
ElevenLabs opens a limited alpha of Eleven Realtime Translation
ElevenLabs announced on X on October 21, 2026 a limited alpha of Eleven Realtime Translation, which builds live voice translation into calls. It followed the launch earlier that week of Eleven Realtime, its product for voice agents that talk to people.