AI Tracker
Tin đa phương thức,
cho nhà phát triển.
Tin mới nhất về đa phương thức từ mọi nhà cung cấp AI: ra mắt, thay đổi giá và ngừng hỗ trợ, tóm tắt kèm ý nghĩa với bạn.
Liquid AI ra mắt LFM3, gồm sáu mô hình nhỏ cho văn bản, hình ảnh, âm thanh và đa phương thức
Liquid AI công bố LFM3, thế hệ mới của Liquid Foundation Models, được xây dựng trên kiến trúc ba lai mới mà công ty giới thiệu cùng các bộ mã hóa đa phương thức mới. Công ty cho biết kiến trúc được tối ưu cho 14 dòng bộ xử lý trên GPU, CPU và NPU, và các mô hình có thể được tinh chỉnh trên một GPU.Google DeepMind giới thiệu Genie 4, mô hình thế giới tương tác theo thời gian thực
Google DeepMind công bố Genie 4 vào ngày 27 tháng 10 năm 2026, gọi đây là mô hình thế giới chân thực và tương tác nhất từ trước đến nay của hãng. Trong bài đăng, DeepMind cho biết người dùng có thể khám phá các môi trường sống động theo thời gian thực, đồng thời quan sát cảnh vật phản hồi, phát ra âm thanh và cách những người trong đó di chuyển, phản ứng cũng như trò chuyện. Hãng đã đăng bài blog “Genie 4: a new generation of world simulation”.MAI-Image-2.7-Preview của Microsoft xếp thứ 2 về chỉnh sửa ảnh trên Artificial Analysis
Artificial Analysis cho biết MAI-Image-2.7-Preview của Microsoft AI, model chỉnh sửa ảnh mới nhất và là phiên bản kế nhiệm MAI-Image-2.6 (ra mắt vào tháng 8), đứng thứ hai trên bảng xếp hạng AA-Image-Editing v2.1, bám sát GPT Image 2.5 Sunburst (max) của OpenAI. Kết quả này do chính Artificial Analysis đưa ra.SenseTime reportedly open-sources SenseNova 6.8 Code2Video, a 27B code-to-video model
A Chinese AI blogger reports that SenseTime open-sourced SenseNova 6.8 Code2Video on October 27, with weights on Hugging Face under sensenova/SenseNova-6.8-Code2Video. The report is second-hand; SenseTime's own announcement is not cited.Maya-2, mô hình giọng nói cho các ngôn ngữ Ấn Độ, được phát hành với trọng số mở
Maya-2, mô hình giọng nói (tổng hợp tiếng nói) hướng đến thị trường Ấn Độ, được công bố với trọng số mở vào ngày 27 tháng 10 dưới tên maya-research/maya2-native trên Hugging Face. Thông báo trên X cho biết mô hình hỗ trợ hơn 1,5 tỷ người trên khắp 28 bang và 8 lãnh thổ liên bang.
Baidu phát hành mã nguồn mở Unlimited OCR 2, bộ phân tích tài liệu có chi phí giải mã gần như không đổi
Baidu công bố Unlimited OCR 2 trên X vào ngày 26 tháng 10, cùng mã nguồn trên GitHub và trọng số trên Hugging Face. Mô hình được xây dựng để phân tích tài liệu dài gần như tùy ý trong một cửa sổ ngữ cảnh hữu hạn.Artificial Analysis ra mắt Code2Video-AA, bộ benchmark video marketing được tạo bằng mã
Artificial Analysis giới thiệu Code2Video-AA, bản triển khai riêng của Code2Video Bench của HeyGen, được xây dựng cùng HeyGen. Các mô hình nhận 114 đề bài về marketing sản phẩm và thương hiệu, và phải trả lời mỗi đề bài bằng một bố cục HTML HyperFrames trong một lượt phản hồi duy nhất, không dùng công cụ; bố cục này được kết xuất thành video mà không có quyền truy cập mạng. Một mô hình giám khảo (Gemini 4 Argon, high) so sánh từng cặp video dựa trên mức độ thu hút, ý định của prompt, bố cục, tính nhất quán theo thời gian và độ hoàn thiện; điểm Elo trên năm trục được lấy trung bình để tạo thành điểm tổng. Hơn 35.000 lượt đánh giá xếp hạng 27 mô hình. Đây là kết quả riêng của Artificial Analysis.Một CNN được tinh chỉnh từ năm 2015 vượt GPT-6 Astra và Claude Fable 5.1 trong việc nhận diện tổn thương da, theo báo cáo của một bác sĩ da liễu
Dr Magnus Lynch, bác sĩ da liễu tư vấn tại Guy's Hospital và King's College London, đã công bố một bài kiểm tra GPT-6 Astra và Claude Fable 5.1 trên 200 tổn thương đã được xác nhận bằng sinh thiết, chọn ngẫu nhiên từ bộ dữ liệu công khai MILK10k. Mỗi mô hình nhận một ảnh lâm sàng và một ảnh soi da, cùng một câu lệnh và thiết lập mặc định, rồi chọn trong sáu chẩn đoán. Mô hình đối chứng là Inception v3 (công bố năm 2015), được tinh chỉnh trên 68,011 ảnh từ ISIC Archive bằng một GPU H100; các tổn thương trong bộ kiểm tra đã bị loại khỏi dữ liệu huấn luyện.Moonshot ra mắt Kimi K3.1 Pro, dự kiến công bố trọng số mở trước ngày 4 tháng 11
Moonshot công bố Kimi K3.1 Pro, mà hãng gọi là mô hình trọng số mở mạnh nhất thuộc lớp 3T của mình: mô hình đa phương thức dạng mixture-of-experts, có tổng cộng 2.8T tham số, trong đó 104B tham số hoạt động, cùng cửa sổ ngữ cảnh 1M token. Moonshot cho biết K3.1 Pro và K3.1 Pro Highspeed (nhanh hơn 2–3×) đã có mặt trên Kimi.ai, Kimi Work, Kimi Code và Kimi API (model id kimi-k3.1-pro và kimi-k3.1-pro-highspeed). Hãng hứa công bố trọng số mở trước ngày 4 tháng 11 năm 2026.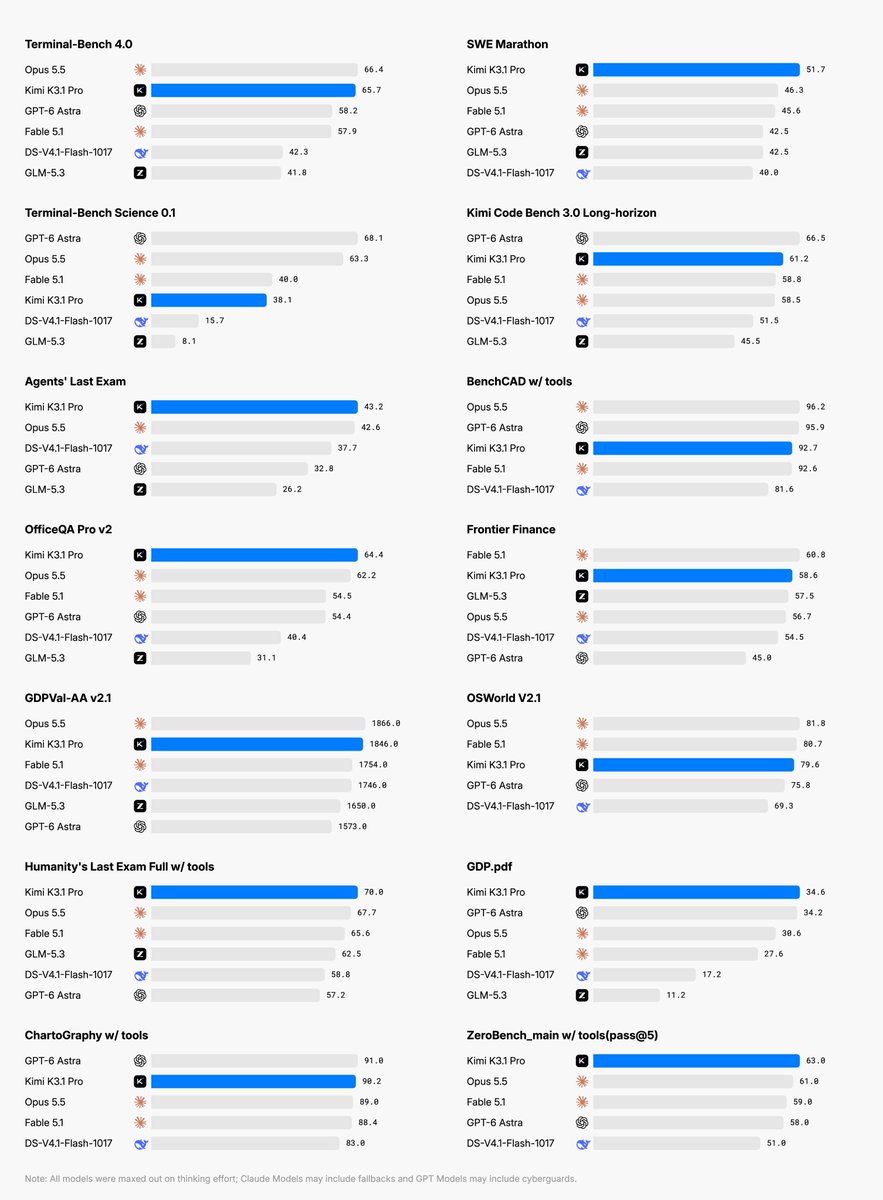
Block hé lộ bản xem trước Dessa, mô hình chuyển giọng nói thành giọng nói toàn song công
Block, công ty đứng sau Square và Cash App, đã giới thiệu bản xem trước nghiên cứu của Dessa, mà hãng gọi là “mô hình giọng nói toàn song công chân thực nhất từng được xây dựng”. Thông báo của Jack Dorsey cho biết trò chuyện với mô hình này có cảm giác như đang nói chuyện với một người, với cảm xúc, sắc thái, những khoảng ngừng và nhịp điệu tự nhiên.Google releases Gemini 4 Argon, its latest frontier model
Google released Gemini 4 Argon on October 13, 2026, and says it is available globally. Google's blog post was shared on Hacker News on October 20. The Gemini API changelog lists gemini-4-argon as generally available from October 13, describing it as Google's most capable model, built for complex coding, agentic, math and science tasks.Grok Bot 0.75.2 bổ sung thẻ trong các cuộc trò chuyện trên máy tính và tính năng tạo video
Grok Bot 0.75.2 đã ra mắt, theo một bài đăng trên X của một thành viên nhóm Grok Bot, có liên kết đến nhật ký thay đổi của bản phát hành trên x.ai. Bài đăng liệt kê ba thay đổi:Ideogram introduces its first vector model
Ideogram announced its first vector model on X. According to Ideogram, it generates clean, editable SVGs with smooth gradients and sharp typography from a text prompt, or turns any image into a detailed, scalable vector.
Mistral releases Voxtral 3, speech models and a voice agent SDK
Mistral announced Voxtral 3 on October 20, 2026 (shared on Hacker News, where it had 735 points and 182 comments by October 20). Details and benchmarks below are Mistral's own claims from its announcement page.
ElevenLabs opens a limited alpha of Eleven Realtime Translation
ElevenLabs announced on X on October 21, 2026 a limited alpha of Eleven Realtime Translation, which builds live voice translation into calls. It followed the launch earlier that week of Eleven Realtime, its product for voice agents that talk to people.