AI Tracker
Berita Multimodal,
untuk developer.
Berita Multimodal terbaru dari setiap penyedia AI: peluncuran, perubahan harga, dan penghentian, diringkas beserta artinya bagi Anda.
Liquid AI memperkenalkan LFM3, enam model kecil untuk teks, visi, audio, dan omni
Liquid AI mengumumkan LFM3, generasi baru Liquid Foundation Models yang dibangun dengan arsitektur tri-hybrid baru—demikian sebutan perusahaan—serta encoder multimodal baru. Menurut perusahaan, arsitektur ini dioptimalkan untuk 14 kelas prosesor yang mencakup GPU, CPU, dan NPU, dan model-modelnya dapat disetel lebih lanjut menggunakan satu GPU.Google DeepMind memperkenalkan Genie 4, model dunia interaktif real-time
Google DeepMind mengumumkan Genie 4 pada 27 Oktober 2026, menyebutnya sebagai model dunia paling realistis dan interaktif yang pernah mereka buat. Dalam unggahannya, DeepMind menyatakan bahwa pengguna dapat menjelajahi lingkungan dinamis secara real-time dan melihat bagaimana adegan merespons, menghasilkan suara, serta bagaimana orang-orang di dalamnya bergerak, bereaksi, dan berbicara. Mereka menerbitkan tulisan blog berjudul "Genie 4: a new generation of world simulation".MAI-Image-2.7-Preview dari Microsoft menempati peringkat #2 untuk penyuntingan gambar di Artificial Analysis
Artificial Analysis menyebut MAI-Image-2.7-Preview dari Microsoft AI, model penyuntingan gambar terbaru dan penerus MAI-Image-2.6 (dirilis pada Agustus), menempati posisi kedua di papan peringkat AA-Image-Editing v2.1, tak jauh di belakang GPT Image 2.5 Sunburst (max) dari OpenAI. Hasil ini berasal dari Artificial Analysis sendiri.SenseTime reportedly open-sources SenseNova 6.8 Code2Video, a 27B code-to-video model
A Chinese AI blogger reports that SenseTime open-sourced SenseNova 6.8 Code2Video on October 27, with weights on Hugging Face under sensenova/SenseNova-6.8-Code2Video. The report is second-hand; SenseTime's own announcement is not cited.Maya-2, model suara untuk bahasa-bahasa India, dirilis dengan bobot terbuka
Maya-2, model suara (sintesis ucapan) yang ditujukan untuk India, diterbitkan dengan bobot terbuka pada 27 Oktober dengan nama Hugging Face maya-research/maya2-native. Pengumuman di X menyebutkan bahwa model ini mencakup lebih dari 1,5 miliar orang di 28 negara bagian dan 8 wilayah persatuan.
Baidu open source Unlimited OCR 2, parser dokumen dengan biaya decoding yang nyaris konstan
Baidu mengumumkan Unlimited OCR 2 di X pada 26 Oktober, dengan kode di GitHub dan bobot model di Hugging Face. Model ini dirancang untuk mengurai dokumen dengan panjang nyaris berapa pun dalam jendela konteks yang terbatas.Artificial Analysis meluncurkan Code2Video-AA, benchmark video pemasaran yang dibuat dengan kode
Artificial Analysis memperkenalkan Code2Video-AA, implementasi mereka sendiri dari Code2Video Bench milik HeyGen, yang dibuat melalui kemitraan dengan HeyGen. Model menerima 114 brief pemasaran produk dan merek, lalu harus menjawab masing-masing dengan komposisi HTML HyperFrames dalam satu respons, tanpa alat; komposisi tersebut dirender menjadi video tanpa akses jaringan. Model penilai (Gemini 4 Argon, high) membandingkan pasangan video berdasarkan keterlibatan, kesesuaian dengan maksud prompt, komposisi, konsistensi temporal, dan keterampilan pengerjaan; rating Elo dari kelima aspek dirata-ratakan menjadi skor utama. Lebih dari 35.000 penilaian menentukan peringkat 27 model. Hasil ini merupakan hasil pengujian Artificial Analysis sendiri.CNN yang di-fine-tune dari 2015 mengungguli GPT-6 Astra dan Claude Fable 5.1 dalam mengenali lesi kulit, menurut seorang dokter kulit
Dr. Magnus Lynch, dokter spesialis kulit konsultan di Guy's Hospital dan King's College London, menerbitkan pengujian GPT-6 Astra dan Claude Fable 5.1 pada 200 lesi yang terbukti melalui biopsi dan dipilih secara acak dari set data publik MILK10k. Setiap model mendapat foto klinis dan gambar dermoskopi, prompt yang sama dan pengaturan default, lalu memilih di antara enam diagnosis. Model pembandingnya adalah Inception v3 (dirilis pada 2015), yang di-fine-tune menggunakan 68.011 gambar dari ISIC Archive pada satu GPU H100, dengan lesi uji dikeluarkan dari data pelatihannya.Moonshot meluncurkan Kimi K3.1 Pro, dengan bobot terbuka dijadwalkan tersedia paling lambat 4 November
Moonshot mengumumkan Kimi K3.1 Pro, yang disebutnya sebagai model open-weight kelas 3T paling mumpuni: model multimodal mixture-of-experts dengan total 2.8T parameter, 104B parameter aktif, dan konteks 1M token. Moonshot mengatakan K3.1 Pro dan K3.1 Pro Highspeed (2–3× lebih cepat) kini tersedia di Kimi.ai, Kimi Work, Kimi Code, dan Kimi API (ID model kimi-k3.1-pro dan kimi-k3.1-pro-highspeed). Bobot terbuka dijanjikan tersedia paling lambat 4 November 2026.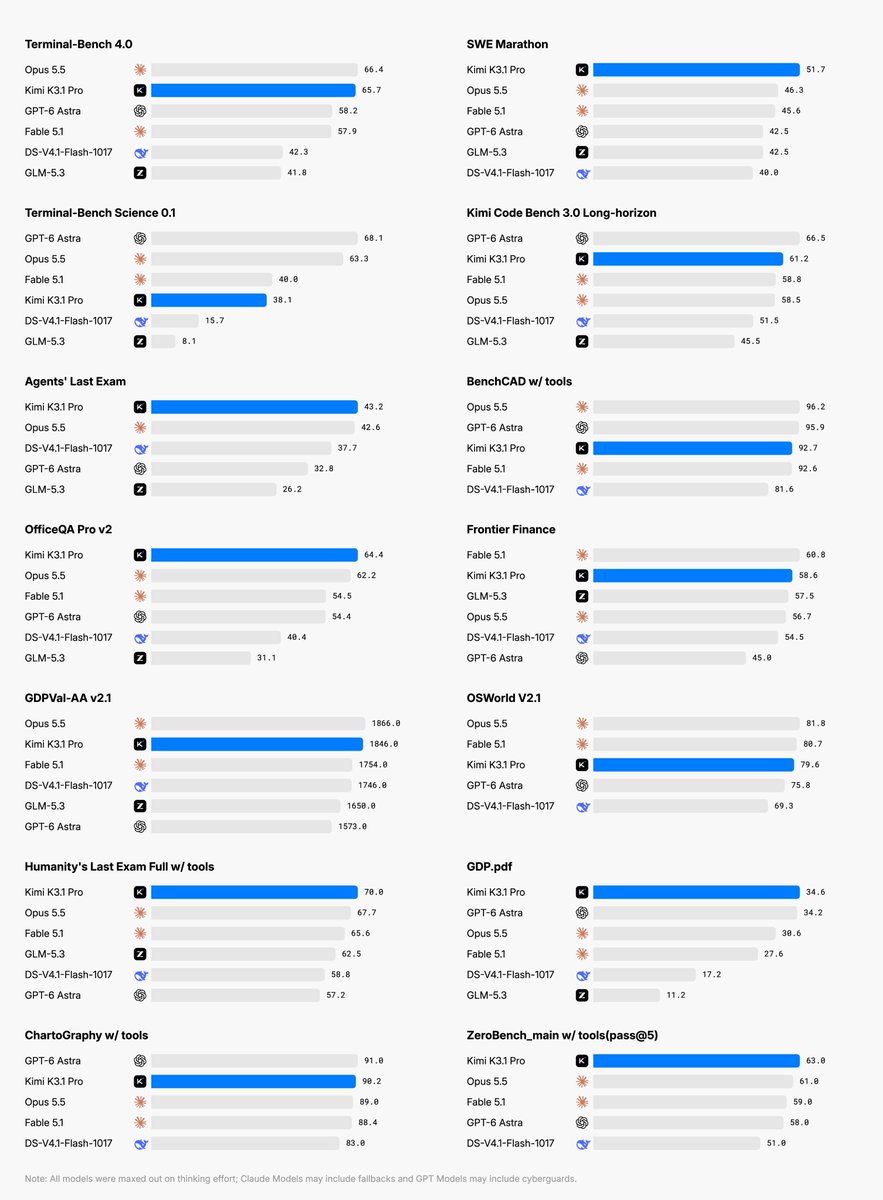
Block merilis pratinjau Dessa, model speech-to-speech dupleks penuh
Block, perusahaan di balik Square dan Cash App, memperkenalkan pratinjau riset Dessa, yang mereka sebut “model speech dupleks penuh paling autentik yang pernah dibuat”. Pengumuman Jack Dorsey menyebutkan bahwa berbicara dengan model ini terasa seperti berbicara dengan seseorang, lengkap dengan emosi, nuansa, jeda, dan irama bicara yang alami.Google releases Gemini 4 Argon, its latest frontier model
Google released Gemini 4 Argon on October 13, 2026, and says it is available globally. Google's blog post was shared on Hacker News on October 20. The Gemini API changelog lists gemini-4-argon as generally available from October 13, describing it as Google's most capable model, built for complex coding, agentic, math and science tasks.Grok Bot 0.75.2 menghadirkan kartu di chat desktop dan pembuatan video
Grok Bot 0.75.2 telah dirilis, menurut unggahan di X dari seorang anggota tim Grok Bot yang menautkan ke catatan perubahan rilis di x.ai. Unggahan tersebut mencantumkan tiga perubahan:Ideogram introduces its first vector model
Ideogram announced its first vector model on X. According to Ideogram, it generates clean, editable SVGs with smooth gradients and sharp typography from a text prompt, or turns any image into a detailed, scalable vector.
Mistral releases Voxtral 3, speech models and a voice agent SDK
Mistral announced Voxtral 3 on October 20, 2026 (shared on Hacker News, where it had 735 points and 182 comments by October 20). Details and benchmarks below are Mistral's own claims from its announcement page.
ElevenLabs opens a limited alpha of Eleven Realtime Translation
ElevenLabs announced on X on October 21, 2026 a limited alpha of Eleven Realtime Translation, which builds live voice translation into calls. It followed the launch earlier that week of Eleven Realtime, its product for voice agents that talk to people.