AI Tracker
Multimodale: le notizie,
per chi sviluppa.
Le ultime notizie su multimodale da ogni provider AI: lanci, cambi di prezzo e dismissioni, riassunti con cosa significano per te.
Liquid AI presenta LFM3, sei modelli compatti per testo, visione, audio e modalità omni
Liquid AI ha annunciato LFM3, una nuova generazione dei suoi Liquid Foundation Models, basata su quella che definisce una nuova architettura tri-ibrida, con nuovi encoder multimodali. Secondo l'azienda, l'architettura è ottimizzata per 14 classi di processori, tra GPU, CPU e NPU, e i modelli possono essere sottoposti a fine-tuning su una sola GPU.Google DeepMind presenta Genie 4, un modello del mondo interattivo in tempo reale
Google DeepMind ha annunciato Genie 4 il 27 ottobre 2026, definendolo il suo modello del mondo più realistico e interattivo finora. Nel suo post, DeepMind afferma che gli utenti possono esplorare ambienti dinamici in tempo reale e osservare come la scena risponde, quali suoni produce e come le persone al suo interno si muovono, reagiscono e parlano. Ha pubblicato un post sul blog intitolato «Genie 4: una nuova generazione di simulazione del mondo».MAI-Image-2.7-Preview di Microsoft è al #2 nella classifica di Artificial Analysis per l'editing di immagini
Secondo Artificial Analysis, MAI-Image-2.7-Preview di Microsoft AI, il più recente modello di editing di immagini e successore di MAI-Image-2.6 (rilasciato ad agosto), si piazza al secondo posto nella classifica AA-Image-Editing v2.1, poco dietro a GPT Image 2.5 Sunburst (max) di OpenAI. I risultati sono stati elaborati da Artificial Analysis.SenseTime reportedly open-sources SenseNova 6.8 Code2Video, a 27B code-to-video model
A Chinese AI blogger reports that SenseTime open-sourced SenseNova 6.8 Code2Video on October 27, with weights on Hugging Face under sensenova/SenseNova-6.8-Code2Video. The report is second-hand; SenseTime's own announcement is not cited.Maya-2, un modello vocale per le lingue indiane, è stato rilasciato con pesi aperti
Maya-2, un modello vocale (per la sintesi vocale) pensato per l’India, è stato pubblicato con pesi aperti il 27 ottobre con il nome maya-research/maya2-native su Hugging Face. L’annuncio su X afferma che copre oltre 1,5 miliardi di persone in tutti i 28 stati e gli 8 territori dell’Unione.
Baidu rende open source Unlimited OCR 2, un parser di documenti con un costo di decodifica quasi costante
Baidu ha annunciato Unlimited OCR 2 su X il 26 ottobre, pubblicando il codice su GitHub e i pesi su Hugging Face. Il modello è progettato per analizzare documenti di qualsiasi lunghezza, o quasi, entro una finestra di contesto finita.Artificial Analysis lancia Code2Video-AA, un benchmark di video di marketing realizzati con codice
Artificial Analysis ha presentato Code2Video-AA, una propria implementazione di Code2Video Bench di HeyGen, sviluppata in collaborazione con HeyGen. Ai modelli vengono forniti 114 brief di marketing per prodotti e brand e devono rispondere a ciascuno con una composizione HTML HyperFrames in un’unica risposta, senza strumenti; la composizione viene convertita in video senza accesso alla rete. Un modello valutatore (Gemini 4 Argon, high) confronta coppie di video in base a coinvolgimento, aderenza all’intento del prompt, composizione, coerenza temporale e qualità esecutiva; i punteggi Elo sui cinque assi vengono poi mediati per ottenere il punteggio complessivo. Oltre 35.000 valutazioni classificano 27 modelli. I risultati sono quelli di Artificial Analysis.Una CNN del 2015 ottimizzata supera GPT-6 Astra e Claude Fable 5.1 nell'identificazione delle lesioni cutanee, riferisce un dermatologo
Il dott. Magnus Lynch, dermatologo consulente al Guy's Hospital e al King's College London, ha pubblicato un test di GPT-6 Astra e Claude Fable 5.1 su 200 lesioni confermate da biopsia, estratte casualmente dal dataset pubblico MILK10k. A ciascun modello sono stati forniti una fotografia clinica e un'immagine dermoscopica, lo stesso prompt e le impostazioni predefinite; i modelli dovevano scegliere fra sei diagnosi. Il modello di confronto era Inception v3 (pubblicato nel 2015), ottimizzato con 68.011 immagini dell'ISIC Archive su una GPU H100, escludendo dal set di addestramento le lesioni del test.Moonshot lancia Kimi K3.1 Pro, con i pesi open in arrivo entro il 4 novembre
Moonshot ha annunciato Kimi K3.1 Pro, che definisce il suo modello open-weight più potente della classe 3T: un modello multimodale mixture-of-experts con 2,8T di parametri totali, 104B di parametri attivi e un contesto da 1M di token. Moonshot afferma che K3.1 Pro e K3.1 Pro Highspeed (2–3× più veloce) sono disponibili su Kimi.ai, Kimi Work, Kimi Code e tramite Kimi API (ID dei modelli kimi-k3.1-pro e kimi-k3.1-pro-highspeed). I pesi open sono previsti entro il 4 novembre 2026.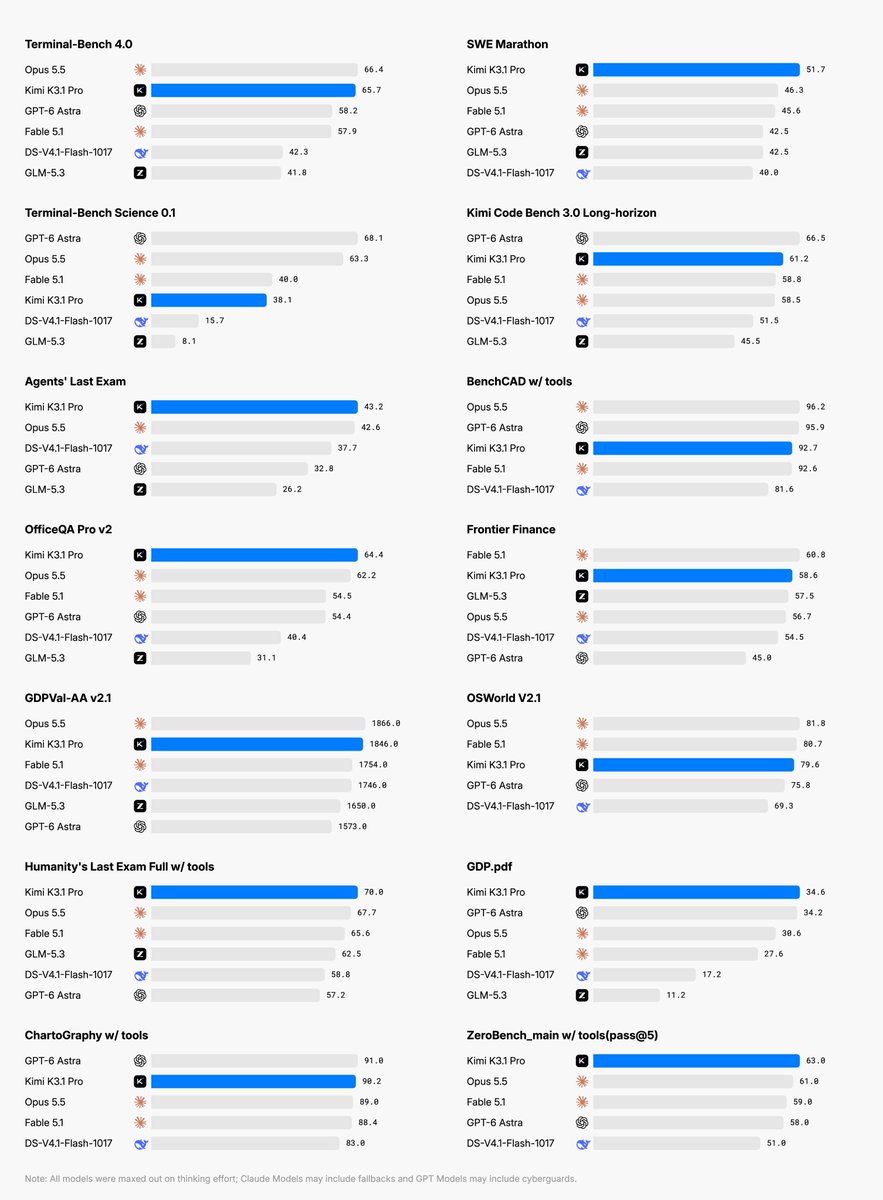
Block presenta le anteprime di Dessa, un modello speech-to-speech full-duplex
Block, la società dietro Square e Cash App, ha presentato un’anteprima di ricerca di Dessa, che definisce «il modello vocale full-duplex più autentico mai realizzato». Nell’annuncio, Jack Dorsey afferma che parlare con il modello è come parlare con una persona, con emozioni, sfumature, pause e un ritmo naturale.Google releases Gemini 4 Argon, its latest frontier model
Google released Gemini 4 Argon on October 13, 2026, and says it is available globally. Google's blog post was shared on Hacker News on October 20. The Gemini API changelog lists gemini-4-argon as generally available from October 13, describing it as Google's most capable model, built for complex coding, agentic, math and science tasks.Grok Bot 0.75.2 aggiunge schede nelle chat desktop e la generazione di video
Grok Bot 0.75.2 è disponibile, secondo un post su X di un membro del team di Grok Bot che rimanda al changelog della versione su x.ai. Il post elenca tre novità:Ideogram introduces its first vector model
Ideogram announced its first vector model on X. According to Ideogram, it generates clean, editable SVGs with smooth gradients and sharp typography from a text prompt, or turns any image into a detailed, scalable vector.
Mistral releases Voxtral 3, speech models and a voice agent SDK
Mistral announced Voxtral 3 on October 20, 2026 (shared on Hacker News, where it had 735 points and 182 comments by October 20). Details and benchmarks below are Mistral's own claims from its announcement page.
ElevenLabs opens a limited alpha of Eleven Realtime Translation
ElevenLabs announced on X on October 21, 2026 a limited alpha of Eleven Realtime Translation, which builds live voice translation into calls. It followed the launch earlier that week of Eleven Realtime, its product for voice agents that talk to people.