 AI Tracker
Nieuws over multimodaal,
voor bouwers.
Het laatste nieuws over multimodaal van elke AI-aanbieder: lanceringen, prijswijzigingen en uitfaseringen, samengevat met wat ze voor jou betekenen.
Hume lanceert de Audio Decision API, die vragen over audio in één aanroep beantwoordt
Hume zegt dat ontwikkelaars met de Audio Decision API vragen over audio kunnen stellen, zoals hoeveel sprekers er zijn, of iemand lacht en of een beller gefrustreerd is. Volgens Hume vervangt dit werk waarvoor eerder 10 of meer modellen nodig waren.Meituan brengt LongCat-2.5 uit, een multimodaal model met 1,6 biljoen parameters voor agenttaken
Meituan heeft LongCat-2.5 uitgebracht, volgens een X-post van het account leo114119 met een link naar de LongCat-blog van Meituan. In de post staat dat Meituan het omschrijft als een native multimodaal model voor agenttaken, met 1,6 biljoen parameters, dat sterk is in complexe visuele codeerprojecten en professioneel kantoorwerk, zoals creatief ontwerp, 3D-taken en bedrijfsanalyse.
Google announces Gemini 4 Carbon, its next frontier model, to cyber defenders first
Google announced Gemini 4 Carbon on October 28, 2026, calling it its strongest model, with state-of-the-art cybersecurity and long-horizon capabilities. It follows Gemini 4 Argon by two weeks. Sundar Pichai's post and Google's blog say it is not yet generally available: starting this week a subset of cyber defenders get access, with more trusted partners added through the Fairwind Program. Google says it will bring Carbon to developers, businesses and consumers "as soon as possible", and that it is taking part in the U.S. government's voluntary process for pre-release model testing.
Hex, een lokale app voor spraakinvoer om met codeeragents te praten, bereikt een stabiele release
Het OpenCode-account meldde op 31 oktober op X dat er een stabiele release van Hex beschikbaar is. Het omschrijft Hex als een snelle, lokaal draaiende manier om via spraak met elke agent te praten, die werkt op Mac, Windows en Linux. Het bericht linkt naar anoma.ly/hex.OpenCode 2.2.3 voegt een tool voor beeldgeneratie toe
Het OpenCode-account meldde op 30 oktober op X dat OpenCode 2.2.3 een tool voor beeldgeneratie heeft die beeldmodellen van OpenAI, Gemini, Grok en andere aanbieders ondersteunt. Het raadt aan de tool te gebruiken voor conceptuele UI of referentiebeelden voor videogames.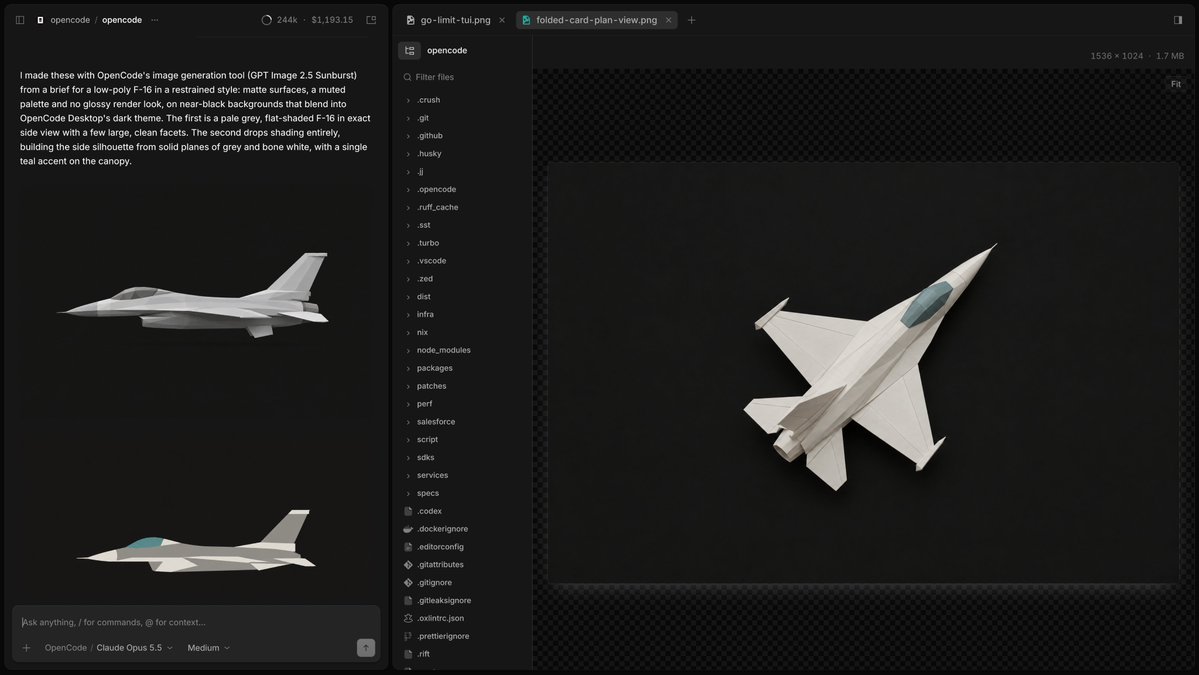
ElevenLabs brengt SFX v3 uit, een model voor geluidseffecten dat prompts met meerdere onderdelen volgt
ElevenLabs heeft SFX v3 uitgebracht, zijn nieuwste model voor geluidseffecten. Het bedrijf zegt dat het model rijkere, nauwkeurigere geluidseffecten maakt op basis van één tekstprompt, meerdere instructies in één prompt betrouwbaarder opvolgt (bijvoorbeeld: een juichende menigte, een vallende bal en daarna een joelende menigte) en verbeterde muziek en zang biedt.PokeBot lanceert RoboAPI, een API waarmee robotarmen instructies in natuurlijke taal krijgen
PokeBot introduceerde RoboAPI op 29 oktober. De API wordt aangedreven door Poke-Aurora, dat het bedrijf zijn world-action-model noemt. Volgens PokeBot kunnen compatibele robots via een eenvoudige API instructies in natuurlijke taal krijgen, zonder taakspecifieke training.Pika lanceert H3 Flex, een snel videomodel dat volgens het bedrijf het beste open-weight tekst-naar-videomodel op DesignArena is
Pika introduceerde H3 Flex, dat volgens het bedrijf debuteert als het #1 open-weightmodel op het tekst-naar-videobord van DesignArena (een claim van Pika). Het bedrijf beschrijft het model als ontworpen voor professionele iteratie: exporteerbare audiosporen, resoluties tot 4K en generatie sneller dan realtime, met een clip van 15 seconden en soundtrack in slechts 7 seconden.Phonic 1 debuteert op #1 in de Speech to Speech Index van Artificial Analysis
Artificial Analysis (een benchmarksite, met eigen metingen) meldt dat Phonic 1 (High), het speech-to-speech-model van Phonic, met een score van 87,1 op #1 van de 22 staat in de Speech to Speech Index, nipt vóór Grok Voice 3.0 (86,9). Het model is beschikbaar via de Phonic API voor $0,07 per minuut.Fish Audio brengt Drama 3 uit, dat volgens Artificial Analysis op nummer 1 staat onder open-weight-spraakmodellen
Fish Audio heeft Drama 3 uitgebracht, met de gewichten op Hugging Face. Artificial Analysis (een benchmarksite, gebaseerd op eigen metingen) zegt dat het model op beide spraakarena's van de site het #1 open-weight-model is en op de benchmark Pronunciation Robustness op #1 staat van alle modellen.Artificial Analysis toont AA-Robotics v0.1, een benchmark voor modellen die een robotarm aansturen
Artificial Analysis heeft AA-Robotics v0.1 gepubliceerd, waarbij modellen een robotarm aansturen en de taak vanuit het perspectief van het model wordt getoond. In een voorbeeld waarin dezelfde robot "hello world" schrijft, zegt Artificial Analysis dat Claude Opus 5.5 de tekst punt voor punt met deppen schreef, met 3,270 armbewegingen in 34 minuten, terwijl GPT-6 Astra in doorlopende halen schreef, met 514 bewegingen in 13 minuten.ElevenLabs introduceert Cue, een model voor geforceerde uitlijning
ElevenLabs Research heeft Cue geïntroduceerd, een model voor geforceerde uitlijning: de stap waarbij een transcript wordt omgezet in tijdstempels, gebruikt voor ondertiteling, nasynchronisatie en aanklikbare transcripten. Het koppelt elk teken aan een moment op de audiotijdlijn.Rime lance Prism, un modèle de parole à parole pour les agents vocaux
Rime a lancé Prism, un modèle de parole à parole destiné aux agents vocaux IA. Les chiffres ci-dessous sont des affirmations de Rime, et non des mesures indépendantes.Artificial Analysis lanceert AA-Video-I2V v2.1, een benchmark voor image-to-video-modellen
Artificial Analysis heeft AA-Video-I2V v2.1 en AA-Video-I2V-Silent v2.1 gelanceerd, benchmarks voor image-to-video-modellen. Elke prompt koppelt een startafbeelding in 1080p aan een prompt die ervoor is geschreven en is getagd op gebruikssituatie, capaciteit en visuele stijl; modellen worden beoordeeld tot maximaal 1080p en gerangschikt in 10 gebruikssituaties en 10 capaciteiten. De totaalscore wordt berekend op basis van een gelijk aantal voorbeelden uit elk onderdeel. De resultaten zijn van Artificial Analysis zelf.
OpenBMB brengt MiniCPM-OCR uit, een documentparser van 1B, met een model van 2B dat OCR-resultaten beoordeelt
OpenBMB liet MiniCPM-OCR op 28 oktober op X zien, lokaal draaiend op een iPhone en een iPad. Het is uitgebracht met open gewichten en kan draaien met llama.cpp, vLLM, SGLang of Ollama; de fine-tuningcode is open source en OpenBMB biedt ook een demo en een API aan.AssemblyAI lanceert zijn eerste tekst-naar-spraakmodel, AssemblyAI-TTS-1
AssemblyAI heeft AssemblyAI-TTS-1 gelanceerd, zijn eerste tekst-naar-spraakmodel, ontwikkeld voor spraakagents. Volgens AssemblyAI streamt het model in 90 ms voor $15 per miljoen tekens. Het bedrijf noemt het het beste TTS-model dat je op schaal kunt inzetten als je nauwkeurigheid, natuurlijkheid en kosten samen in aanmerking neemt. OpenRouter meldt dat het model daar beschikbaar is, met meer dan 4.000 stemmen die vanuit de VS of de EU worden aangeboden.