AI Tracker
Nieuws over multimodaal,
voor bouwers.
Het laatste nieuws over multimodaal van elke AI-aanbieder: lanceringen, prijswijzigingen en uitfaseringen, samengevat met wat ze voor jou betekenen.
Liquid AI introduceert LFM3: zes kleine modellen voor tekst, beeld, audio en omni
Liquid AI heeft LFM3 aangekondigd, een nieuwe generatie Liquid Foundation Models op basis van wat het bedrijf een nieuwe tri-hybride architectuur noemt, met nieuwe multimodale encoders. Volgens Liquid is de architectuur geoptimaliseerd voor 14 processorklassen op GPU's, CPU's en NPU's, en kunnen de modellen op één GPU worden gefinetuned.Google DeepMind introduceert Genie 4, een interactief wereldmodel dat in realtime werkt
Google DeepMind kondigde Genie 4 aan op 27 oktober 2026 en noemde het zijn meest realistische en interactieve wereldmodel tot nu toe. In de blogpost zegt DeepMind dat gebruikers dynamische omgevingen in realtime kunnen verkennen en kunnen zien hoe de scène reageert, klinkt en hoe de mensen erin bewegen, reageren en spreken. Het publiceerde een blogpost met de titel „Genie 4: a new generation of world simulation”.MAI-Image-2.7-Preview van Microsoft staat op #2 voor beeldbewerking bij Artificial Analysis
Artificial Analysis meldt dat MAI-Image-2.7-Preview van Microsoft AI, het nieuwste model voor beeldbewerking en de opvolger van MAI-Image-2.6 (uitgebracht in augustus), de tweede plaats behaalt op het AA-Image-Editing v2.1-klassement, vlak achter OpenAI's GPT Image 2.5 Sunburst (max). De resultaten zijn afkomstig van Artificial Analysis zelf.SenseTime reportedly open-sources SenseNova 6.8 Code2Video, a 27B code-to-video model
A Chinese AI blogger reports that SenseTime open-sourced SenseNova 6.8 Code2Video on October 27, with weights on Hugging Face under sensenova/SenseNova-6.8-Code2Video. The report is second-hand; SenseTime's own announcement is not cited.Maya-2, een stemmodel voor Indiase talen, uitgebracht met open weights
Maya-2, een stemmodel (spraaksynthetisatie) gericht op India, is op 27 oktober met open weights gepubliceerd onder de Hugging Face-naam maya-research/maya2-native. De aankondiging op X zegt dat het model meer dan 1,5 miljard mensen in alle 28 deelstaten en 8 unieterritoria bereikt.
Baidu maakt Unlimited OCR 2 open source, een documentparser met vrijwel constante decodeerkosten
Baidu kondigde Unlimited OCR 2 op 26 oktober aan op X, met de code op GitHub en de gewichten op Hugging Face. Het model is ontworpen om documenten van vrijwel elke lengte te verwerken binnen een contextvenster van beperkte omvang.Artificial Analysis lance Code2Video-AA, un benchmark de vidéos marketing créées en code
Artificial Analysis a présenté Code2Video-AA, sa propre implémentation de Code2Video Bench de HeyGen, développée en partenariat avec HeyGen. Les modèles reçoivent 114 briefs de marketing produit et de marque et doivent répondre à chacun avec une composition HTML HyperFrames en une seule réponse, sans outils ; la composition est rendue en vidéo sans accès au réseau. Un modèle évaluateur (Gemini 4 Argon, high) compare les vidéos deux à deux selon l’engagement, le respect de l’intention du prompt, la composition, la cohérence temporelle et la qualité d’exécution. Les notes Elo des cinq axes sont moyennées pour obtenir le score principal. Plus de 35 000 évaluations classent 27 modèles. Ces résultats sont ceux d’Artificial Analysis.Een gefinetunede CNN uit 2015 verslaat GPT-6 Astra en Claude Fable 5.1 bij het herkennen van huidlaesies, meldt een dermatoloog
Dr. Magnus Lynch, consulent-dermatoloog bij Guy's Hospital en King's College London, publiceerde een test van GPT-6 Astra en Claude Fable 5.1 op 200 bioptbevestigde laesies, willekeurig geselecteerd uit de openbare dataset MILK10k. Elk model kreeg een klinische foto en een dermatoscopisch beeld, dezelfde prompt en de standaardinstellingen, en koos uit zes diagnoses. Het vergelijkingsmodel was Inception v3 (gepubliceerd in 2015), gefinetuned op 68.011 beelden uit het ISIC Archive op één H100-GPU; de testlaesies waren uit de trainingsdata verwijderd.Moonshot lanceert Kimi K3.1 Pro; open weights verschijnen uiterlijk 4 november
Moonshot kondigde Kimi K3.1 Pro aan, dat het zijn krachtigste open-weightmodel in de 3T-klasse noemt: een multimodaal mixture-of-experts-model met in totaal 2,8T en 104B actieve parameters, en een context van 1M tokens. Moonshot zegt dat K3.1 Pro en K3.1 Pro Highspeed (2–3× sneller) beschikbaar zijn op Kimi.ai, Kimi Work, Kimi Code en de Kimi API (model-id's kimi-k3.1-pro en kimi-k3.1-pro-highspeed). Open weights zijn beloofd voor uiterlijk 4 november 2026.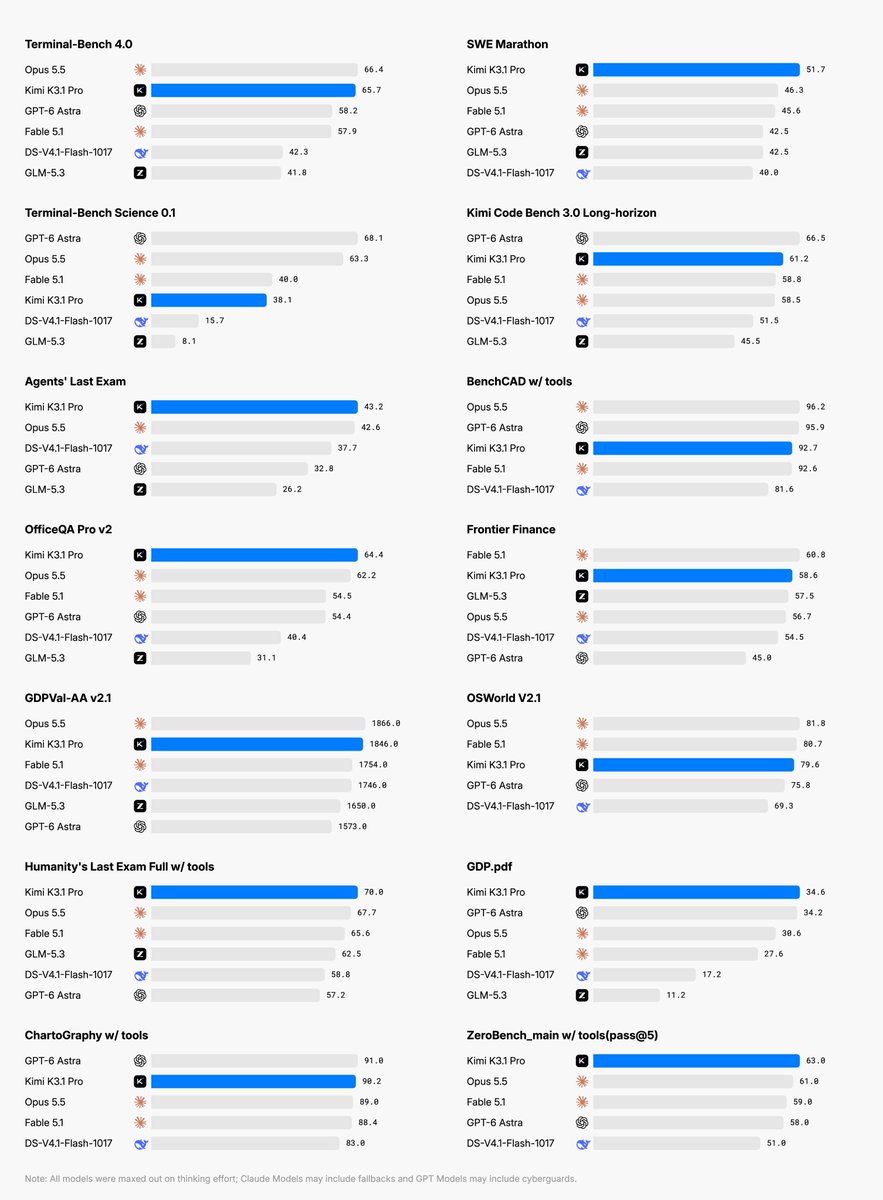
Block presenteert Dessa, een full-duplex spraak-naar-spraakmodel
Block, het bedrijf achter Square en Cash App, introduceerde een onderzoeksvoorbeeld van Dessa, dat het "het meest authentieke full-duplex spraakmodel ooit gebouwd" noemt. In de aankondiging van Jack Dorsey staat dat praten met het model voelt als praten met een persoon, met emotie, nuance, pauzes en een natuurlijk ritme.Google releases Gemini 4 Argon, its latest frontier model
Google released Gemini 4 Argon on October 13, 2026, and says it is available globally. Google's blog post was shared on Hacker News on October 20. The Gemini API changelog lists gemini-4-argon as generally available from October 13, describing it as Google's most capable model, built for complex coding, agentic, math and science tasks.Grok Bot 0.75.2 voegt kaarten toe aan desktopchats en genereert video’s
Grok Bot 0.75.2 is uitgebracht, volgens een bericht op X van een teamlid van Grok Bot dat linkt naar het wijzigingslogboek van de release op x.ai. In het bericht staan drie wijzigingen:Ideogram introduces its first vector model
Ideogram announced its first vector model on X. According to Ideogram, it generates clean, editable SVGs with smooth gradients and sharp typography from a text prompt, or turns any image into a detailed, scalable vector.
Mistral releases Voxtral 3, speech models and a voice agent SDK
Mistral announced Voxtral 3 on October 20, 2026 (shared on Hacker News, where it had 735 points and 182 comments by October 20). Details and benchmarks below are Mistral's own claims from its announcement page.
ElevenLabs opens a limited alpha of Eleven Realtime Translation
ElevenLabs announced on X on October 21, 2026 a limited alpha of Eleven Realtime Translation, which builds live voice translation into calls. It followed the launch earlier that week of Eleven Realtime, its product for voice agents that talk to people.