AI Tracker
Infrastruktura: wiadomości
dla twórców.
Najnowsze wiadomości z kategorii „Infrastruktura” od każdego dostawcy AI: premiery, zmiany cen i wycofania, w skrócie i z tym, co oznaczają dla Ciebie.
Microsoft przenosi harness Copilota do Foundry Agent Service
Microsoft wprowadził harness Microsoft Copilot w Foundry Agent Service. Firma twierdzi, że zespół inżynierów GitHub zbudował wielomodelowy harness, który Microsoft wdrożył już w swoich produktach, a wersja w Foundry pozwala deweloperom tworzyć agentów bez ponownego budowania warstwy wykonawczej. Według Microsoftu harness obsługuje orkiestrację, narzędzia, kontekst i mechanizmy kontroli, dzięki czemu deweloperzy mogą skupić się na umiejętnościach i rezultatach działania swoich agentów. Microsoft opublikował film demonstracyjny i wpis na blogu Foundry.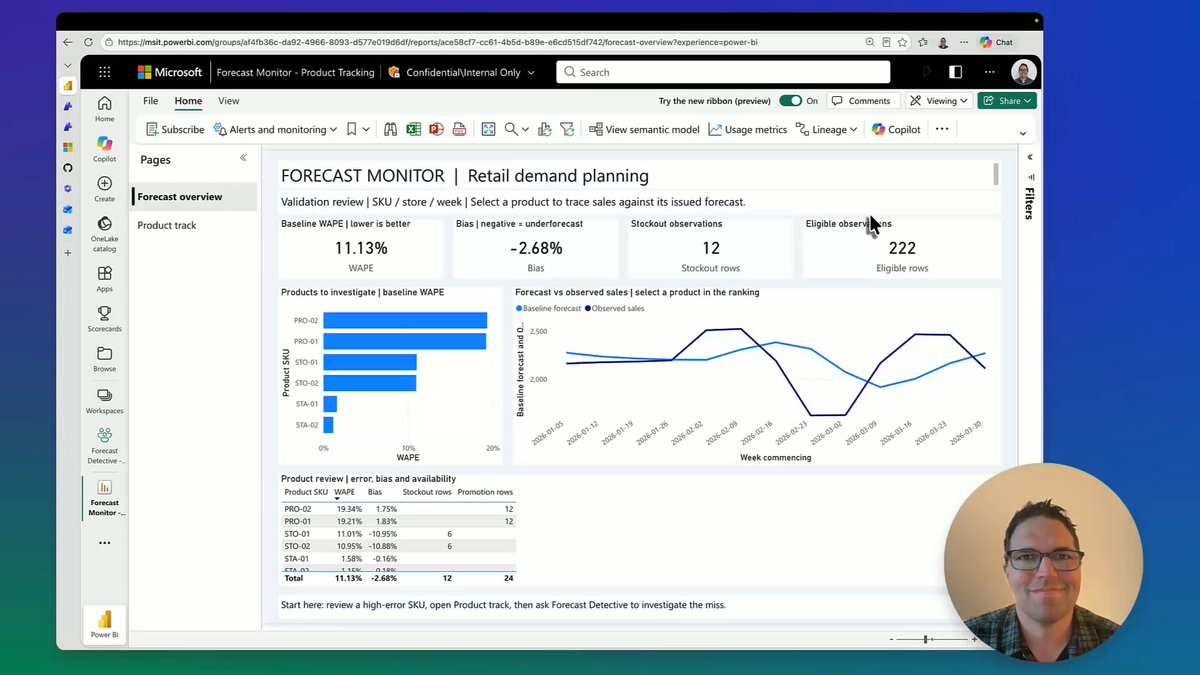
Vercel AI Gateway dodaje 14 modeli ElevenLabs, 50% taniej do 9 listopada
Vercel informuje, że 14 modeli ElevenLabs jest już dostępnych w AI Gateway, ujednoliconym punkcie dostępu do modeli różnych dostawców, i że do 9 listopada są one o 50% tańsze. Według Vercel oferta obejmuje agentów głosowych działających w czasie rzeczywistym, muzykę, efekty dźwiękowe, dialogi z wieloma głosami, strumieniowe przesyłanie mowy przez WebSockets oraz zamianę mowy na tekst.HarnessAgent od Vercel obsługuje teraz obrazy jako dane wejściowe
Vercel informuje, że HarnessAgent obsługuje teraz obrazy jako dane wejściowe we wszystkich adapterach harness. Obrazy przekazuje się wraz z tekstem w standardowym formacie wiadomości AI SDK, a według Vercel resztą zajmuje się bazowy model wizyjny każdego harnessu. Szczegóły można znaleźć we wpisie w changelogu Vercel.Parallel udostępnia Decisions API, które opiera modele decyzyjne na aktualnych danych z sieci i kosztuje 0,001 USD za żądanie
Parallel ogłosił Decisions API na X 27 października i informuje, że usługa jest już dostępna. Firma nazywa ją „pierwszym silnikiem decyzyjnym opartym na danych z sieci”: modele decyzyjne, takie jak Jev, odpowiadają natychmiast, ale nie uwzględniają najnowszych wiadomości, a nowe API łączy oba te aspekty w jednym wywołaniu. To własne twierdzenie Parallel.
Logan Graham z Anthropic koryguje relację „The Washington Post” o włamaniu do Cathedral
Logan Graham z Frontier Red Team Anthropic opublikował 26 października na X sprostowanie dotyczące artykułu „The Washington Post” i reakcji na niego. Według artykułu agenci AI startupu zajmującego się bezpieczeństwem dostali się do systemów Anthropic w mniej niż 12 godzin. Oto jego wypowiedzi, a nie komunikat Anthropic:Cloudflare informuje, że niezgodność konfiguracji GLM 5.3 w Workers AI spowodowała ujawnienie stron pamięci podręcznej KV między żądaniami
26 października Cloudflare opublikowało ujawnienie problemu i opis jego naprawy. Firma poinformowała, że niezgodność konfiguracji GLM 5.3 (@cf/zai-org/glm-5.3) w Workers AI wywołała błąd w SGLang, silniku inferencyjnym, który ujawniał strony pamięci podręcznej KV między żądaniami. Ujawnienie skoordynowano z wpisem SGLang.Testy ewaluacyjne AgentEnv od Scale AI można teraz uruchamiać w Vercel Sandbox
Vercel informuje, że testy ewaluacyjne AgentEnv od Scale AI Labs można teraz uruchamiać w Vercel Sandbox. Przydzielasz agentowi zadanie, uruchamiasz go w piaskownicy i sprawdzasz, jak sobie poradził. Vercel opublikował wpis w changelogu oraz instrukcję konfiguracji w dokumentacji Sandbox.Polecenia Vercel Sandbox obsługują teraz stdin
Vercel informuje, że polecenia uruchamiane w Vercel Sandbox mogą teraz przyjmować dane wejściowe przez stdin. Dzięki temu można przekazywać dane działającym narzędziom CLI i serwerom MCP korzystającym ze stdio, takim jak agent-browser, wewnątrz sandboxa. Szczegóły opisano we wpisie w changelogu Vercel.Gemini API domyślnie przechowuje teraz żądania Generate Content w płatnym planie
Z dziennika zmian Gemini API od Google wynika, że nowe projekty korzystające z Generate Content API (generateContent, streamGenerateContent i batchGenerateContent) w płatnym planie domyślnie przechowują teraz żądania (store=true), tak jak Interactions API. Dotychczasowe projekty zachowują obecne ustawienia.Washington Post reports a security startup's AI agents got into Anthropic's internal systems in under 12 hours
Elizabeth Dwoskin of The Washington Post posted on October 26 an exclusive saying that a group of former DOGE cyber researchers used AI agents to penetrate Anthropic's systems in less than 12 hours, including Slack channels where the company's most sensitive models are discussed. Her post ties the story to a recent charge by Anthropic whistleblower Joseph Coxon.Together AI udostępnia MiniMax M3.1 Flash do dalszego trenowania
Together AI informuje, że MiniMax M3.1 Flash jest już dostępny do dalszego trenowania na jej platformie. Według Together użytkownicy mogą przeprowadzać nadzorowane dostrajanie (SFT) lub uczenie ze wzmocnieniem (RL) na własnych danych, z własnymi funkcjami nagrody i środowiskami, zachowując pętlę treningową we własnym kodzie Python.Sprzedawca twierdzi, że ma bazę użytkowników i klucze API OpenRouter; OpenRouter nie znajduje na to dowodów
Konto wywiadu o zagrożeniach DailyDarkWeb poinformowało 25 października, że sprzedawca na forum w podziemiu internetowym twierdzi, iż oferuje bazę danych powiązaną z openrouter.ai. Według konta sprzedawca twierdzi, że baza zawiera:Badaczka ujawnia 11 niezałatanych luk w Tailscale i headscale, głównie w Tailscale SSH
Erica Windisch z Cyberdione Labs opublikowała 11 ustaleń pod nazwą Tailworm (tailworm.com) bez skoordynowanego ujawnienia, przez co dostawca nie miał czasu wcześniej przygotować poprawek. Do 25 października nie zgłoszono żadnych poprawek ani CVE.
SGLang twierdzi, że dorównał silnikowi DeepInfer firmy DeepSeek na DeepSeek-V4.1-Flash
Projekt SGLang twierdzi, że jego silnik wnioskowania dorównuje teraz DeepInfer, własnemu silnikowi DeepSeek, zarówno w fazie prefill, jak i dekodowania dla DeepSeek-V4.1-Flash. Kilka godzin po podobnym oświadczeniu vLLM SGLang poinformował o przepustowości prefill do 1.04× większej niż w DeepInfer na 4× GB300 i 4× B300 oraz o przepustowości dekodowania do 7.4% na 64× GB300.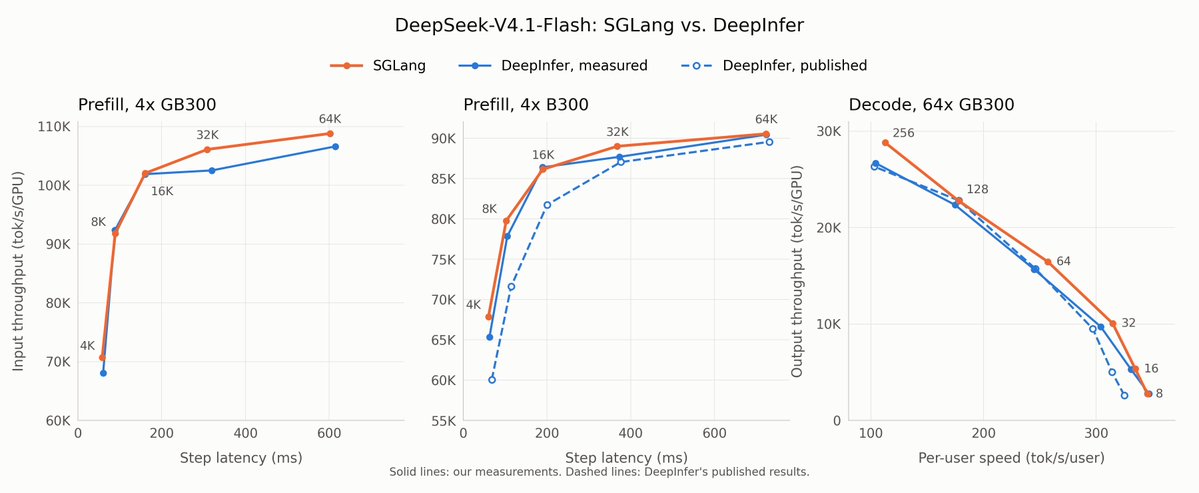
vLLM twierdzi, że dorównał silnikowi DeepSeek-V4.1-Flash, DeepInfer, pod względem wydajności
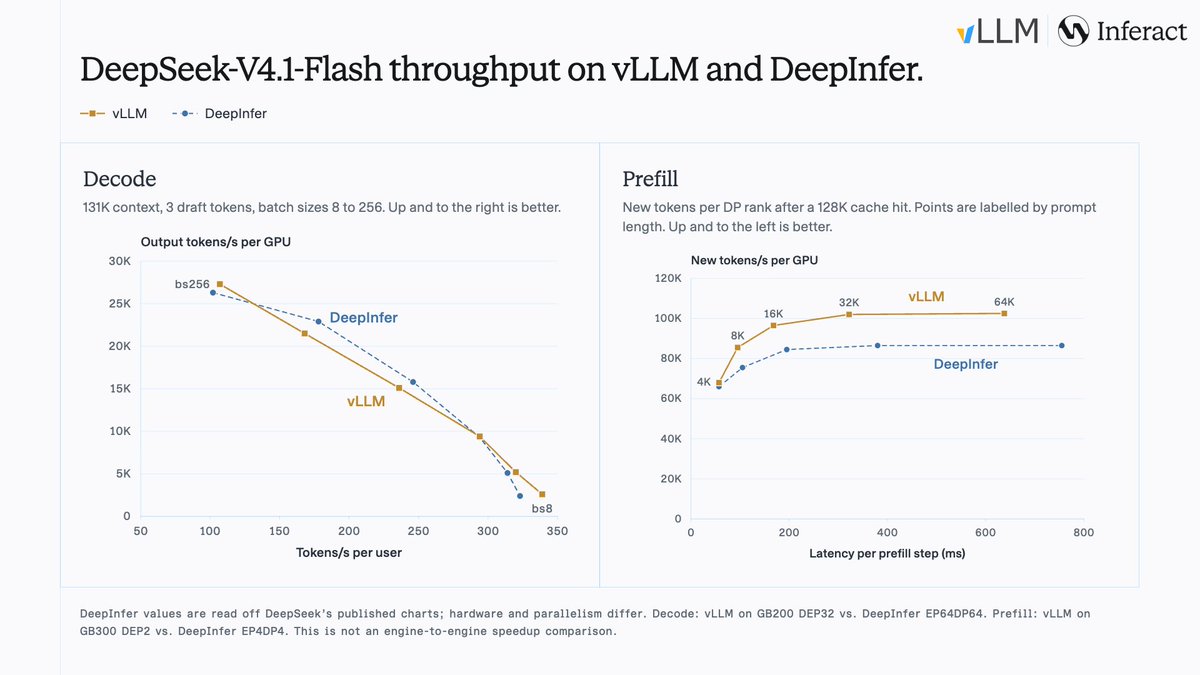
Projekt vLLM twierdzi, że jego silnik inferencyjny dorównał DeepInfer, autorskiemu silnikowi DeepSeek dla DeepSeek-V4.1-Flash, w konfiguracji dekodowania DeepSeek przy rozmiarach batcha od 8 do 256. Według projektu osiąga to przy DEP32 (uwaga równoległa z podziałem danych i równoległością ekspertów na 32 GPU), podczas gdy DeepInfer działa w konfiguracji EP64DP64.