 AI Tracker
vLLM twierdzi, że dorównał silnikowi DeepSeek-V4.1-Flash, DeepInfer, pod względem wydajności
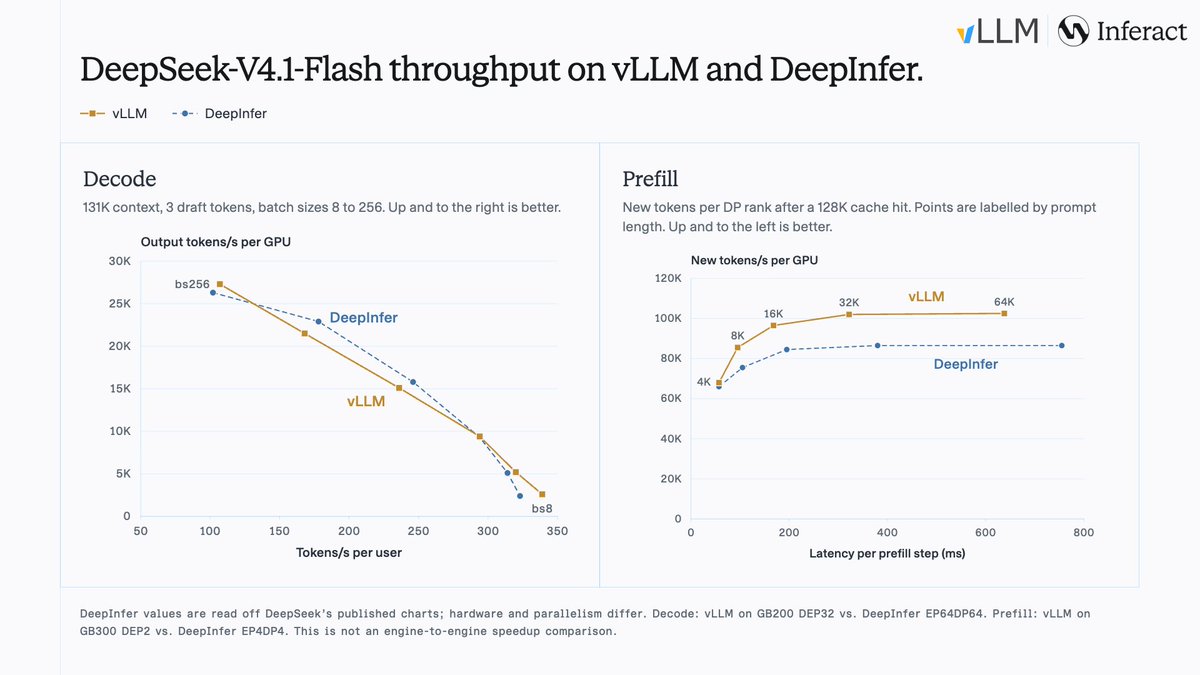
Projekt vLLM twierdzi, że jego silnik inferencyjny dorównał DeepInfer, autorskiemu silnikowi DeepSeek dla DeepSeek-V4.1-Flash, w konfiguracji dekodowania DeepSeek przy rozmiarach batcha od 8 do 256. Według projektu osiąga to przy DEP32 (uwaga równoległa z podziałem danych i równoległością ekspertów na 32 GPU), podczas gdy DeepInfer działa w konfiguracji EP64DP64.
Według vLLM DeepInfer pierwotnie powstał na bazie vLLM, a uzyskane wyniki osiągnięto dzięki integracji otwartoźródłowych kerneli DeepSeek oraz szeroko zakrojonej optymalizacji prefill i dekodowania. W poście zamieszczono wykres wydajności; podane wartości pochodzą od vLLM i nie zostały niezależnie zweryfikowane. Do 24 października post miał około 307 polubień na X.
Źródła
Otrzymuj takie wiadomości jako push.
AI Tracker powiadomi Cię, gdy coś zmieni się w narzędziach, których używasz.