 AI Tracker
vLLM afirma que ahora iguala al motor DeepInfer de DeepSeek en DeepSeek-V4.1-Flash
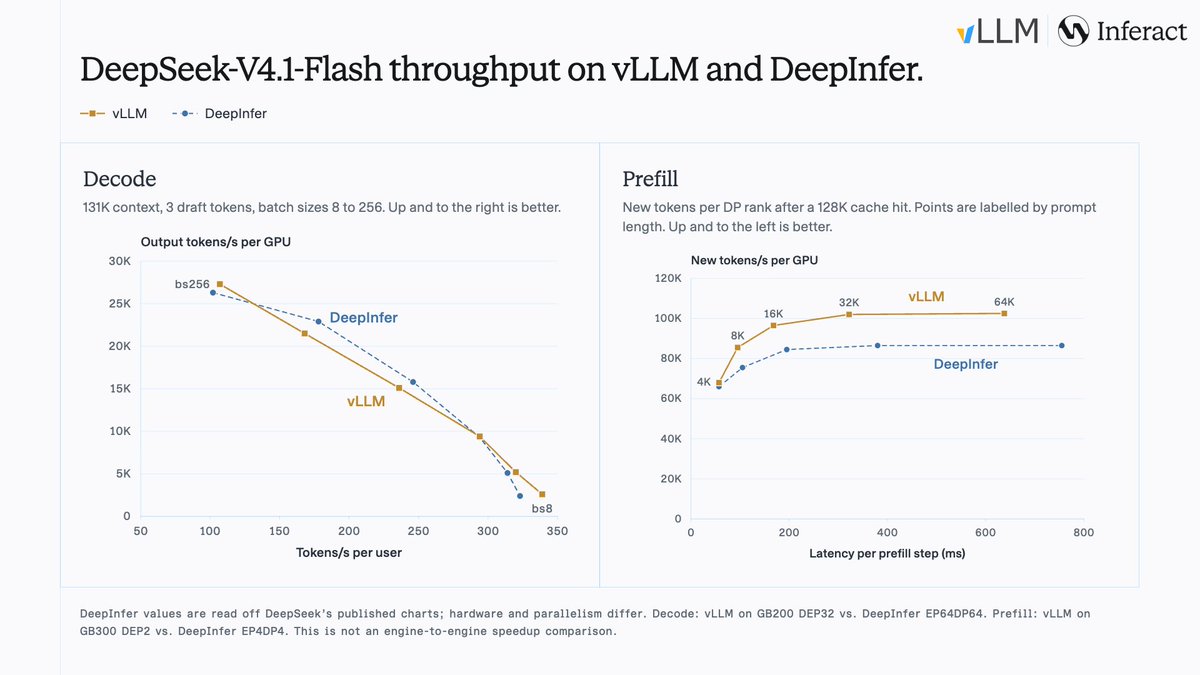
El proyecto vLLM afirma que su motor de inferencia ahora iguala a DeepInfer, el motor propio de DeepSeek para DeepSeek-V4.1-Flash, con la configuración de decodificación de DeepSeek para tamaños de lote de 8 a 256. Según el proyecto, lo consigue con DEP32 (atención paralela de datos con paralelismo de expertos en 32 GPU), frente a la configuración EP64DP64 de DeepInfer.
Según vLLM, DeepInfer se creó originalmente sobre vLLM, y alcanzó estos resultados al integrar los kernels de código abierto de DeepSeek y optimizar ampliamente el prellenado y la decodificación. La publicación incluye un gráfico de rendimiento; las cifras son de vLLM y no se han verificado de forma independiente. Para el 24 de octubre, la publicación tenía unos 307 Me gusta en X.
Fuentes
Recibe noticias como esta por push.
AI Tracker te avisa cuando algo cambia en las herramientas que usas.