 AI Tracker
vLLM menyatakan kini menyamai engine DeepInfer milik DeepSeek pada DeepSeek-V4.1-Flash
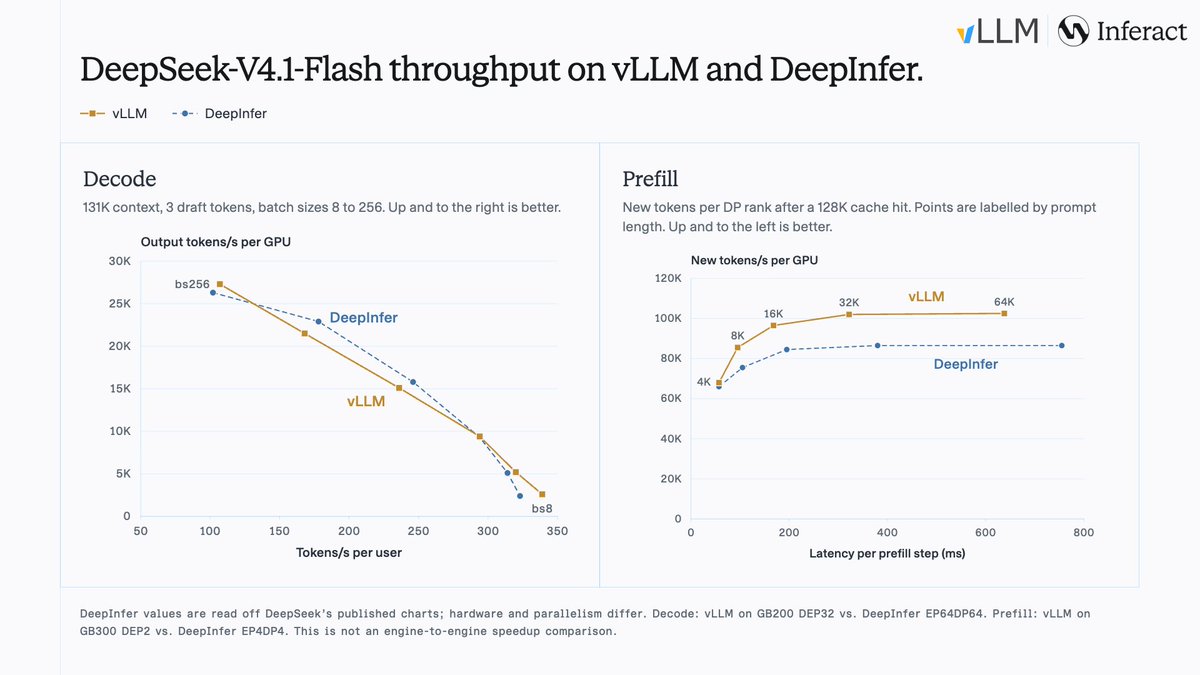
Proyek vLLM menyatakan bahwa engine inferensinya kini menyamai DeepInfer, engine milik DeepSeek untuk DeepSeek-V4.1-Flash, pada konfigurasi decode DeepSeek untuk ukuran batch 8 hingga 256. vLLM menyatakan pencapaian ini diraih pada DEP32 (atensi paralel data dengan paralelisme pakar di 32 GPU), dibandingkan dengan konfigurasi EP64DP64 milik DeepInfer.
Menurut vLLM, DeepInfer awalnya dibangun di atas vLLM, dan hasil ini dicapai dengan mengintegrasikan kernel sumber terbuka DeepSeek serta mengoptimalkan prefill dan decode secara ekstensif. Postingan tersebut menyertakan grafik performa; angka-angka itu berasal dari vLLM sendiri dan belum diperiksa secara independen. Hingga 24 Oktober, postingan tersebut mendapat sekitar 307 suka di X.
Sumber
Dapatkan berita seperti ini lewat push.
AI Tracker memberi tahu Anda saat ada perubahan pada alat yang Anda pakai.