 AI Tracker
vLLM afferma di essere ora alla pari con il motore DeepInfer di DeepSeek su DeepSeek-V4.1-Flash
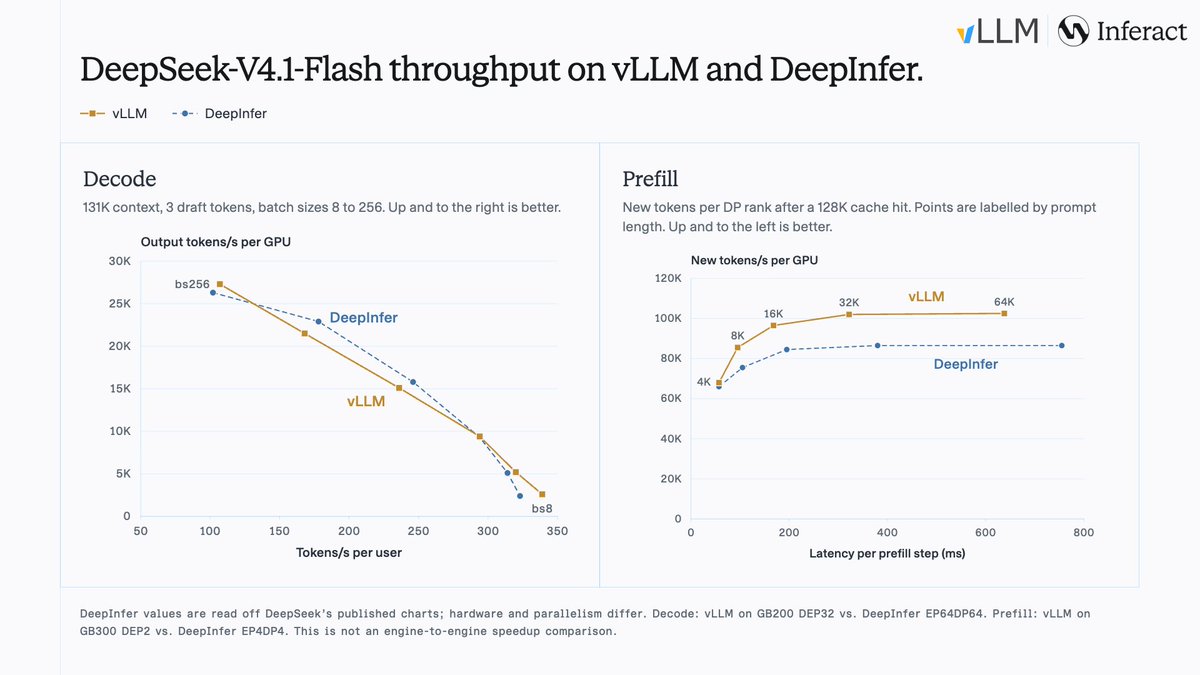
Il progetto vLLM afferma che il suo motore di inferenza è ora alla pari con DeepInfer, il motore sviluppato da DeepSeek per DeepSeek-V4.1-Flash, nella configurazione di decodifica di DeepSeek, con batch size da 8 a 256. Secondo il progetto, ci riesce con DEP32 (attenzione in parallelo sui dati con parallelismo degli esperti su 32 GPU), rispetto alla configurazione EP64DP64 di DeepInfer.
Secondo vLLM, DeepInfer è stato inizialmente sviluppato a partire da vLLM e ha raggiunto questi risultati integrando i kernel open source di DeepSeek e ottimizzando ampiamente prefill e decodifica. Il post include un grafico delle prestazioni; i dati sono quelli forniti da vLLM e non sono stati verificati in modo indipendente. Al 24 ottobre, il post aveva circa 307 Mi piace su X.
Fonti
Ricevi notizie come questa via push.
AI Tracker ti avvisa quando cambia qualcosa negli strumenti che usi.