 AI Tracker
vLLM zegt dat het DeepSeek's DeepInfer-engine nu evenaart op DeepSeek-V4.1-Flash
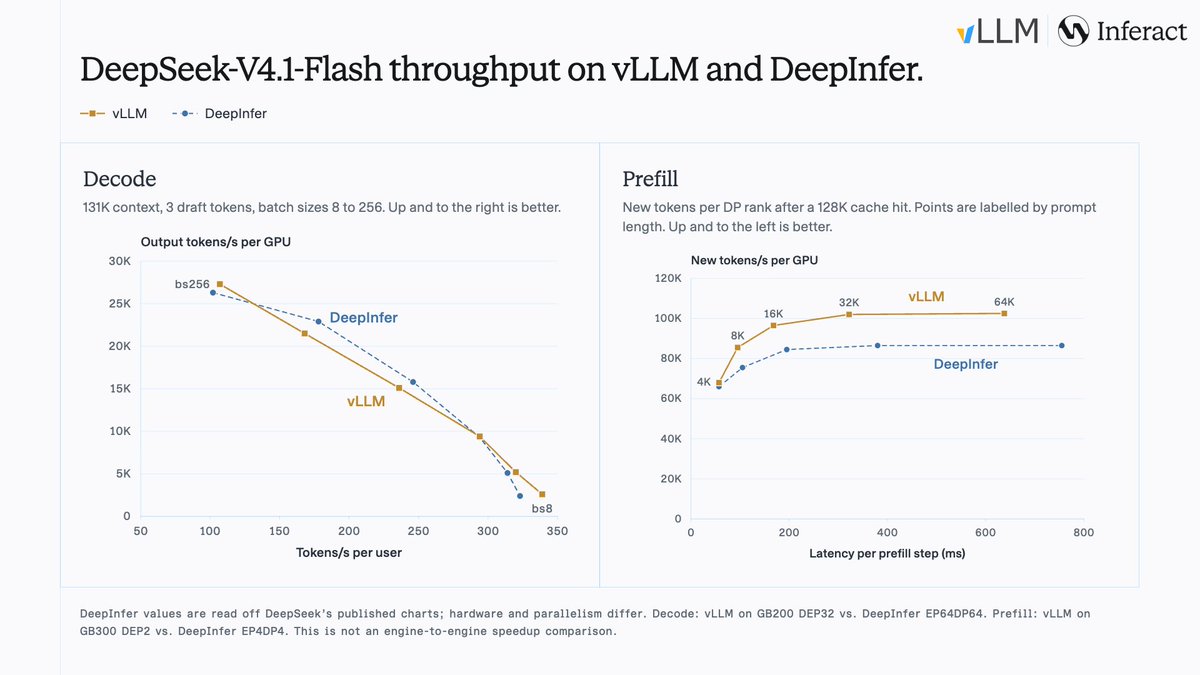
Het vLLM-project zegt dat zijn inferentie-engine DeepInfer, DeepSeek's eigen engine voor DeepSeek-V4.1-Flash, nu evenaart met DeepSeek's decodeconfiguratie voor batchgroottes van 8 tot 256. Volgens het project lukt dat met DEP32 (data-parallel attention met expertparallelisme over 32 GPU's), tegenover DeepInfer's EP64DP64-configuratie.
Volgens vLLM is DeepInfer oorspronkelijk gebouwd op vLLM. Het project bereikte deze resultaten door de opensourcekernels van DeepSeek te integreren en prefill en decode uitgebreid te optimaliseren. Het bericht bevat een prestatiediagram; de cijfers zijn afkomstig van vLLM zelf en zijn niet onafhankelijk gecontroleerd. Het bericht had op 24 oktober ongeveer 307 likes op X.
Bronnen
Krijg nieuws als dit als pushmelding.
AI Tracker waarschuwt je zodra er iets verandert aan de tools die je gebruikt.