 AI Tracker
vLLM zufolge erreicht es jetzt bei DeepSeek-V4.1-Flash die Leistung von DeepSeeks Inferenz-Engine DeepInfer
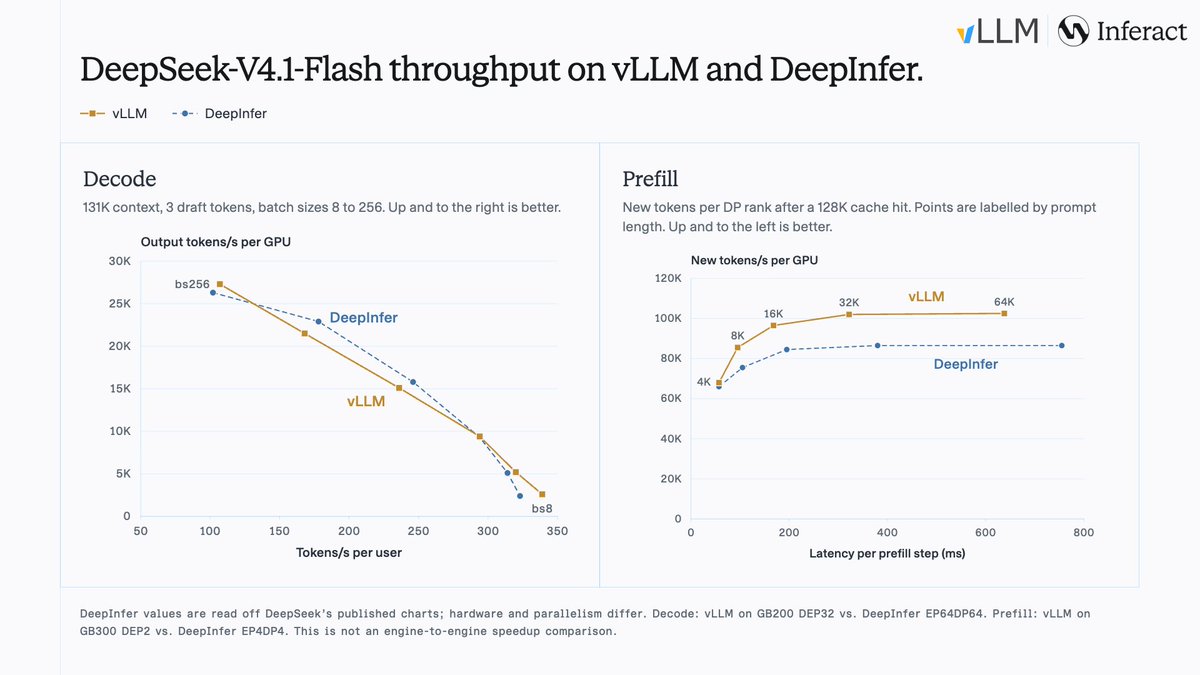
Das vLLM-Projekt gibt an, dass seine Inferenz-Engine bei DeepSeek-V4.1-Flash mit DeepInfer, DeepSeeks eigener Engine, bei DeepSeeks Decode-Konfiguration und Batchgrößen von 8 bis 256 gleichzieht. Laut vLLM gelingt das mit DEP32 (Datenparallelismus bei der Attention und Expertenparallelismus über 32 GPUs), während DeepInfer EP64DP64 verwendet.
Laut vLLM wurde DeepInfer ursprünglich auf vLLM aufgebaut. Die nun erzielten Ergebnisse seien durch die Integration von DeepSeeks Open-Source-Kernels und umfangreiche Optimierungen von Prefill und Decode möglich geworden. Der Beitrag enthält ein Performance-Diagramm; die Zahlen stammen von vLLM selbst und wurden nicht unabhängig überprüft. Bis zum 24. Oktober hatte der Beitrag auf X etwa 307 Likes.
Quellen
News wie diese als Push.
AI Tracker benachrichtigt dich, wenn sich bei deinen Tools etwas ändert.