 AI Tracker
vLLM заявляет, что теперь не уступает движку DeepSeek DeepInfer на DeepSeek-V4.1-Flash
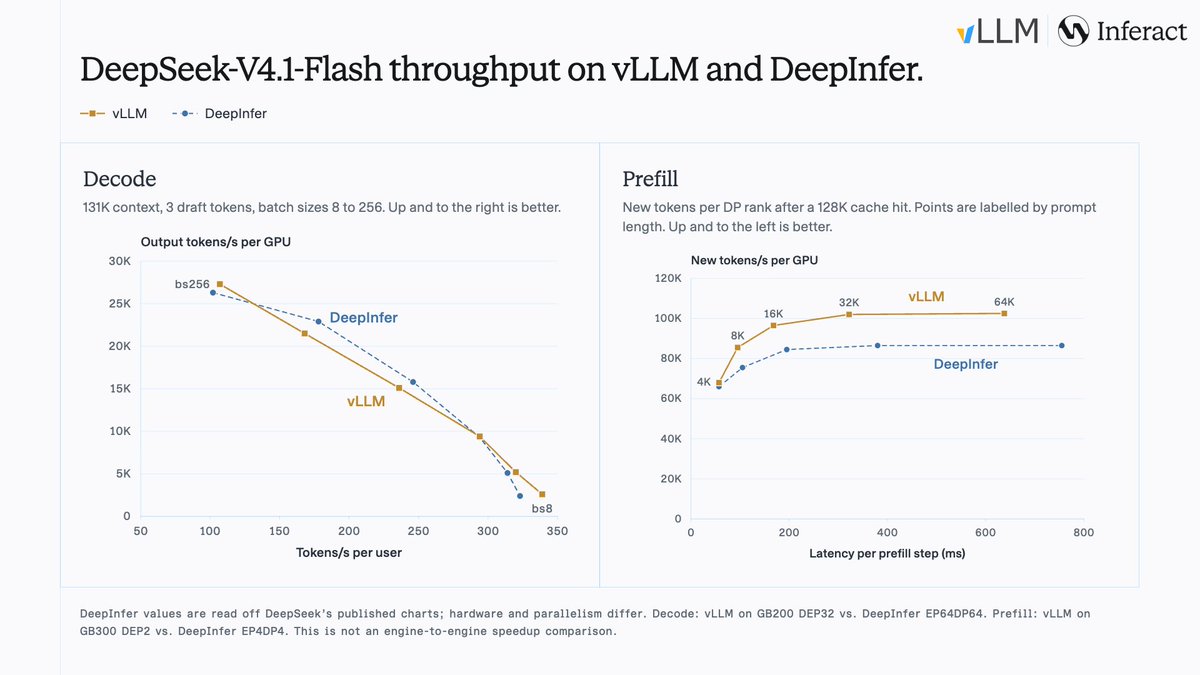
Проект vLLM заявляет, что его движок инференса теперь не уступает DeepInfer — собственному движку DeepSeek для DeepSeek-V4.1-Flash — на конфигурации декодирования DeepSeek при размерах батча от 8 до 256. По словам проекта, этого удалось добиться на DEP32 (параллелизм по данным для механизма внимания с параллелизмом экспертов на 32 GPU) в сравнении с конфигурацией EP64DP64 у DeepInfer.
Как сообщает vLLM, изначально DeepInfer был создан на базе vLLM, а таких результатов удалось достичь благодаря интеграции ядер DeepSeek с открытым исходным кодом и масштабной оптимизации префилла и декодирования. В публикации приведён график производительности; показатели принадлежат vLLM и не проходили независимую проверку. К 24 октября публикация набрала около 307 лайков в X.
Источники
Получайте такие новости в push.
AI Tracker сообщит, когда что-то меняется в ваших инструментах.