 AI Tracker
vLLM का कहना है कि अब वह DeepSeek-V4.1-Flash पर DeepSeek के DeepInfer इंजन के बराबर प्रदर्शन करता है
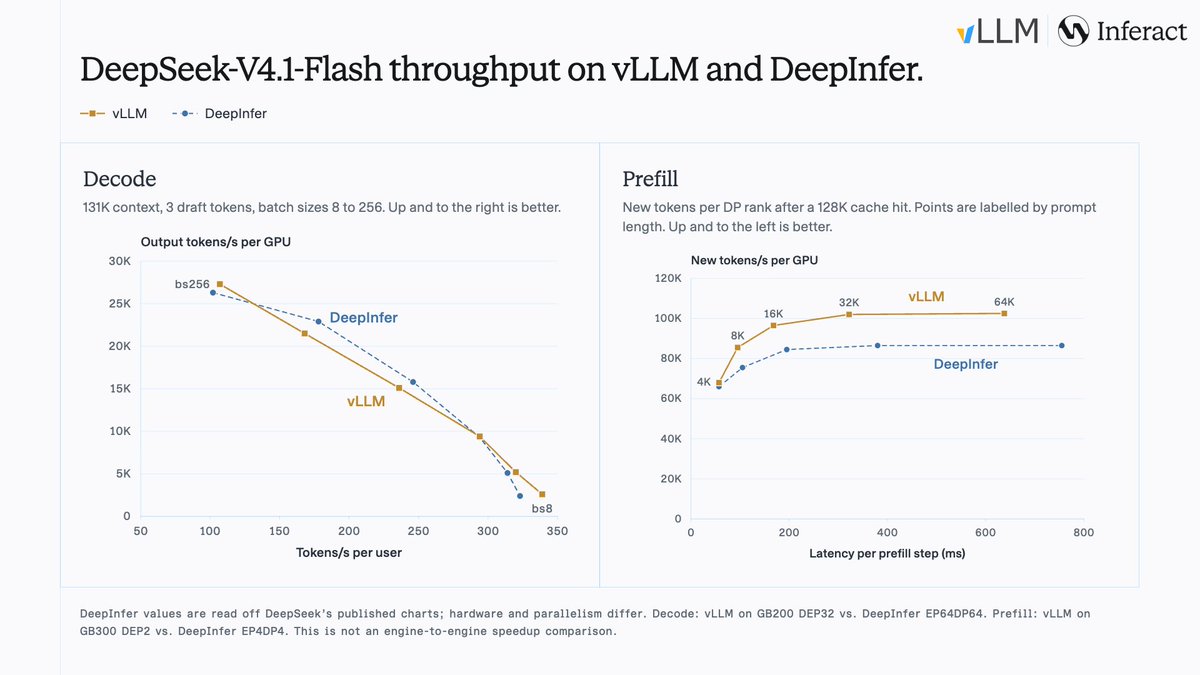
vLLM प्रोजेक्ट का कहना है कि उसका inference engine, batch size 8 से 256 तक, DeepSeek के decode configuration पर DeepSeek-V4.1-Flash के लिए DeepSeek के अपने इंजन DeepInfer के बराबर प्रदर्शन करता है। उसके मुताबिक, यह DEP32 (32 GPUs पर expert parallelism के साथ data-parallel attention) पर हासिल किया गया है, जबकि DeepInfer का सेटअप EP64DP64 है।
vLLM के अनुसार, DeepInfer मूल रूप से vLLM पर बनाया गया था। vLLM ने DeepSeek के open-source kernels को एकीकृत करके और prefill व decode को बड़े पैमाने पर optimize करके ये नतीजे हासिल किए। पोस्ट में एक performance chart है; आंकड़े vLLM के अपने हैं और इनकी स्वतंत्र रूप से पुष्टि नहीं की गई है। 24 अक्टूबर तक X पर पोस्ट को लगभग 307 likes मिले थे।
स्रोत
ऐसी ख़बरें push में पाएँ।
आपके टूल्स में कुछ बदलते ही AI Tracker आपको अलर्ट करता है।