AI Tracker
Multimodal: as notícias,
para devs.
As últimas notícias de multimodal de todos os provedores de IA: lançamentos, mudanças de preço e descontinuações, resumidos com o que significam para você.
Liquid AI apresenta LFM3, seis modelos pequenos para texto, visão, áudio e multimodalidade
A Liquid AI anunciou o LFM3, uma nova geração de seus Liquid Foundation Models, baseada no que a empresa chama de uma nova arquitetura tri-híbrida, com novos codificadores multimodais. Segundo a empresa, a arquitetura é otimizada para 14 classes de processadores, entre GPUs, CPUs e NPUs, e os modelos podem ser ajustados em uma única GPU.Google DeepMind apresenta Genie 4, um modelo de mundo interativo em tempo real
O Google DeepMind anunciou o Genie 4 em 27 de outubro de 2026, chamando-o de seu modelo de mundo mais realista e interativo até agora. Em sua publicação, o DeepMind diz que os usuários podem explorar ambientes dinâmicos em tempo real e ver como a cena responde, quais sons produz e como as pessoas nela se movem, reagem e falam. A empresa publicou uma postagem no blog, "Genie 4: uma nova geração de simulação de mundos".MAI-Image-2.7-Preview, da Microsoft, fica em #2 no ranking de edição de imagens da Artificial Analysis
A Artificial Analysis afirma que o MAI-Image-2.7-Preview, da Microsoft AI, o mais recente modelo de edição de imagens e sucessor do MAI-Image-2.6 (lançado em agosto), ocupa o segundo lugar no leaderboard AA-Image-Editing v2.1, perto do GPT Image 2.5 Sunburst (max), da OpenAI. Os resultados são da própria Artificial Analysis.A SenseTime teria disponibilizado como código aberto o SenseNova 6.8 Code2Video, um modelo de código para vídeo com 27B de parâmetros
Um blogueiro chinês de IA relata que a SenseTime disponibilizou como código aberto o SenseNova 6.8 Code2Video em 27 de outubro, com os pesos no Hugging Face em sensenova/SenseNova-6.8-Code2Video. O relato é de segunda mão; não cita um anúncio da própria SenseTime.Maya-2, modelo de voz para idiomas indianos, é lançado com pesos abertos
Maya-2, um modelo de voz (síntese de fala) voltado para a Índia, foi publicado com pesos abertos em 27 de outubro sob o nome maya-research/maya2-native no Hugging Face. O anúncio no X diz que ele abrange mais de 1,5 bilhão de pessoas nos 28 estados e 8 territórios da União.
Baidu abre o código-fonte do Unlimited OCR 2, um analisador de documentos com custo de decodificação quase constante
A Baidu anunciou o Unlimited OCR 2 no X em 26 de outubro, com o código no GitHub e os pesos no Hugging Face. O modelo foi desenvolvido para analisar documentos de praticamente qualquer extensão dentro de uma janela de contexto finita.Artificial Analysis lança o Code2Video-AA, um benchmark de vídeos de marketing criados com código
A Artificial Analysis apresentou o Code2Video-AA, sua própria implementação do Code2Video Bench da HeyGen, desenvolvida em parceria com a HeyGen. Os modelos recebem 114 briefings de marketing de produtos e marcas e devem responder a cada um com uma composição HTML do HyperFrames em uma única resposta, sem ferramentas; a composição é renderizada em vídeo sem acesso à rede. Um modelo avaliador (Gemini 4 Argon, high) compara pares de vídeos em termos de engajamento, intenção do prompt, composição, consistência temporal e execução, e as classificações Elo dos cinco eixos são calculadas pela média para gerar a pontuação principal. Mais de 35.000 avaliações classificam 27 modelos. Os resultados são da própria Artificial Analysis.Uma CNN de 2015 ajustada supera GPT-6 Astra e Claude Fable 5.1 na identificação de lesões de pele, relata dermatologista
Dr. Magnus Lynch, dermatologista consultor no Guy's Hospital e no King's College London, publicou um teste de GPT-6 Astra e Claude Fable 5.1 com 200 lesões confirmadas por biópsia, escolhidas aleatoriamente do conjunto de dados público MILK10k. Cada modelo recebeu uma foto clínica e uma imagem dermatoscópica, o mesmo prompt e as configurações padrão, e escolheu entre seis diagnósticos. O modelo de comparação foi o Inception v3 (publicado em 2015), ajustado com 68.011 imagens do ISIC Archive em uma GPU H100, com as lesões do teste removidas dos dados de treinamento.Moonshot lança Kimi K3.1 Pro, com pesos abertos previstos até 4 de novembro
A Moonshot anunciou o Kimi K3.1 Pro, que chama de seu modelo de pesos abertos mais capaz da classe 3T: um modelo multimodal de mistura de especialistas, com 2,8T de parâmetros totais e 104B de parâmetros ativos, além de contexto de 1M de tokens. A Moonshot diz que K3.1 Pro e K3.1 Pro Highspeed (2–3× mais rápido) já estão disponíveis no Kimi.ai, Kimi Work, Kimi Code e na Kimi API (IDs dos modelos kimi-k3.1-pro e kimi-k3.1-pro-highspeed). Os pesos abertos foram prometidos até 4 de novembro de 2026.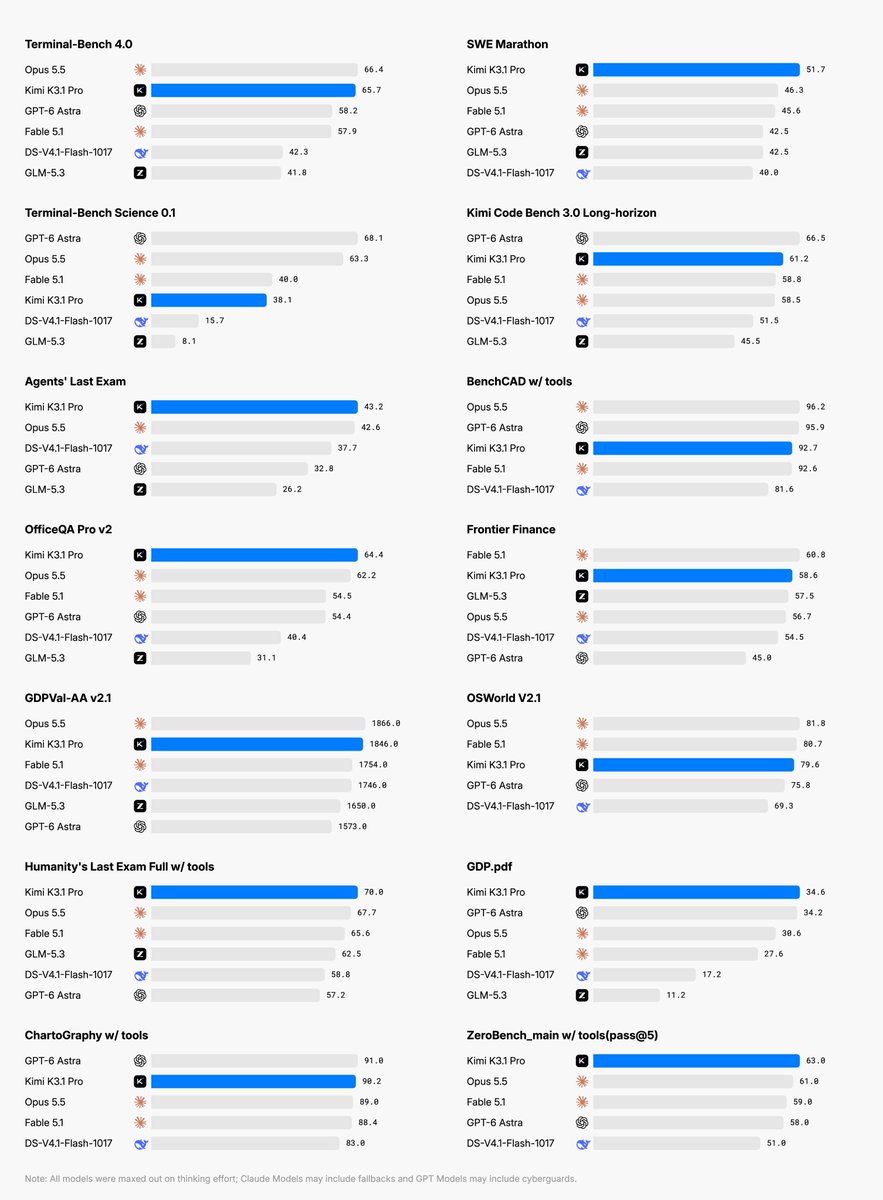
Block apresenta Dessa, um modelo de fala para fala full-duplex
A Block, empresa por trás da Square e do Cash App, apresentou uma prévia de pesquisa do Dessa, que chama de “o modelo de fala full-duplex mais autêntico já criado”. No anúncio, Jack Dorsey diz que conversar com ele é como conversar com uma pessoa, com emoção, nuances, pausas e cadência natural.Google releases Gemini 4 Argon, its latest frontier model
Google released Gemini 4 Argon on October 13, 2026, and says it is available globally. Google's blog post was shared on Hacker News on October 20. The Gemini API changelog lists gemini-4-argon as generally available from October 13, describing it as Google's most capable model, built for complex coding, agentic, math and science tasks.Grok Bot 0.75.2 adiciona cards em chats no desktop e geração de vídeos
Grok Bot 0.75.2 foi lançado, segundo uma publicação no X de um membro da equipe do Grok Bot, que inclui um link para o changelog da versão em x.ai. A publicação lista três mudanças:Ideogram introduces its first vector model
Ideogram announced its first vector model on X. According to Ideogram, it generates clean, editable SVGs with smooth gradients and sharp typography from a text prompt, or turns any image into a detailed, scalable vector.
Mistral releases Voxtral 3, speech models and a voice agent SDK
Mistral announced Voxtral 3 on October 20, 2026 (shared on Hacker News, where it had 735 points and 182 comments by October 20). Details and benchmarks below are Mistral's own claims from its announcement page.
ElevenLabs opens a limited alpha of Eleven Realtime Translation
ElevenLabs announced on X on October 21, 2026 a limited alpha of Eleven Realtime Translation, which builds live voice translation into calls. It followed the launch earlier that week of Eleven Realtime, its product for voice agents that talk to people.