 AI Tracker
Мультимодальность:
новости для разработчиков.
Свежие новости по теме «Мультимодальность» от всех AI-провайдеров: запуски, изменения цен и снятие с поддержки — кратко и с тем, что это значит для вас.
Hume запускает Audio Decision API, который отвечает на вопросы об аудио за один запрос
По словам Hume, Audio Decision API позволяет разработчикам задавать вопросы об аудио — например, сколько в записи говорящих, смеётся ли кто-нибудь и раздражён ли звонящий. Hume утверждает, что API заменяет задачи, для которых раньше требовалось 10 и более моделей.Meituan выпускает LongCat-2.5 — мультимодальную модель с 1,6 трлн параметров для агентных задач
Meituan выпустила LongCat-2.5, согласно публикации в X от аккаунта leo114119, содержащей ссылку на блог Meituan о LongCat. В публикации говорится, что Meituan описывает модель как изначально мультимодальную и созданную для агентных задач, с 1,6 трлн параметров, а также отмечает её сильные стороны в сложных проектах по визуальному программированию и профессиональной офисной работе — например, в креативном дизайне, задачах 3D и бизнес-анализе.
Google announces Gemini 4 Carbon, its next frontier model, to cyber defenders first
Google announced Gemini 4 Carbon on October 28, 2026, calling it its strongest model, with state-of-the-art cybersecurity and long-horizon capabilities. It follows Gemini 4 Argon by two weeks. Sundar Pichai's post and Google's blog say it is not yet generally available: starting this week a subset of cyber defenders get access, with more trusted partners added through the Fairwind Program. Google says it will bring Carbon to developers, businesses and consumers "as soon as possible", and that it is taking part in the U.S. government's voluntary process for pre-release model testing.
Hex, локальное приложение для голосового ввода, позволяющее общаться с кодинговыми агентами, вышло в стабильной версии
31 октября аккаунт OpenCode сообщил в X о выходе стабильной версии Hex. В публикации Hex описывается как быстрый локальный способ голосом общаться с любым агентом, работающий на Mac, Windows и Linux. В публикации есть ссылка на anoma.ly/hex.В OpenCode 2.2.3 добавили инструмент для генерации изображений
30 октября аккаунт OpenCode сообщил в X, что в OpenCode 2.2.3 появился инструмент для генерации изображений, поддерживающий модели для работы с изображениями от OpenAI, Gemini, Grok и других компаний. В OpenCode предлагают использовать его для создания концептов интерфейсов или референсных изображений для видеоигр.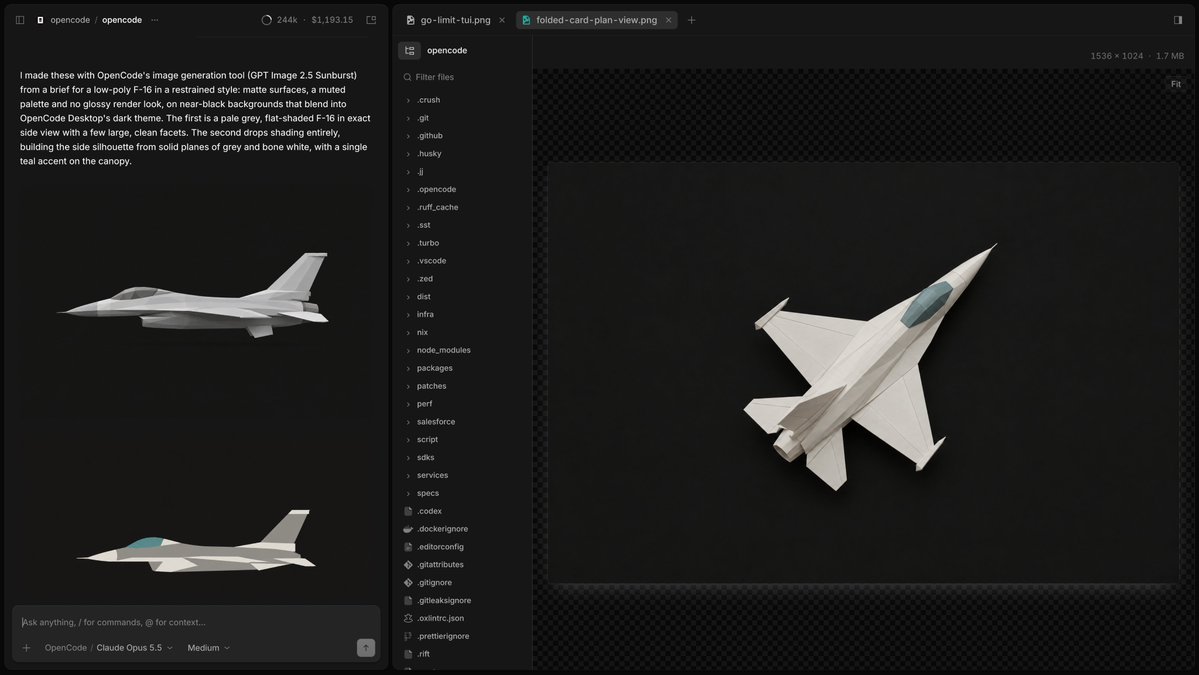
ElevenLabs выпускает SFX v3 — модель звуковых эффектов, которая выполняет составные промпты
ElevenLabs выпустила SFX v3 — свою новейшую модель звуковых эффектов. По словам компании, модель создает более насыщенные и точные звуковые эффекты по одному текстовому промпту, надежнее выполняет несколько инструкций в одном промпте (например: толпа ликует, падает мяч, затем толпа освистывает) и лучше работает с музыкой и вокалом.PokeBot запускает RoboAPI — API, который позволяет отдавать роботизированным манипуляторам инструкции на естественном языке
29 октября PokeBot представила RoboAPI на базе Poke-Aurora, которую компания называет своей моделью действий в физическом мире. По словам компании, совместимые роботы могут выполнять инструкции на естественном языке через простой API без специального обучения под конкретные задачи.Pika запускает H3 Flex — быструю видеомодель, которую компания называет лучшей моделью с открытыми весами для преобразования текста в видео на DesignArena
Pika представила H3 Flex и заявила, что модель дебютирует на первом месте в рейтинге text-to-video на DesignArena среди моделей с открытыми весами (по утверждению Pika). Компания описывает её как модель для профессиональной работы с итерациями: с экспортируемыми аудиодорожками, разрешением до 4K и генерацией быстрее реального времени — 15-секундный ролик с саундтреком можно создать всего за 7 секунд.Phonic 1 дебютирует на первом месте в Speech to Speech Index от Artificial Analysis
По данным Artificial Analysis (сайт с бенчмарками, собственные измерения), Phonic 1 (High) — модель преобразования речи в речь от Phonic — занимает первое место из 22 в Speech to Speech Index с результатом 87,1, ненамного опережая Grok Voice 3.0 (86,9). Модель доступна через Phonic API по цене $0,07 за минуту.Fish Audio выпускает Drama 3, которую Artificial Analysis ставит на первое место среди моделей синтеза речи с открытыми весами
Fish Audio выпустила Drama 3; веса доступны на Hugging Face. Artificial Analysis (сайт с бенчмарками, по собственным замерам) сообщает, что модель занимает первое место среди моделей с открытыми весами в обеих их речевых аренах и первое место среди всех моделей в бенчмарке Pronunciation Robustness.Artificial Analysis представляет AA-Robotics v0.1 — бенчмарк моделей, управляющих роботизированной рукой
Artificial Analysis опубликовала AA-Robotics v0.1: модели управляют роботизированной рукой, а задача показана с точки зрения модели. В одном примере один и тот же робот пишет «hello world». По данным Artificial Analysis, Claude Opus 5.5 выводил буквы точками, сделав 3 270 движений рукой за 34 минуты, а GPT-6 Astra писал непрерывными штрихами — 514 движений за 13 минут.ElevenLabs представляет Cue — модель принудительного выравнивания
Исследовательская команда ElevenLabs представила Cue — модель принудительного выравнивания, которая превращает расшифровку в временные метки. Это используется для субтитров, дубляжа и интерактивных расшифровок. Модель размещает каждый символ на временной шкале аудио.Rime запускает Prism — модель преобразования речи в речь для голосовых ИИ-агентов
Rime запустила Prism — модель преобразования речи в речь для голосовых ИИ-агентов. Приведённые ниже показатели — заявления самой Rime, а не результаты независимых измерений.Artificial Analysis запускает AA-Video-I2V v2.1 — бенчмарк для моделей преобразования изображений в видео
Artificial Analysis запустила AA-Video-I2V v2.1 и AA-Video-I2V-Silent v2.1 — бенчмарки для моделей преобразования изображений в видео. Каждый запрос включает исходное изображение в разрешении 1080p и специально составленный для него промпт; запросы помечены по сценарию использования, возможностям и визуальному стилю. Модели оцениваются с разрешением до 1080p и ранжируются в 10 сценариях использования и по 10 возможностям. В общем рейтинге выборка равномерно распределена между ними. Результаты принадлежат самой Artificial Analysis.
OpenBMB выпустила MiniCPM-OCR — парсер документов с 1B параметров и модель с 2B параметров для оценки результатов OCR
28 октября OpenBMB показала MiniCPM-OCR в X: модель работала локально на iPhone и iPad. Она выпущена с открытыми весами и запускается с помощью llama.cpp, vLLM, SGLang или Ollama; код для дообучения открыт, также OpenBMB предлагает демоверсию и API.AssemblyAI выпускает свою первую модель преобразования текста в речь — AssemblyAI-TTS-1
AssemblyAI выпустила AssemblyAI-TTS-1 — свою первую модель преобразования текста в речь, созданную для голосовых агентов. По словам AssemblyAI, модель передаёт речь в потоковом режиме за 90 мс по цене $15 за миллион символов. Компания называет её лучшей TTS-моделью для масштабного использования по совокупности точности, естественности и стоимости. OpenRouter сообщает, что модель уже доступна на платформе: более 4 000 голосов, обслуживаемых из США или ЕС.