AI Tracker
News zu Multimodal,
für Entwickler.
Die neuesten News zu Multimodal von allen AI-Anbietern: Launches, Preisänderungen und Abkündigungen, zusammengefasst mit dem, was sie für dich bedeuten.
Liquid AI stellt LFM3 vor: sechs kleine Modelle für Text, Vision, Audio und Omni
Liquid AI hat LFM3 angekündigt, eine neue Generation seiner Liquid Foundation Models, die auf einer neuen, laut Unternehmen tri-hybriden Architektur mit neuen multimodalen Encodern basiert. Die Architektur ist laut Liquid AI für 14 Prozessorklassen auf GPUs, CPUs und NPUs optimiert; die Modelle lassen sich auf einer einzelnen GPU feinabstimmen.Google DeepMind stellt Genie 4 vor, ein interaktives Weltmodell in Echtzeit
Google DeepMind hat Genie 4 am 27. Oktober 2026 angekündigt und bezeichnet es als sein bislang realistischstes und interaktivstes Weltmodell. In seinem Beitrag erklärt DeepMind, dass Nutzer dynamische Umgebungen in Echtzeit erkunden und beobachten können, wie die Szene reagiert und klingt und wie sich die Menschen darin bewegen, reagieren und sprechen. Dazu veröffentlichte das Unternehmen einen Blogbeitrag mit dem Titel „Genie 4: a new generation of world simulation“.Microsofts MAI-Image-2.7-Preview belegt Platz 2 bei Artificial Analysis für Bildbearbeitung
Laut Artificial Analysis belegt Microsoft AIs MAI-Image-2.7-Preview, das neueste Bildbearbeitungsmodell und der Nachfolger von MAI-Image-2.6 (veröffentlicht im August), Platz zwei auf der AA-Image-Editing-v2.1-Bestenliste – knapp hinter OpenAIs GPT Image 2.5 Sunburst (max). Die Ergebnisse stammen von Artificial Analysis selbst.SenseTime reportedly open-sources SenseNova 6.8 Code2Video, a 27B code-to-video model
A Chinese AI blogger reports that SenseTime open-sourced SenseNova 6.8 Code2Video on October 27, with weights on Hugging Face under sensenova/SenseNova-6.8-Code2Video. The report is second-hand; SenseTime's own announcement is not cited.Maya-2, ein Sprachmodell für indische Sprachen, erscheint mit offenen Gewichten
Maya-2, ein Sprachmodell zur Sprachsynthese mit Fokus auf Indien, wurde am 27. Oktober unter dem Hugging-Face-Namen maya-research/maya2-native mit offenen Gewichten veröffentlicht. Laut der Ankündigung auf X deckt es mehr als 1,5 Milliarden Menschen in allen 28 Bundesstaaten und 8 Unionsterritorien ab.
Baidu veröffentlicht Unlimited OCR 2 als Open Source – einen Dokumentenparser mit nahezu konstantem Decodieraufwand
Baidu kündigte Unlimited OCR 2 am 26. Oktober auf X an. Der Code ist auf GitHub und die Gewichte sind auf Hugging Face verfügbar. Das Modell ist darauf ausgelegt, Dokumente nahezu beliebiger Länge innerhalb eines begrenzten Kontextfensters zu verarbeiten.Artificial Analysis startet Code2Video-AA, einen Benchmark für Marketingvideos, die mit Code erstellt werden
Artificial Analysis hat Code2Video-AA vorgestellt, eine eigene Implementierung von HeyGens Code2Video Bench, die in Zusammenarbeit mit HeyGen entwickelt wurde. Die Modelle erhalten 114 Briefings zu Produkt- und Markenmarketing und müssen jedes davon in einer einzigen Antwort mit einer HyperFrames-HTML-Komposition beantworten – ohne Tools. Die Komposition wird ohne Netzwerkzugriff in ein Video umgewandelt. Ein Bewertungsmodell (Gemini 4 Argon, high) vergleicht Videopaare anhand von Engagement, Umsetzung der Prompt-Absicht, Komposition, zeitlicher Konsistenz und handwerklicher Qualität. Die Elo-Wertungen der fünf Dimensionen werden zum Gesamtwert gemittelt. Mehr als 35.000 Bewertungen ergeben eine Rangliste von 27 Modellen. Die Ergebnisse stammen von Artificial Analysis selbst.Ein feinjustiertes CNN von 2015 schlägt GPT-6 Astra und Claude Fable 5.1 bei der Benennung von Hautläsionen, berichtet ein Dermatologe
Dr. Magnus Lynch, beratender Dermatologe am Guy’s Hospital und am King’s College London, veröffentlichte einen Test von GPT-6 Astra und Claude Fable 5.1 mit 200 histologisch bestätigten Läsionen, die zufällig aus dem öffentlichen Datensatz MILK10k ausgewählt wurden. Jedes Modell erhielt ein klinisches Foto und ein dermatoskopisches Bild, denselben Prompt und die Standardeinstellungen und wählte aus sechs Diagnosen aus. Das Vergleichsmodell war Inception v3 (veröffentlicht 2015), das auf einer H100-GPU mit 68.011 Bildern aus dem ISIC Archive feinjustiert wurde; die Testläsionen waren aus den Trainingsdaten entfernt worden.Moonshot bringt Kimi K3.1 Pro auf den Markt; offene Gewichte sollen bis zum 4. November folgen
Moonshot hat Kimi K3.1 Pro angekündigt, das laut Unternehmen sein leistungsfähigstes Open-Weight-Modell der 3T-Klasse ist: ein multimodales Mixture-of-Experts-Modell mit insgesamt 2,8T und 104B aktiven Parametern sowie einem Kontextfenster von 1M Tokens. Laut Moonshot sind K3.1 Pro und K3.1 Pro Highspeed (2–3× schneller) auf Kimi.ai, Kimi Work, Kimi Code und über die Kimi API verfügbar (Modell-IDs kimi-k3.1-pro und kimi-k3.1-pro-highspeed). Offene Gewichte sollen bis zum 4. November 2026 veröffentlicht werden.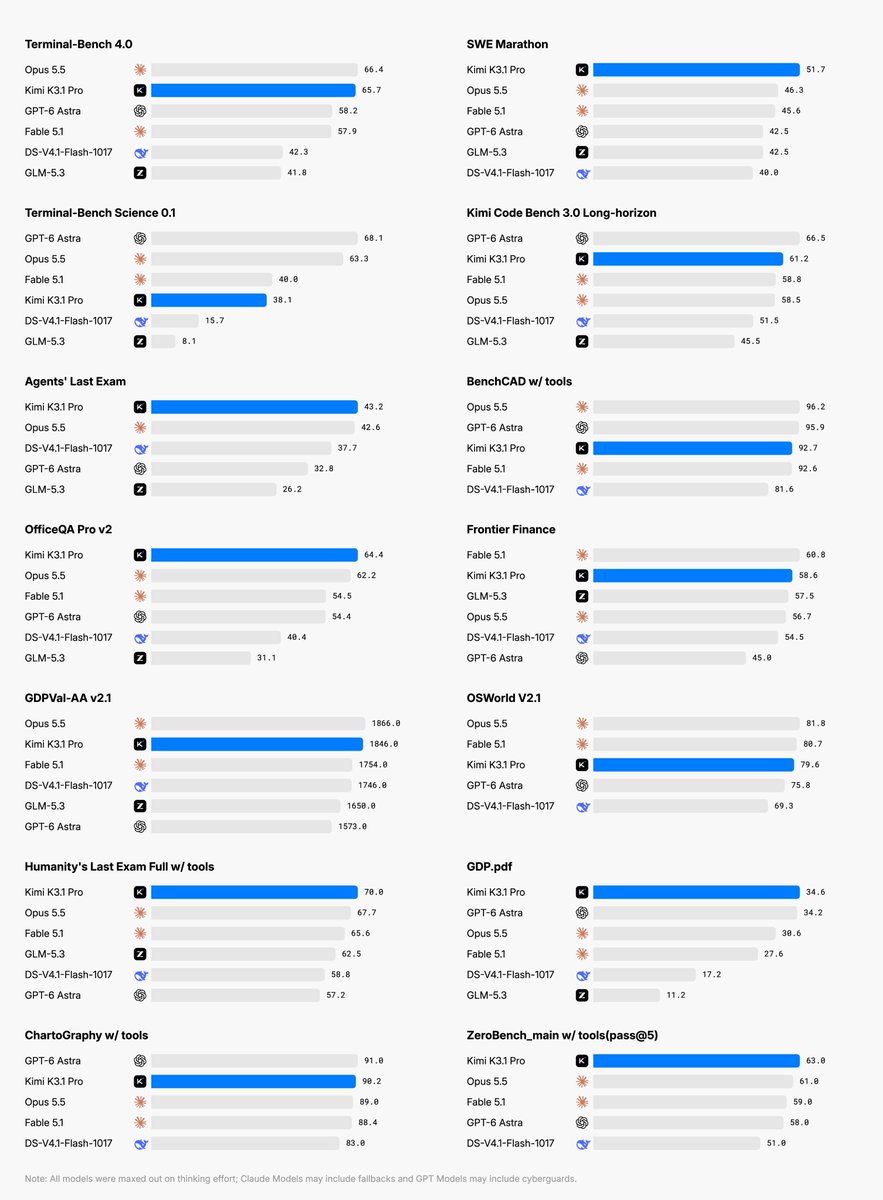
Block stellt Vorschau von Dessa vor, einem Vollduplex-Sprachmodell für Sprache-zu-Sprache
Block, das Unternehmen hinter Square und Cash App, hat eine Forschungsvorschau von Dessa vorgestellt, das laut eigener Aussage „das authentischste Vollduplex-Sprachmodell aller Zeiten“ ist. Jack Dorseys Ankündigung zufolge fühlt sich ein Gespräch damit an wie ein Gespräch mit einer Person – mit Emotionen, Nuancen, Pausen und natürlichem Sprachrhythmus.Google releases Gemini 4 Argon, its latest frontier model
Google released Gemini 4 Argon on October 13, 2026, and says it is available globally. Google's blog post was shared on Hacker News on October 20. The Gemini API changelog lists gemini-4-argon as generally available from October 13, describing it as Google's most capable model, built for complex coding, agentic, math and science tasks.Grok Bot 0.75.2 ergänzt Karten in Desktop-Chats und Videogenerierung
Grok Bot 0.75.2 ist erschienen. Darauf weist ein Beitrag auf X von einem Mitglied des Grok-Bot-Teams hin, der auf das Änderungsprotokoll der Veröffentlichung auf x.ai verlinkt. Der Beitrag führt drei Änderungen auf:Ideogram introduces its first vector model
Ideogram announced its first vector model on X. According to Ideogram, it generates clean, editable SVGs with smooth gradients and sharp typography from a text prompt, or turns any image into a detailed, scalable vector.
Mistral releases Voxtral 3, speech models and a voice agent SDK
Mistral announced Voxtral 3 on October 20, 2026 (shared on Hacker News, where it had 735 points and 182 comments by October 20). Details and benchmarks below are Mistral's own claims from its announcement page.
ElevenLabs opens a limited alpha of Eleven Realtime Translation
ElevenLabs announced on X on October 21, 2026 a limited alpha of Eleven Realtime Translation, which builds live voice translation into calls. It followed the launch earlier that week of Eleven Realtime, its product for voice agents that talk to people.