 AI Tracker
News zu Multimodal,
für Entwickler.
Die neuesten News zu Multimodal von allen AI-Anbietern: Launches, Preisänderungen und Abkündigungen, zusammengefasst mit dem, was sie für dich bedeuten.
Hume bringt die Audio Decision API auf den Markt, die Fragen zu Audio in einem Aufruf beantwortet
Hume zufolge können Entwickler mit der Audio Decision API Fragen zu Audio stellen, etwa wie viele Sprecher zu hören sind, ob jemand lacht oder ob eine anrufende Person frustriert ist. Laut Hume ersetzt sie Aufgaben, für die zuvor mindestens 10 Modelle nötig waren.Meituan veröffentlicht LongCat-2.5, ein multimodales Modell mit 1,6 Billionen Parametern für Agentenaufgaben
Meituan hat LongCat-2.5 veröffentlicht, laut einem X-Beitrag des Accounts leo114119, der auf Meituans LongCat-Blog verlinkt. Dem Beitrag zufolge beschreibt Meituan das Modell als natives multimodales Modell für Agentenaufgaben mit 1,6 Billionen Parametern, das bei komplexen visuellen Coding-Projekten und professioneller Büroarbeit wie kreativem Design, 3D-Aufgaben und Geschäftsanalysen stark sei.
Google announces Gemini 4 Carbon, its next frontier model, to cyber defenders first
Google announced Gemini 4 Carbon on October 28, 2026, calling it its strongest model, with state-of-the-art cybersecurity and long-horizon capabilities. It follows Gemini 4 Argon by two weeks. Sundar Pichai's post and Google's blog say it is not yet generally available: starting this week a subset of cyber defenders get access, with more trusted partners added through the Fairwind Program. Google says it will bring Carbon to developers, businesses and consumers "as soon as possible", and that it is taking part in the U.S. government's voluntary process for pre-release model testing.
Hex, eine lokale Spracheingabe-App für Gespräche mit Coding-Agenten, erreicht eine stabile Version
Der OpenCode-Account teilte am 31. Oktober auf X mit, dass eine stabile Version von Hex verfügbar ist. Hex wird als Möglichkeit beschrieben, per Sprache mit jedem Agenten zu sprechen – schnell, lokal ausgeführt und für Mac, Windows und Linux geeignet. Der Beitrag verlinkt auf anoma.ly/hex.OpenCode 2.2.3 ergänzt ein Tool zur Bildgenerierung
Der OpenCode-Account teilte am 30. Oktober auf X mit, dass OpenCode 2.2.3 ein Tool zur Bildgenerierung bietet, das Bildmodelle von OpenAI, Gemini, Grok und anderen unterstützt. Empfohlen wird der Einsatz für UI-Konzepte oder Referenzgrafiken für Videospiele.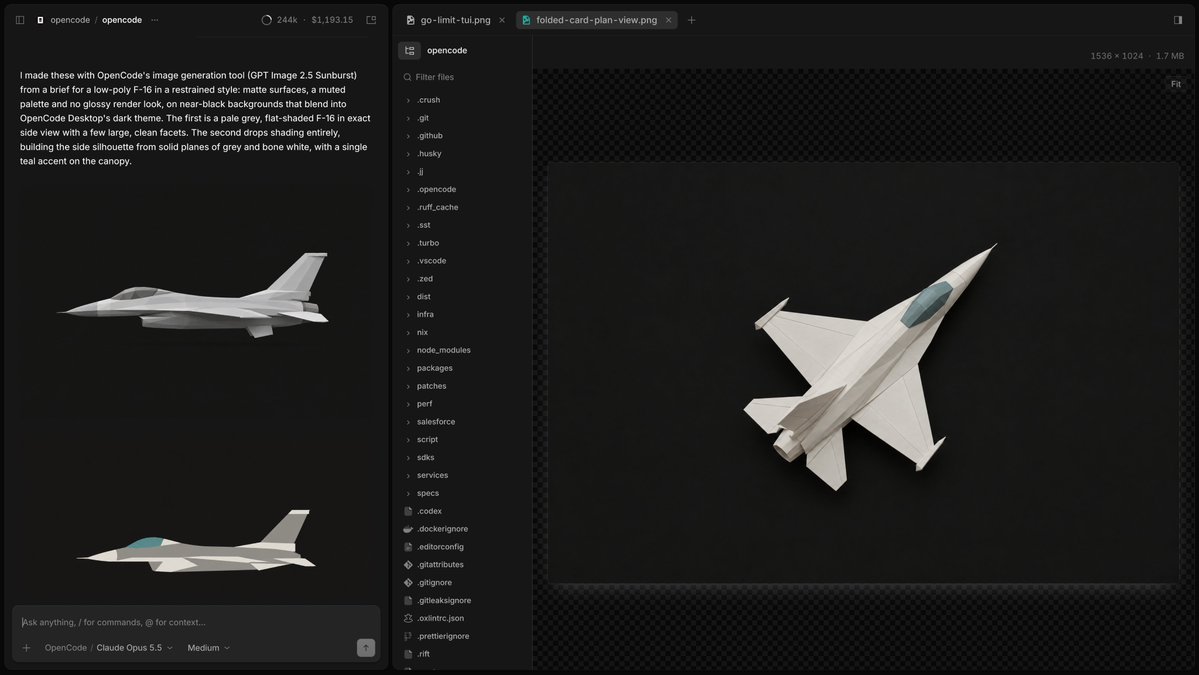
ElevenLabs veröffentlicht SFX v3, ein Soundeffektmodell, das mehrteilige Prompts befolgt
ElevenLabs hat SFX v3 veröffentlicht, sein neuestes Soundeffektmodell. Das Unternehmen gibt an, dass das Modell mit einem einzigen Textprompt reichhaltigere und präzisere Soundeffekte erzeugt, mehrere Anweisungen in einem Prompt zuverlässiger befolgt (als Beispiel: eine jubelnde Menge, ein fallender Ball und anschließend eine buhende Menge) und verbesserte Musik und Gesang bietet.PokeBot startet RoboAPI: Eine API, mit der Roboterarme natürlichsprachliche Anweisungen ausführen
PokeBot hat am 29. Oktober RoboAPI vorgestellt. Der Dienst basiert auf Poke-Aurora, das Unternehmen als sein Weltaktionsmodell bezeichnet. Laut PokeBot können kompatible Roboter über eine einfache API natürlichsprachliche Anweisungen entgegennehmen – ohne aufgabenspezifisches Training.Pika bringt H3 Flex auf den Markt, ein schnelles Videomodell, das laut Unternehmen das führende Open-Weight-Text-zu-Video-Modell auf DesignArena ist
Pika hat H3 Flex vorgestellt. Laut dem Unternehmen debütiert das Modell als Nr. 1 auf DesignArenas Text-zu-Video-Rangliste für Open-Weight-Modelle (eine Behauptung von Pika). Das Modell sei für professionelle Iterationen entwickelt worden und biete exportierbare Audiospuren, Auflösungen von bis zu 4K und eine Generierung schneller als in Echtzeit. Ein 15-sekündiger Clip samt Soundtrack lasse sich in nur 7 Sekunden erstellen.Phonic 1 startet auf Platz 1 im Speech to Speech Index von Artificial Analysis
Artificial Analysis (eine Benchmark-Website mit eigenen Messungen) zufolge belegt Phonic 1 (High), das Speech-to-Speech-Modell von Phonic, mit 87,1 Punkten Platz 1 von 22 im Speech to Speech Index und liegt damit knapp vor Grok Voice 3.0 (86,9). Das Modell ist über die Phonic API für 0,07 $ pro Minute verfügbar.Fish Audio veröffentlicht Drama 3, das laut Artificial Analysis unter den Open-Weight-Sprachmodellen auf Platz 1 liegt
Fish Audio hat Drama 3 veröffentlicht; die Gewichte sind auf Hugging Face verfügbar. Artificial Analysis (eine Benchmark-Website, eigene Messungen) gibt an, dass das Modell in beiden Speech Arenas die Nummer 1 unter den Open-Weight-Modellen ist und im Benchmark Pronunciation Robustness unter allen Modellen auf Platz 1 liegt.Artificial Analysis zeigt AA-Robotics v0.1, einen Benchmark für Modelle, die einen Roboterarm steuern
Artificial Analysis hat AA-Robotics v0.1 veröffentlicht. Der Benchmark lässt Modelle einen Roboterarm steuern und zeigt die Aufgabe aus der Sicht des Modells. In einem Beispiel, in dem derselbe Roboter „hello world“ schreibt, zufolge Artificial Analysis tupfte Claude Opus 5.5 die Buchstaben Punkt für Punkt auf – mit 3.270 Armbewegungen in 34 Minuten –, während GPT-6 Astra in durchgehenden Strichen schrieb – mit 514 Bewegungen in 13 Minuten.ElevenLabs stellt Cue vor, ein Forced-Alignment-Modell
ElevenLabs Research hat Cue vorgestellt, ein Forced-Alignment-Modell: der Schritt, der ein Transkript mit Zeitstempeln versieht – für Untertitel, Synchronisation und anklickbare Transkripte. Cue ordnet jedes Zeichen der Audio-Zeitachse zu.Rime bringt Prism auf den Markt, ein Speech-to-Speech-Modell für Sprachagenten
Rime hat Prism vorgestellt, ein Speech-to-Speech-Modell für KI-Sprachagenten. Die folgenden Angaben stammen von Rime selbst und wurden nicht unabhängig überprüft.Artificial Analysis startet AA-Video-I2V v2.1, einen Benchmark für Image-to-Video-Modelle
Artificial Analysis hat AA-Video-I2V v2.1 und AA-Video-I2V-Silent v2.1 gestartet, einen Benchmark für Image-to-Video-Modelle. Jeder Prompt kombiniert ein 1080p-Startbild mit einem dafür verfassten Prompt und ist nach Anwendungsfall, Fähigkeit und visuellem Stil kategorisiert; die Modelle werden mit bis zu 1080p bewertet und über 10 Anwendungsfälle und 10 Fähigkeiten hinweg eingestuft. Für die Gesamtrangliste werden alle Bereiche gleichmäßig berücksichtigt. Die Ergebnisse stammen von Artificial Analysis selbst.
OpenBMB veröffentlicht MiniCPM-OCR, einen Dokumentenparser mit 1B Parametern, sowie ein 2B-Modell zur Bewertung von OCR-Ergebnissen
OpenBMB zeigte MiniCPM-OCR am 28. Oktober auf X im lokalen Betrieb auf einem iPhone und einem iPad. Das Modell wird mit offenen Gewichten veröffentlicht und kann mit llama.cpp, vLLM, SGLang oder Ollama ausgeführt werden. Der Fine-Tuning-Code ist Open Source; außerdem bietet OpenBMB eine Demo und eine API an.AssemblyAI bringt sein erstes Text-to-Speech-Modell auf den Markt: AssemblyAI-TTS-1
AssemblyAI hat AssemblyAI-TTS-1 eingeführt, sein erstes Text-to-Speech-Modell, das für Sprachagenten entwickelt wurde. AssemblyAI zufolge streamt es mit einer Latenz von 90 ms und kostet 15 $ pro einer Million Zeichen. Das Unternehmen bezeichnet es als das beste TTS-Modell, das sich in großem Maßstab einsetzen lässt und Genauigkeit, Natürlichkeit und Kosten vereint. OpenRouter zufolge ist das Modell dort verfügbar; über 4.000 Stimmen werden aus den USA oder der EU bereitgestellt.