AI Tracker
Noticias de multimodal,
para desarrolladores.
Lo último en multimodal de todos los proveedores de IA: lanzamientos, cambios de precio y retiradas, resumidos con lo que significan para ti.
Liquid AI presenta LFM3, seis modelos pequeños para texto, visión, audio y modalidad omni
Liquid AI anunció LFM3, una nueva generación de sus Liquid Foundation Models basada en lo que denomina una nueva arquitectura tri-híbrida, con nuevos codificadores multimodales. La empresa afirma que la arquitectura está optimizada para 14 clases de procesadores entre GPU, CPU y NPU, y que los modelos se pueden ajustar con una sola GPU.Google DeepMind presenta Genie 4, un modelo del mundo interactivo en tiempo real
Google DeepMind anunció Genie 4 el 27 de octubre de 2026 y lo calificó como su modelo del mundo más realista e interactivo hasta la fecha. En su publicación, DeepMind afirma que los usuarios pueden explorar entornos dinámicos en tiempo real y ver cómo responde la escena, qué sonidos produce y cómo se mueven, reaccionan y hablan las personas que aparecen en ella. Publicó una entrada de blog titulada «Genie 4: a new generation of world simulation».MAI-Image-2.7-Preview de Microsoft ocupa el puesto n.º 2 en edición de imágenes de Artificial Analysis
Artificial Analysis afirma que MAI-Image-2.7-Preview de Microsoft AI, su modelo de edición de imágenes más reciente y sucesor de MAI-Image-2.6 (lanzado en agosto), ocupa el segundo puesto en su clasificación AA-Image-Editing v2.1, muy cerca de GPT Image 2.5 Sunburst (max) de OpenAI. Los resultados son de Artificial Analysis.SenseTime reportedly open-sources SenseNova 6.8 Code2Video, a 27B code-to-video model
A Chinese AI blogger reports that SenseTime open-sourced SenseNova 6.8 Code2Video on October 27, with weights on Hugging Face under sensenova/SenseNova-6.8-Code2Video. The report is second-hand; SenseTime's own announcement is not cited.Maya-2, un modelo de voz para idiomas de la India, se publica con pesos abiertos
Maya-2, un modelo de voz (síntesis de voz) orientado a la India, se publicó con pesos abiertos el 27 de octubre bajo el nombre maya-research/maya2-native en Hugging Face. El anuncio en X afirma que abarca a más de 1.500 millones de personas en los 28 estados y los 8 territorios de la unión.
Baidu publica como código abierto Unlimited OCR 2, un analizador de documentos con un coste de decodificación casi constante
Baidu anunció Unlimited OCR 2 en X el 26 de octubre; el código está en GitHub y los pesos, en Hugging Face. El modelo está diseñado para analizar documentos de prácticamente cualquier extensión dentro de una ventana de contexto finita.Artificial Analysis lanza Code2Video-AA, un benchmark de videos de marketing creados con código
Artificial Analysis presentó Code2Video-AA, su propia implementación de Code2Video Bench de HeyGen, desarrollada en colaboración con HeyGen. Los modelos reciben 114 briefs de marketing de productos y marcas, y deben responder a cada uno con una composición HTML de HyperFrames en una sola respuesta, sin herramientas; la composición se renderiza como video sin acceso a la red. Un modelo juez (Gemini 4 Argon, high) compara pares de videos según su capacidad para captar la atención, la intención del prompt, la composición, la coherencia temporal y la ejecución, y las puntuaciones Elo de los cinco ejes se promedian para obtener la puntuación principal. Más de 35.000 evaluaciones clasifican 27 modelos. Los resultados son propios de Artificial Analysis.Una CNN de 2015 ajustada con fine-tuning supera a GPT-6 Astra y Claude Fable 5.1 al identificar lesiones cutáneas, según un dermatólogo
El Dr. Magnus Lynch, dermatólogo consultor en Guy's Hospital y King's College London, publicó una prueba de GPT-6 Astra y Claude Fable 5.1 con 200 lesiones confirmadas mediante biopsia, seleccionadas al azar del conjunto de datos público MILK10k. Cada modelo recibió una fotografía clínica y una imagen dermatoscópica, la misma indicación y la configuración predeterminada, y eligió entre seis diagnósticos. El modelo de comparación fue Inception v3 (publicado en 2015), ajustado con fine-tuning con 68.011 imágenes del ISIC Archive en una GPU H100, tras excluir del entrenamiento las lesiones de prueba.Moonshot lanza Kimi K3.1 Pro; sus pesos abiertos llegarán antes del 4 de noviembre
Moonshot anunció Kimi K3.1 Pro, que describe como su modelo de pesos abiertos más capaz de la clase 3T: un modelo multimodal de mezcla de expertos con 2,8T de parámetros totales, 104B de parámetros activos y un contexto de 1M de tokens. Moonshot afirma que K3.1 Pro y K3.1 Pro Highspeed (2–3× más rápido) ya están disponibles en Kimi.ai, Kimi Work, Kimi Code y la API de Kimi (IDs de modelo kimi-k3.1-pro y kimi-k3.1-pro-highspeed). Los pesos abiertos llegarán, según lo prometido, antes del 4 de noviembre de 2026.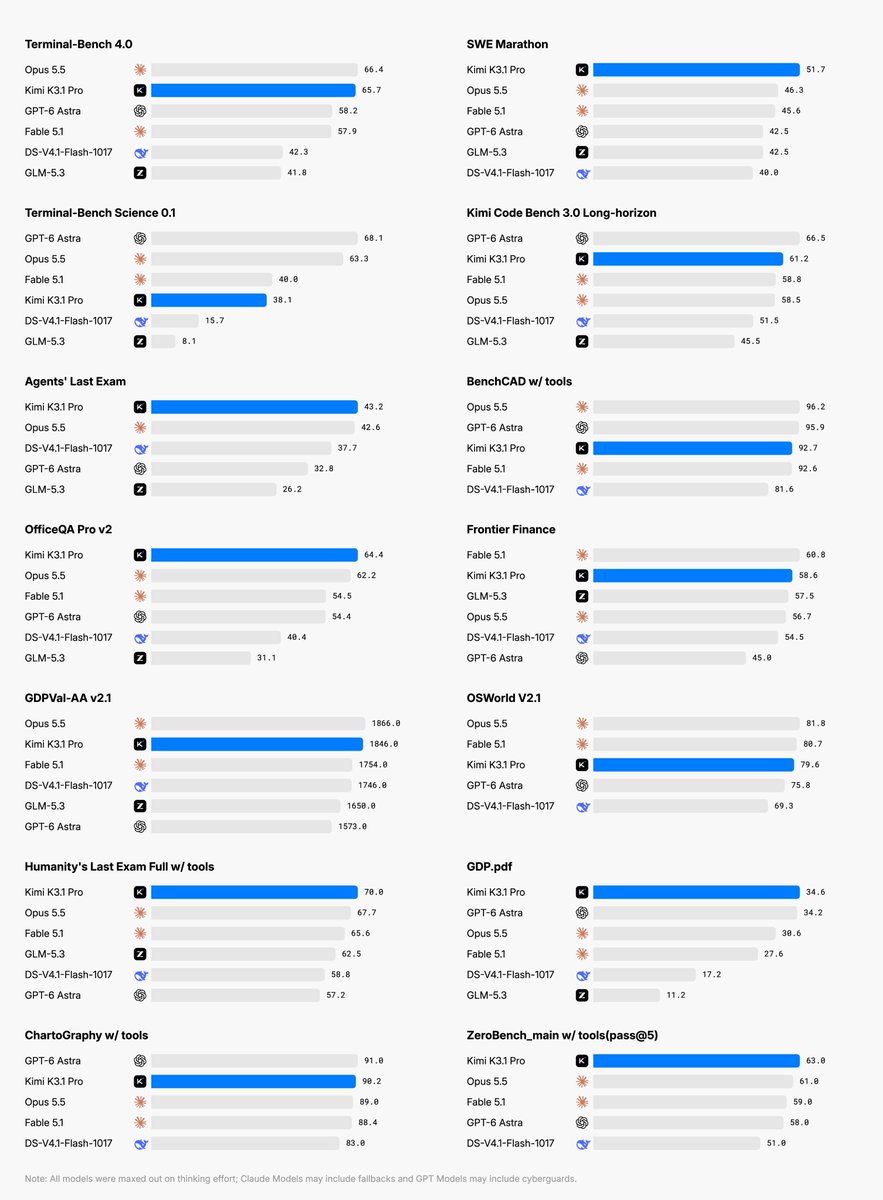
Block presenta Dessa, un modelo de voz a voz full-duplex
Block, la empresa detrás de Square y Cash App, presentó una vista previa de investigación de Dessa, al que describe como «el modelo de voz full-duplex más auténtico jamás creado». En el anuncio de Jack Dorsey se afirma que hablar con él se siente como hablar con una persona, con emoción, matices, pausas y una cadencia natural.Google releases Gemini 4 Argon, its latest frontier model
Google released Gemini 4 Argon on October 13, 2026, and says it is available globally. Google's blog post was shared on Hacker News on October 20. The Gemini API changelog lists gemini-4-argon as generally available from October 13, describing it as Google's most capable model, built for complex coding, agentic, math and science tasks.Grok Bot 0.75.2 añade tarjetas en los chats de escritorio y generación de vídeo
Grok Bot 0.75.2 ya está disponible, según una publicación en X de un miembro del equipo de Grok Bot que enlaza al registro de cambios de la versión en x.ai. La publicación enumera tres cambios:Ideogram introduces its first vector model
Ideogram announced its first vector model on X. According to Ideogram, it generates clean, editable SVGs with smooth gradients and sharp typography from a text prompt, or turns any image into a detailed, scalable vector.
Mistral releases Voxtral 3, speech models and a voice agent SDK
Mistral announced Voxtral 3 on October 20, 2026 (shared on Hacker News, where it had 735 points and 182 comments by October 20). Details and benchmarks below are Mistral's own claims from its announcement page.
ElevenLabs opens a limited alpha of Eleven Realtime Translation
ElevenLabs announced on X on October 21, 2026 a limited alpha of Eleven Realtime Translation, which builds live voice translation into calls. It followed the launch earlier that week of Eleven Realtime, its product for voice agents that talk to people.