AI Tracker
मल्टीमोडल समाचार,
डेवलपर्स के लिए।
हर AI provider से मल्टीमोडल से जुड़ी ताज़ा ख़बरें: लॉन्च, कीमत में बदलाव और बंद होने वाली सेवाएँ, संक्षेप में और आपके लिए उनका मतलब।
Liquid AI ने LFM3 पेश किया: टेक्स्ट, विज़न, ऑडियो और omni के लिए छह छोटे मॉडल
Liquid AI ने LFM3 की घोषणा की, जो उसके Liquid Foundation Models की नई पीढ़ी है। यह नए ट्राई-हाइब्रिड आर्किटेक्चर पर आधारित है, जिसमें नए मल्टीमॉडल एनकोडर शामिल हैं। कंपनी का कहना है कि यह आर्किटेक्चर GPU, CPU और NPU समेत 14 प्रोसेसर श्रेणियों के लिए ऑप्टिमाइज़ किया गया है और इन मॉडलों को एक GPU पर फ़ाइन-ट्यून किया जा सकता है।Google DeepMind ने पेश किया Genie 4, एक रियल-टाइम इंटरैक्टिव वर्ल्ड मॉडल
Google DeepMind ने 27 अक्टूबर, 2026 को Genie 4 की घोषणा की और इसे अब तक का अपना सबसे वास्तविक और इंटरैक्टिव वर्ल्ड मॉडल बताया। अपनी पोस्ट में DeepMind का कहना है कि उपयोगकर्ता रियल टाइम में गतिशील परिवेशों को एक्सप्लोर कर सकते हैं और देख सकते हैं कि दृश्य कैसे प्रतिक्रिया देता है, कैसी आवाज़ें सुनाई देती हैं, और उसमें मौजूद लोग कैसे चलते, प्रतिक्रिया देते और बोलते हैं। इसने “Genie 4: a new generation of world simulation” शीर्षक से एक ब्लॉग पोस्ट प्रकाशित की।Artificial Analysis की इमेज एडिटिंग रैंकिंग में Microsoft का MAI-Image-2.7-Preview #2 पर
Artificial Analysis के मुताबिक, Microsoft AI का MAI-Image-2.7-Preview—उसका सबसे नया इमेज एडिटिंग मॉडल और अगस्त में जारी MAI-Image-2.6 का उत्तराधिकारी—उसकी AA-Image-Editing v2.1 लीडरबोर्ड पर दूसरे स्थान पर है। यह OpenAI के GPT Image 2.5 Sunburst (max) से थोड़ा पीछे है। ये नतीजे Artificial Analysis के अपने हैं।SenseTime ने कथित तौर पर SenseNova 6.8 Code2Video को ओपन-सोर्स किया—यह 27B पैरामीटर वाला कोड-टू-वीडियो मॉडल है
एक चीनी AI ब्लॉगर की रिपोर्ट के मुताबिक, SenseTime ने 27 अक्टूबर को SenseNova 6.8 Code2Video को ओपन-सोर्स किया। इसके वेट्स Hugging Face पर sensenova/SenseNova-6.8-Code2Video के नाम से उपलब्ध हैं। यह जानकारी दूसरे स्रोत से मिली है; SenseTime की अपनी घोषणा का हवाला नहीं दिया गया है।भारतीय भाषाओं के लिए voice model Maya-2, open weights के साथ जारी
भारत को ध्यान में रखकर बनाया गया speech synthesis model Maya-2, 27 अक्टूबर को Hugging Face पर maya-research/maya2-native नाम से open weights के साथ प्रकाशित किया गया। X पर की गई घोषणा के मुताबिक, यह सभी 28 राज्यों और 8 केंद्र शासित प्रदेशों के 1.5 अरब से अधिक लोगों को कवर करता है।
Baidu ने Unlimited OCR 2 को ओपन-सोर्स किया, यह लगभग स्थिर डिकोडिंग लागत वाला दस्तावेज़ पार्सर है
Baidu ने 26 अक्टूबर को X पर Unlimited OCR 2 की घोषणा की; इसका कोड GitHub पर और वेट्स Hugging Face पर उपलब्ध हैं। यह मॉडल सीमित कॉन्टेक्स्ट विंडो के भीतर लगभग किसी भी लंबाई के दस्तावेज़ पार्स करने के लिए बनाया गया है।Artificial Analysis ने Code2Video-AA लॉन्च किया, जो कोड से बनाए गए मार्केटिंग वीडियो का बेंचमार्क है
Artificial Analysis ने HeyGen के साथ साझेदारी में बनाया गया, HeyGen के Code2Video Bench का अपना कार्यान्वयन Code2Video-AA पेश किया। मॉडल को उत्पादों और ब्रांडों के मार्केटिंग से जुड़े 114 ब्रीफ़ दिए जाते हैं और उन्हें हर ब्रीफ़ के जवाब में, बिना टूल इस्तेमाल किए, एक ही प्रतिक्रिया में HyperFrames HTML कंपोज़िशन देना होता है; फिर नेटवर्क ऐक्सेस के बिना उस कंपोज़िशन को वीडियो में रेंडर किया जाता है। एक जज मॉडल (Gemini 4 Argon, high) एंगेजमेंट, प्रॉम्प्ट के इरादे, कंपोज़िशन, समयगत निरंतरता और शिल्प के आधार पर वीडियो के जोड़ों की तुलना करता है। पाँचों पहलुओं की Elo रेटिंग का औसत ही मुख्य स्कोर बनता है। 35,000 से अधिक फैसलों के आधार पर 27 मॉडल की रैंकिंग की गई है। ये नतीजे Artificial Analysis के अपने हैं।त्वचा के घावों की पहचान में 2015 में प्रकाशित एक फ़ाइन-ट्यून किया गया CNN, GPT-6 Astra और Claude Fable 5.1 से बेहतर रहा: त्वचा-रोग विशेषज्ञ की रिपोर्ट
Guy's Hospital और King's College London के कंसल्टेंट त्वचा-रोग विशेषज्ञ Dr Magnus Lynch ने सार्वजनिक MILK10k डेटासेट से बेतरतीब ढंग से चुने गए, बायोप्सी से प्रमाणित 200 घावों पर GPT-6 Astra और Claude Fable 5.1 का परीक्षण प्रकाशित किया। हर मॉडल को एक क्लिनिकल फ़ोटो और एक डर्मोस्कोपिक तस्वीर दी गई, साथ में एक ही प्रॉम्प्ट और डिफ़ॉल्ट सेटिंग्स थीं, और छह निदानों में से एक चुनना था। तुलना के लिए Inception v3 (2015 में प्रकाशित) मॉडल था, जिसे एक H100 GPU पर ISIC Archive की 68,011 तस्वीरों से फ़ाइन-ट्यून किया गया था; परीक्षण के घावों को उसके प्रशिक्षण डेटा से हटा दिया गया था।Moonshot ने Kimi K3.1 Pro लॉन्च किया; ओपन वेट्स 4 नवंबर तक आने वाले हैं
Moonshot ने Kimi K3.1 Pro की घोषणा की, जिसे वह अपना सबसे सक्षम 3T-क्लास ओपन-वेट मॉडल बताता है: यह एक मल्टीमॉडल mixture-of-experts मॉडल है, जिसमें कुल 2.8T और सक्रिय 104B पैरामीटर तथा 1M-token का कॉन्टेक्स्ट है। Moonshot का कहना है कि K3.1 Pro और K3.1 Pro Highspeed (2–3× तेज़) Kimi.ai, Kimi Work, Kimi Code और Kimi API पर उपलब्ध हैं (मॉडल आईडी kimi-k3.1-pro और kimi-k3.1-pro-highspeed)। ओपन वेट्स 4 नवंबर, 2026 तक जारी करने का वादा किया गया है।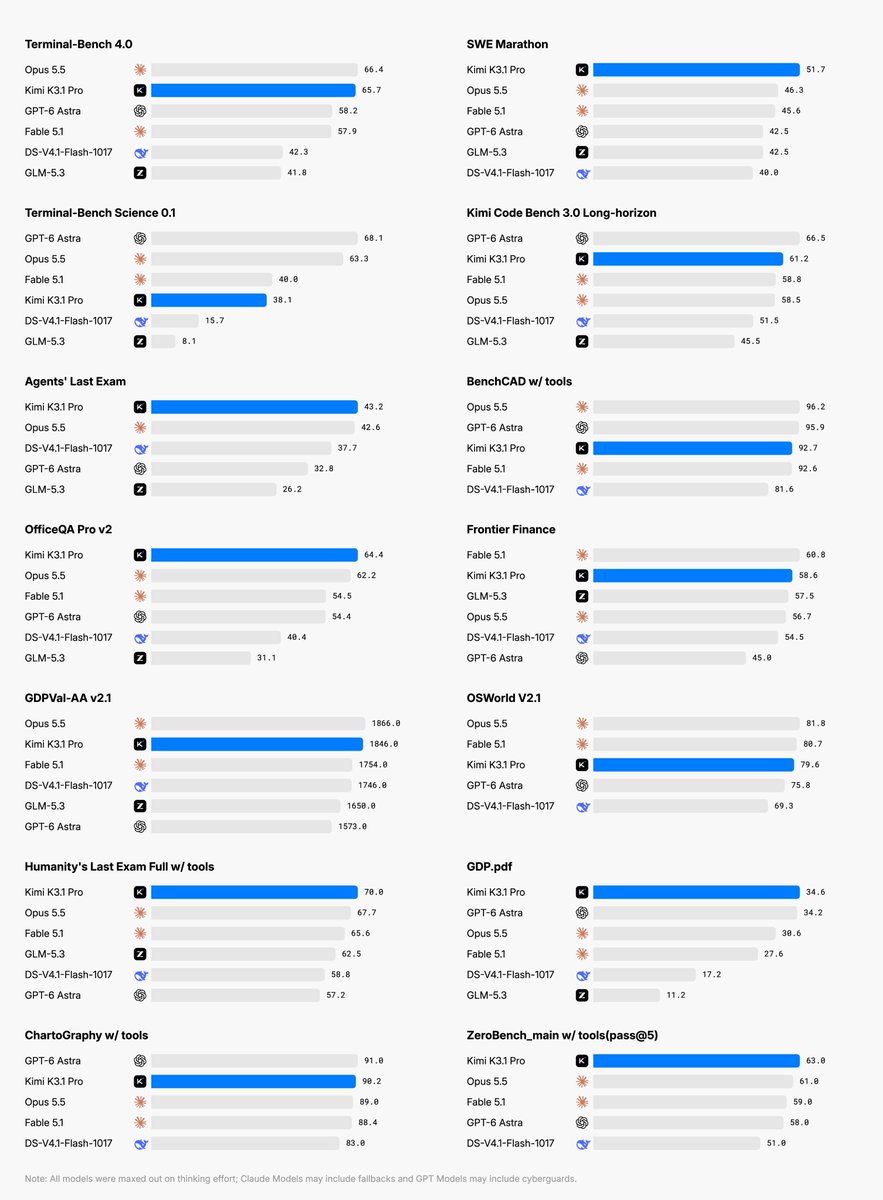
Block ने Dessa का प्रीव्यू पेश किया, जो एक फुल-डुप्लेक्स स्पीच-टू-स्पीच मॉडल है
Square और Cash App के पीछे की कंपनी Block ने Dessa का रिसर्च प्रीव्यू पेश किया। कंपनी इसे “अब तक बनाया गया सबसे प्रामाणिक फुल-डुप्लेक्स स्पीच मॉडल” कहती है। Jack Dorsey की घोषणा के मुताबिक, इससे बात करना किसी व्यक्ति से बात करने जैसा लगता है—भावनाओं, बारीकियों, ठहराव और स्वाभाविक लय के साथ।Google releases Gemini 4 Argon, its latest frontier model
Google released Gemini 4 Argon on October 13, 2026, and says it is available globally. Google's blog post was shared on Hacker News on October 20. The Gemini API changelog lists gemini-4-argon as generally available from October 13, describing it as Google's most capable model, built for complex coding, agentic, math and science tasks.Grok Bot 0.75.2 में डेस्कटॉप चैट में कार्ड और वीडियो जनरेशन जोड़ा गया
X पर Grok Bot टीम के एक सदस्य की पोस्ट के मुताबिक, Grok Bot 0.75.2 जारी हो गया है। पोस्ट में x.ai पर रिलीज़ के चेंजलॉग का लिंक है। इसमें तीन बदलाव बताए गए हैं:Ideogram introduces its first vector model
Ideogram announced its first vector model on X. According to Ideogram, it generates clean, editable SVGs with smooth gradients and sharp typography from a text prompt, or turns any image into a detailed, scalable vector.
Mistral releases Voxtral 3, speech models and a voice agent SDK
Mistral announced Voxtral 3 on October 20, 2026 (shared on Hacker News, where it had 735 points and 182 comments by October 20). Details and benchmarks below are Mistral's own claims from its announcement page.
ElevenLabs opens a limited alpha of Eleven Realtime Translation
ElevenLabs announced on X on October 21, 2026 a limited alpha of Eleven Realtime Translation, which builds live voice translation into calls. It followed the launch earlier that week of Eleven Realtime, its product for voice agents that talk to people.