 AI Tracker
Berita Multimodal,
untuk developer.
Berita Multimodal terbaru dari setiap penyedia AI: peluncuran, perubahan harga, dan penghentian, diringkas beserta artinya bagi Anda.
Hume meluncurkan Audio Decision API, yang menjawab pertanyaan tentang audio dalam satu panggilan
Hume menyebut Audio Decision API memungkinkan developer mengajukan pertanyaan tentang audio, seperti berapa jumlah pembicara, apakah ada yang tertawa, atau apakah penelepon merasa frustrasi. Hume mengatakan API ini menggantikan pekerjaan yang sebelumnya memerlukan 10 model atau lebih.Meituan merilis LongCat-2.5, model multimodal berparameter 1,6T untuk tugas agen
Meituan telah merilis LongCat-2.5, menurut unggahan di X dari akun leo114119 yang menautkan ke blog LongCat milik Meituan. Unggahan itu menyebut Meituan menggambarkannya sebagai model multimodal native yang dibuat untuk tugas agen, dengan 1,6 triliun parameter, serta andal dalam proyek pengodean visual yang kompleks dan pekerjaan kantor profesional seperti desain kreatif, tugas 3D, dan analisis bisnis.
Google announces Gemini 4 Carbon, its next frontier model, to cyber defenders first
Google announced Gemini 4 Carbon on October 28, 2026, calling it its strongest model, with state-of-the-art cybersecurity and long-horizon capabilities. It follows Gemini 4 Argon by two weeks. Sundar Pichai's post and Google's blog say it is not yet generally available: starting this week a subset of cyber defenders get access, with more trusted partners added through the Fairwind Program. Google says it will bring Carbon to developers, businesses and consumers "as soon as possible", and that it is taking part in the U.S. government's voluntary process for pre-release model testing.
Hex, aplikasi input suara lokal untuk berbicara dengan agen coding, mencapai rilis stabil
Akun OpenCode menyatakan di X pada 31 Oktober bahwa rilis stabil Hex telah tersedia. Hex dideskripsikan sebagai cara untuk berbicara dengan agen apa pun lewat suara, yang cepat, berjalan secara lokal, dan berfungsi di Mac, Windows, serta Linux. Unggahan tersebut menautkan ke anoma.ly/hex.OpenCode 2.2.3 menambahkan alat pembuatan gambar
Akun OpenCode menyatakan di X pada 30 Oktober bahwa OpenCode 2.2.3 memiliki alat pembuatan gambar yang mendukung model gambar dari OpenAI, Gemini, Grok, dan lainnya. Akun tersebut menyarankan penggunaannya untuk membuat konsep UI atau seni referensi untuk gim video.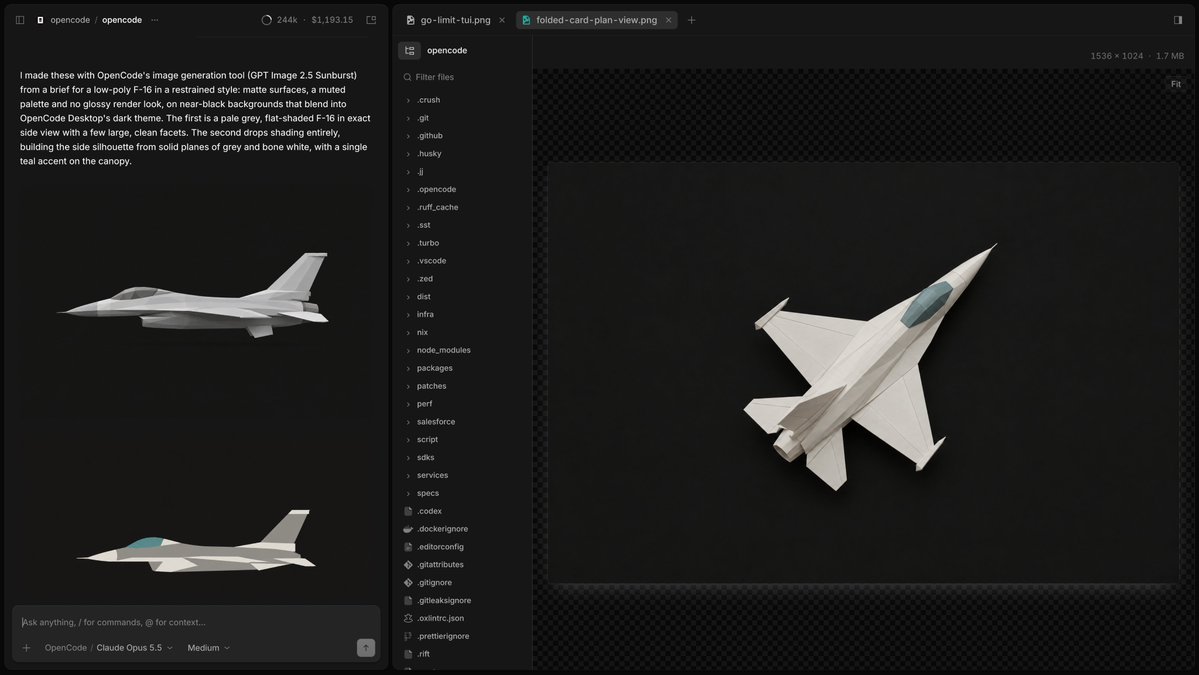
ElevenLabs merilis SFX v3, model efek suara yang mengikuti prompt multi-bagian
ElevenLabs merilis SFX v3, model efek suara terbarunya. Menurut perusahaan, model ini menghasilkan efek suara yang lebih kaya dan presisi dari satu prompt teks, lebih andal mengikuti beberapa instruksi dalam satu prompt (contohnya: kerumunan bersorak, bola jatuh, lalu kerumunan mencemooh), serta memiliki kualitas musik dan vokal yang lebih baik.PokeBot meluncurkan RoboAPI, API yang memungkinkan lengan robot menerima instruksi dalam bahasa alami
PokeBot memperkenalkan RoboAPI pada 29 Oktober, yang ditenagai Poke-Aurora, model aksi dunia yang diklaimnya. Menurut PokeBot, robot yang kompatibel dapat menerima instruksi dalam bahasa alami melalui API sederhana, tanpa pelatihan khusus untuk tiap tugas.Pika meluncurkan H3 Flex, model video cepat yang disebutnya sebagai model text-to-video dengan bobot terbuka terbaik di DesignArena
Pika memperkenalkan H3 Flex, yang menurutnya debut sebagai model berbobot terbuka peringkat #1 di papan text-to-video DesignArena (klaim Pika). Pika menjelaskan bahwa model ini dirancang untuk proses iterasi profesional: stem audio yang dapat diekspor, resolusi hingga 4K, dan pembuatan video yang lebih cepat daripada waktu nyata, dengan klip berdurasi 15 detik beserta soundtrack yang dapat dibuat hanya dalam 7 detik.Phonic 1 debut di posisi #1 pada Speech to Speech Index milik Artificial Analysis
Artificial Analysis (situs benchmark dengan pengukuran sendiri) menyebut Phonic 1 (High), model speech-to-speech dari Phonic, menempati posisi #1 dari 22 model pada Speech to Speech Index dengan skor 87.1, sedikit unggul dari Grok Voice 3.0 (86.9). Model ini tersedia melalui Phonic API dengan harga $0.07 per menit.Fish Audio merilis Drama 3, yang menempati peringkat #1 di antara model ucapan berbobot terbuka menurut Artificial Analysis
Fish Audio merilis Drama 3, dengan bobot model tersedia di Hugging Face. Artificial Analysis (situs tolok ukur dengan pengukuran sendiri) menyebutnya sebagai model berbobot terbuka peringkat #1 di kedua arena ucapannya, serta peringkat #1 dari semua model dalam tolok ukur Pronunciation Robustness.Artificial Analysis menampilkan AA-Robotics v0.1, benchmark model yang mengendalikan lengan robot
Artificial Analysis menerbitkan AA-Robotics v0.1, yang menguji model dalam mengendalikan lengan robot dan menampilkan tugas dari sudut pandang model. Dalam contoh ketika robot yang sama menulis "hello world", Artificial Analysis menyebut Claude Opus 5.5 menuliskannya dengan titik demi titik, dengan 3.270 gerakan lengan selama 34 menit, sementara GPT-6 Astra menulis dengan goresan berkesinambungan, dengan 514 gerakan dalam 13 menit.ElevenLabs memperkenalkan Cue, model penyelarasan paksa
Tim riset ElevenLabs memperkenalkan Cue, model penyelarasan paksa: tahap yang mengubah transkrip menjadi penanda waktu, yang digunakan untuk subtitle, sulih suara, dan transkrip yang dapat diklik. Model ini menempatkan setiap karakter pada linimasa audio.Rime meluncurkan Prism, model speech-to-speech untuk agen suara
Rime meluncurkan Prism, model speech-to-speech untuk agen suara AI. Angka-angka di bawah ini merupakan klaim Rime sendiri, bukan hasil pengukuran independen.Artificial Analysis meluncurkan AA-Video-I2V v2.1, benchmark untuk model image-to-video
Artificial Analysis meluncurkan AA-Video-I2V v2.1 dan AA-Video-I2V-Silent v2.1, benchmark untuk model image-to-video. Setiap prompt memasangkan gambar awal 1080p dengan prompt yang ditulis khusus untuk gambar tersebut, lalu diberi tag berdasarkan kasus penggunaan, kemampuan, dan gaya visual; model dinilai hingga resolusi 1080p dan diperingkat dalam 10 kasus penggunaan serta 10 kemampuan. Peringkat keseluruhan mengambil sampel secara merata dari semuanya. Hasilnya berasal dari Artificial Analysis sendiri.
OpenBMB merilis MiniCPM-OCR, parser dokumen 1B, dengan model 2B untuk menilai hasil OCR
OpenBMB menampilkan MiniCPM-OCR di X pada 28 Oktober, berjalan secara lokal di iPhone dan iPad. Model ini dirilis dengan bobot terbuka dan dapat dijalankan dengan llama.cpp, vLLM, SGLang, atau Ollama; kode fine-tuning bersifat open source, dan OpenBMB juga menyediakan demo serta API.AssemblyAI meluncurkan model text-to-speech pertamanya, AssemblyAI-TTS-1
AssemblyAI meluncurkan AssemblyAI-TTS-1, model text-to-speech pertamanya yang dirancang untuk agen suara. AssemblyAI menyebut model ini dapat melakukan streaming dalam 90 ms dengan harga $15 per satu juta karakter, serta mengklaimnya sebagai model TTS terbaik yang dapat dijalankan dalam skala besar jika akurasi, kealamian, dan biaya dipertimbangkan secara bersamaan. OpenRouter menyebut model ini sudah tersedia di platformnya, dengan lebih dari 4.000 suara yang dilayani dari AS atau UE.