 AI Tracker
Multimodale: le notizie,
per chi sviluppa.
Le ultime notizie su multimodale da ogni provider AI: lanci, cambi di prezzo e dismissioni, riassunti con cosa significano per te.
Hume lancia Audio Decision API, che risponde alle domande sull’audio con una sola chiamata
Hume afferma che Audio Decision API permette agli sviluppatori di porre domande sull’audio, per esempio quanti interlocutori ci sono, se qualcuno sta ridendo o se chi chiama è frustrato. Secondo Hume, sostituisce un lavoro che prima richiedeva 10 o più modelli.Meituan lancia LongCat-2.5, un modello multimodale da 1,6T di parametri per attività agentiche
Meituan ha lanciato LongCat-2.5, secondo un post su X dell’account leo114119 che rimanda al blog LongCat di Meituan. Il post dice che Meituan lo descrive come un modello multimodale nativo progettato per attività agentiche, con 1,6 trilioni di parametri e prestazioni elevate in progetti complessi di programmazione visiva e in attività professionali d’ufficio come design creativo, attività 3D e analisi aziendale.
Google announces Gemini 4 Carbon, its next frontier model, to cyber defenders first
Google announced Gemini 4 Carbon on October 28, 2026, calling it its strongest model, with state-of-the-art cybersecurity and long-horizon capabilities. It follows Gemini 4 Argon by two weeks. Sundar Pichai's post and Google's blog say it is not yet generally available: starting this week a subset of cyber defenders get access, with more trusted partners added through the Fairwind Program. Google says it will bring Carbon to developers, businesses and consumers "as soon as possible", and that it is taking part in the U.S. government's voluntary process for pre-release model testing.
Hex, un’app locale di input vocale per parlare con gli agenti di coding, raggiunge la versione stabile
Il 31 ottobre, l’account di OpenCode ha annunciato su X che è disponibile una versione stabile di Hex. La descrive come un modo veloce e locale per parlare a voce con qualsiasi agente, compatibile con Mac, Windows e Linux. Il post rimanda a anoma.ly/hex.OpenCode 2.2.3 aggiunge uno strumento per la generazione di immagini
L’account di OpenCode ha dichiarato su X il 30 ottobre che OpenCode 2.2.3 include uno strumento per la generazione di immagini compatibile con i modelli di immagini di OpenAI, Gemini, Grok e altri. Suggerisce di usarlo per creare concept UI o immagini di riferimento per videogiochi.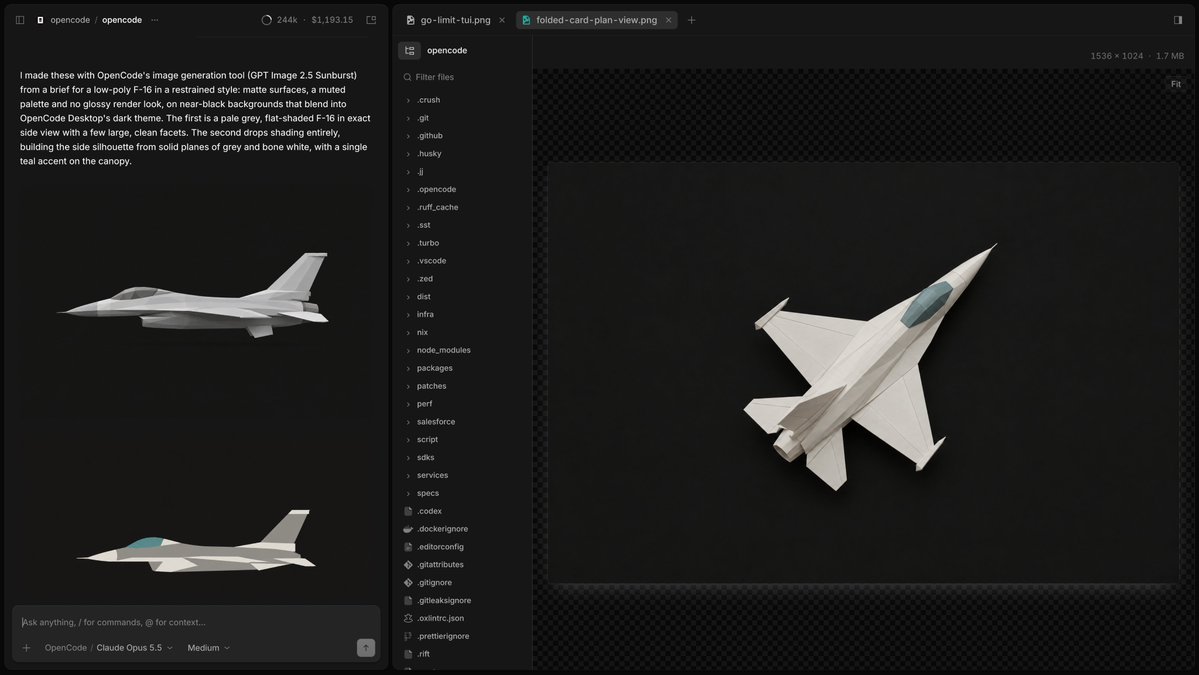
ElevenLabs lancia SFX v3, un modello per effetti sonori che segue prompt composti da più parti
ElevenLabs ha lanciato SFX v3, il suo più recente modello per effetti sonori. L’azienda afferma che il modello genera effetti sonori più ricchi e precisi a partire da un singolo prompt di testo, segue in modo più affidabile più istruzioni nello stesso prompt (l’esempio fornito: una folla che esulta, una palla che cade e poi una folla che fischia) e offre musica e voci migliorate.PokeBot lancia RoboAPI, un’API che consente di impartire istruzioni in linguaggio naturale ai bracci robotici
PokeBot ha presentato RoboAPI il 29 ottobre. Il servizio è basato su Poke-Aurora, che l’azienda definisce il suo modello per le azioni nel mondo reale. Secondo PokeBot, i robot compatibili possono ricevere istruzioni in linguaggio naturale tramite una semplice API, senza bisogno di addestramento specifico per ogni attività.Pika lancia H3 Flex, un modello video veloce che definisce il miglior modello open-weight text-to-video su DesignArena
Pika ha presentato H3 Flex, che secondo l’azienda debutta al primo posto tra i modelli open-weight nella classifica text-to-video di DesignArena (affermazione di Pika). Descrive il modello come pensato per l’iterazione professionale: tracce audio esportabili, risoluzioni fino a 4K e generazione più veloce del tempo reale, con una clip di 15 secondi e colonna sonora create in appena 7 secondi.Phonic 1 debutta al primo posto nello Speech to Speech Index di Artificial Analysis
Artificial Analysis (un sito di benchmark, con misurazioni proprie) afferma che Phonic 1 (High), il modello speech-to-speech di Phonic, si colloca al primo posto su 22 nello Speech to Speech Index, con 87,1 punti, di poco davanti a Grok Voice 3.0 (86,9). Il modello è disponibile tramite l'API di Phonic a $0,07 al minuto.Fish Audio lancia Drama 3, che Artificial Analysis classifica al primo posto tra i modelli vocali open-weight
Fish Audio ha rilasciato Drama 3, con i pesi disponibili su Hugging Face. Artificial Analysis (un sito di benchmark, secondo le proprie misurazioni) afferma che è il modello open-weight al primo posto in entrambe le sue Speech Arena e al primo posto tra tutti i modelli nel benchmark Pronunciation Robustness.Artificial Analysis presenta AA-Robotics v0.1, un benchmark di modelli che controllano un braccio robotico
Artificial Analysis ha pubblicato AA-Robotics v0.1, che mette i modelli alla guida di un braccio robotico e mostra l’attività dal punto di vista del modello. In un esempio in cui lo stesso robot scrive «hello world», Artificial Analysis afferma che Claude Opus 5.5 l’ha scarabocchiato punto per punto, con 3.270 movimenti del braccio in 34 minuti, mentre GPT-6 Astra ha scritto con tratti continui, con 514 movimenti in 13 minuti.ElevenLabs presenta Cue, un modello di allineamento forzato
ElevenLabs Research ha presentato Cue, un modello di allineamento forzato: il passaggio che trasforma una trascrizione in marcature temporali, usate per sottotitoli, doppiaggio e trascrizioni interattive. Cue colloca ogni carattere sulla linea temporale dell’audio.Rime lancia Prism, un modello speech-to-speech per agenti vocali
Rime ha lanciato Prism, un modello speech-to-speech per agenti vocali basati sull’IA. I dati riportati di seguito sono dichiarazioni di Rime, non misurazioni indipendenti.Artificial Analysis lancia AA-Video-I2V v2.1, un benchmark per i modelli di generazione video da immagini
Artificial Analysis ha lanciato AA-Video-I2V v2.1 e AA-Video-I2V-Silent v2.1, un benchmark per i modelli di generazione video da immagini. Ogni prompt abbina un'immagine iniziale a 1080p a un prompt scritto appositamente per essa ed è classificato per caso d'uso, capacità e stile visivo; i modelli vengono valutati fino a 1080p e classificati in 10 casi d'uso e 10 capacità. La classifica generale assegna lo stesso peso a ciascuna categoria. I risultati sono elaborati da Artificial Analysis.
OpenBMB lancia MiniCPM-OCR, un parser di documenti da 1B, con un modello da 2B che assegna punteggi ai risultati OCR
OpenBMB ha mostrato MiniCPM-OCR su X il 28 ottobre, in esecuzione in locale su un iPhone e un iPad. È rilasciato con pesi aperti e può essere eseguito con llama.cpp, vLLM, SGLang o Ollama; il codice per il fine-tuning è open source e OpenBMB offre anche una demo e un'API.AssemblyAI lancia il suo primo modello di sintesi vocale, AssemblyAI-TTS-1
AssemblyAI ha lanciato AssemblyAI-TTS-1, il suo primo modello di sintesi vocale, progettato per agenti vocali. AssemblyAI afferma che il modello trasmette l'audio in streaming in 90 ms al costo di 15 $ per milione di caratteri e lo definisce il miglior modello TTS eseguibile su larga scala considerando insieme precisione, naturalezza e costo. OpenRouter afferma che il modello è disponibile sulla piattaforma, con oltre 4.000 voci servite dagli Stati Uniti o dall'UE.