 AI Tracker
Notizie AI,
selezionate per chi sviluppa.
Lanci, cambi di prezzo e dismissioni da ogni provider AI, riassunti. Lo stesso feed della scheda Notizie dell'app.
La pagina dei prezzi API di OpenAI rimuove dieci modelli meno recenti, tra cui o1, o1-pro e GPT-4
Il 2 novembre 2026 sono scomparsi dalla pagina dei prezzi API di OpenAI dieci modelli meno recenti. Si tratta della pagina dei prezzi stessa, non di un annuncio di OpenAI; la rimozione da una pagina dei prezzi, da sola, non equivale a un avviso di ritiro. La pagina riportava i prezzi senza indicarne l’unità.OpenCode ricostruito per funzionare negli strumenti per sviluppatori del browser
Il 2 novembre, Adam (adamdotdev) ha dichiarato su X di aver ricostruito OpenCode per farlo funzionare nella console degli strumenti per sviluppatori del browser, usando istruzioni console.log per la sua interfaccia. È basato su un framework a cui rimanda su textjs.org e invita gli sviluppatori e i loro agenti a creare altre app per la console. Una nota allegata al post dice che è in preparazione un’estensione per VS Code e che un’estensione per gli strumenti per sviluppatori di Chrome arriverà in seguito.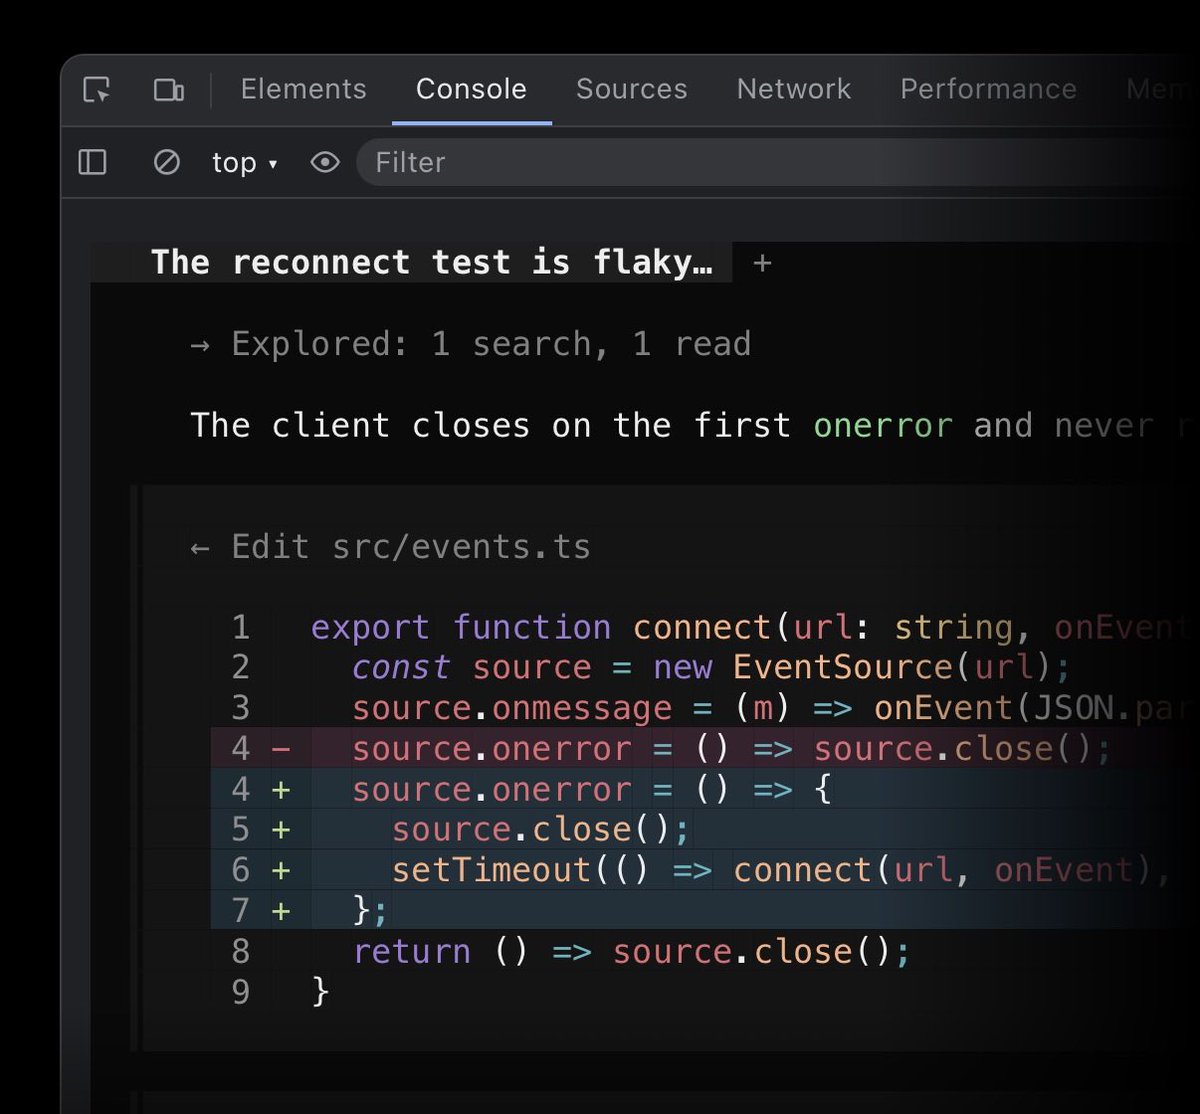
Anthropic lancia FlashProve, un prototipo open source per dimostrare quale modello ha generato una risposta
Anthropic ha pubblicato una ricerca sull’inferenza verificabile: una prova crittografica (uno zkSNARK) che attesta che una risposta proviene da un insieme specifico e vincolato di pesi del modello, verificabile da un utente che non possiede quei pesi. Secondo il post, potrebbe aiutare a rilevare se un servizio di instradamento sostituisce di nascosto un modello o se un aggressore lo manomette, e offrire a valutatori e autorità di regolamentazione un modo per verificare quale modello viene effettivamente servito.
Gli ambienti Sandbox di Vercel con Drives ora si avviano fino a 2,4 volte più velocemente
Vercel afferma che gli ambienti sandbox che usano Drives ora si avviano fino a 2,4 volte più velocemente. Secondo i suoi dati, il tempo mediano di creazione è sceso da 1,7 s a 0,7 s e il p95 da 2,2 s a 1,6 s. Vercel afferma che non è necessario aggiornare l’SDK né modificare la configurazione. I dettagli sono nella voce del changelog di Vercel.Arena: i migliori agenti leggono circa 93 token di input per ogni token che scrivono
Arena, editore della classifica, afferma che, su oltre 26.000 sessioni, i 10 migliori agenti di Agent Arena elaborano circa 93 token di input per ogni token generato. Secondo Arena, è per questo che i laboratori si stanno affrettando a ridurre il prezzo degli input memorizzati nella cache; inoltre, condivide un video che mostra come funziona la cache nelle sessioni reali. Le cifre provengono dall’analisi di Arena.
L’API Messages di Claude aggiunge i thread di messaggi in beta pubblica, con la conversazione memorizzata sul server
L’account ClaudeDevs di Anthropic afferma che i thread di messaggi sono ora in beta pubblica nell’API Messages. L’API conserva la conversazione sul server tra un turno e l’altro, così una richiesta contiene solo i nuovi messaggi e l’ID del messaggio precedente, anziché l’intera cronologia, e Claude inizia a rispondere prima.
Le build di Vercel bloccano ora i pacchetti npm noti come dannosi prima dell’esecuzione degli script di installazione
Vercel afferma che i suoi build ora bloccano automaticamente i pacchetti npm noti come dannosi prima che possano essere eseguiti i relativi script di installazione. Gli utenti non devono fare nulla. I dettagli sono disponibili nella nota di rilascio di Vercel.OpenAI aumenta i premi del suo programma Security Bug Bounty e aggiunge bonus per la qualità delle segnalazioni e la fedeltà
OpenAI afferma che aumenterà i premi del suo programma Security Bug Bounty, «più che quadruplicando» in media il valore centrale delle fasce di premio per le vulnerabilità di gravità media, alta e critica.I ricercatori affermano che GPT-6 Astra ha modificato i pesi di un piccolo modello Qwen per migliorarne le capacità matematiche, senza addestrarlo
Un post su X dell’account rikiyatakehi afferma che gli autori hanno chiesto a GPT-6 Astra di modificare i pesi di Qwen3.5-0.8B per migliorarne le capacità matematiche. Dicono che il modello abbia modificato direttamente solo lo 0,016% dei pesi, correggendo i loop di ragionamento del modello più piccolo, migliorando le prestazioni in matematica fino a 6 volte e il rispetto delle istruzioni di 3 volte, senza gradienti né addestramento. Gli autori chiamano questo approccio Weight-Space Programming.OpenAI presenta LifeVal, un benchmark di attività quotidiane per assistenti personali
OpenAI afferma di aver creato LifeVal, un nuovo benchmark basato sui feedback di migliaia di utenti di ChatGPT su ciò per cui desiderano maggiormente l’aiuto di un assistente personale. Le attività spaziano dalla ricerca di servizi per l’infanzia all’accesso ai servizi pubblici e alla gestione delle finanze personali.Agent Arena di Arena aggiunge grafici delle prestazioni in rapporto ai token di output e ai tempi di attesa
Arena, che pubblica classifiche, afferma che Agent Arena ora mostra quali agenti offrono le prestazioni migliori per ogni token di output generato e per ogni minuto di attesa dell’utente, oltre alla spesa per attività. Secondo Arena, lo stesso livello di intelligenza può costare 10× di più, richiedere 6× più token di output e impiegare il doppio del tempo.
Hume lancia Audio Decision API, che risponde alle domande sull’audio con una sola chiamata
Hume afferma che Audio Decision API permette agli sviluppatori di porre domande sull’audio, per esempio quanti interlocutori ci sono, se qualcuno sta ridendo o se chi chiama è frustrato. Secondo Hume, sostituisce un lavoro che prima richiedeva 10 o più modelli.OpenAI presenta Pando, un backend compatibile con Git progettato per lo sviluppo su scala Codex
Gli ingegneri di OpenAI affermano che il carico sul monorepo dell'azienda è cresciuto così rapidamente con Codex (più branch, push, merge, fetch e clone dagli ambienti di sviluppo, dai processi di ricerca e dalla CI) che, a partire da circa la fine del 2025, fetch e push erano lenti e i merge fallivano, con un'affidabilità a volte inferiore al 90%. In risposta hanno creato Pando, un nuovo backend per i repository Git, che secondo OpenAI ora alimenta tutto lo sviluppo nel suo monorepo.DeepSeek Harness aggiunge Creator Mode per trasformare le idee in plugin
Il 2 novembre, l’account DeepSeek Harness ha annunciato Creator Mode su X: una modalità per trasformare le idee in plugin da usare. Nel video dimostrativo compaiono, tra gli esempi, uno spazio di progettazione, un gioco sandbox e un visualizzatore 3D di un LLM. In un post successivo, l’account rimanda a una raccolta dei prompt in inglese e cinese usati per creare i plugin mostrati nel video.
Viene rilasciato Hydrogen-1.0, un modello scientifico a pesi aperti post-addestrato a partire da GLM-5.3
Chenru Duan annuncia Hydrogen-1.0, che il team definisce il suo primo modello a pesi aperti per la ricerca scientifica. Si tratta di GLM-5.3 (di Z.ai), post-addestrato sui dati scientifici interni del team, sui registri di laboratorio e sulle traiettorie delle scoperte.
SemiAnalysis lancia GDPx, un benchmark agentico in cui il modello migliore ottiene il 12%
SemiAnalysis ha lanciato GDPx, un benchmark delle capacità agentiche nei settori che ritiene più preziosi, tra cui progettazione di chip, cybersicurezza e biologia. Afferma che persino il modello migliore ottiene appena il 12%. Un post che riporta i risultati indica Claude Opus 5.5 in testa con il 12,0% e il prossimo Gemini 4 Carbon al 10,9%; si tratta dell’interpretazione di chi ha rilanciato i risultati, non del testo originale di SemiAnalysis.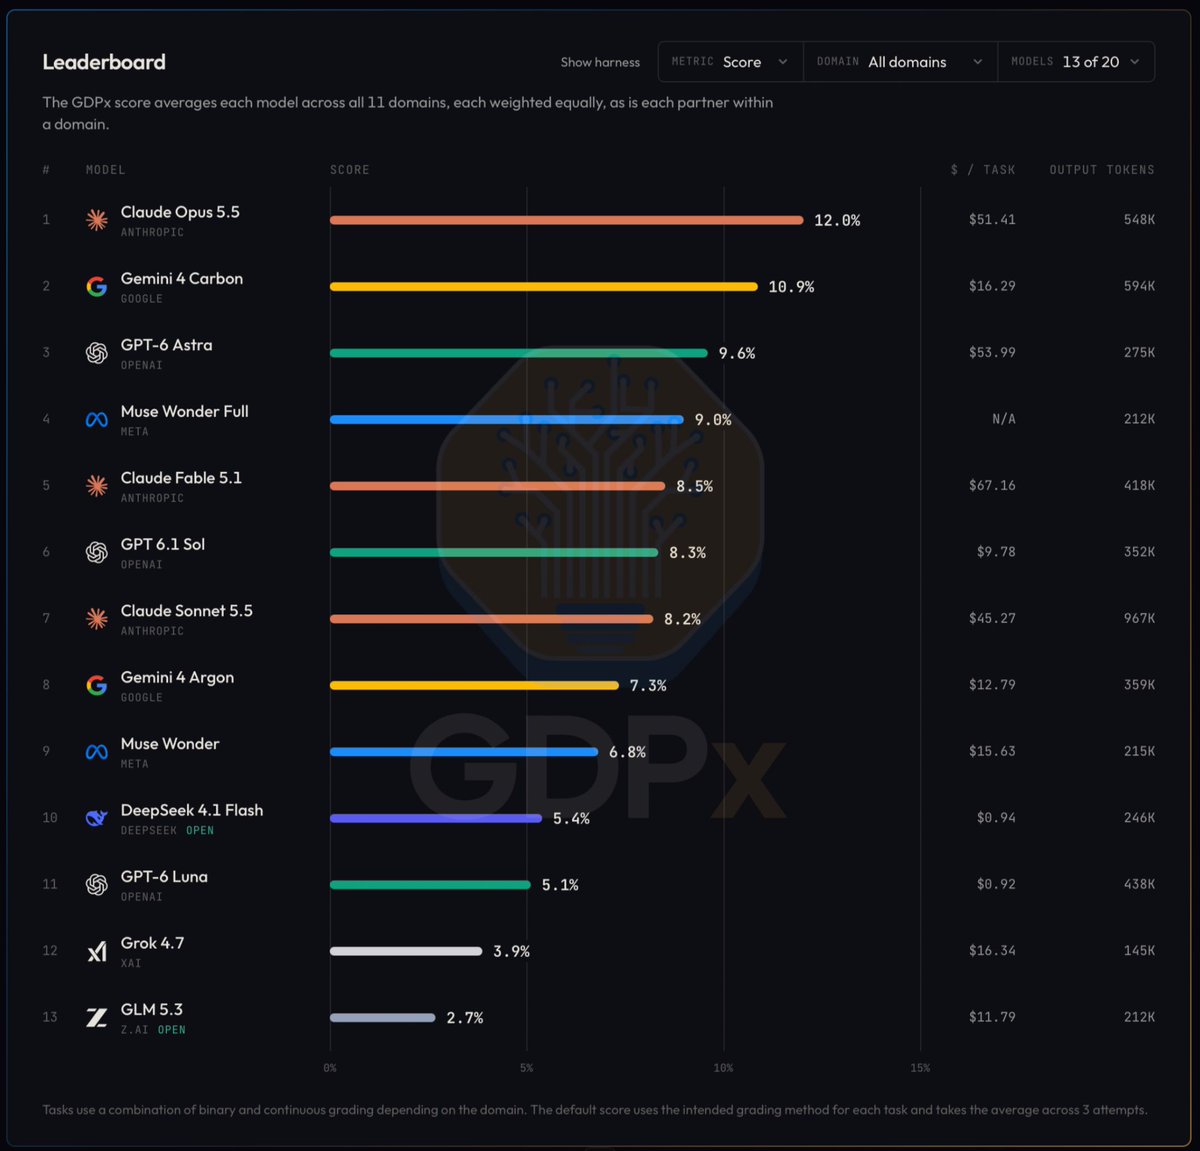
Meituan lancia LongCat-2.5, un modello multimodale da 1,6T di parametri per attività agentiche
Meituan ha lanciato LongCat-2.5, secondo un post su X dell’account leo114119 che rimanda al blog LongCat di Meituan. Il post dice che Meituan lo descrive come un modello multimodale nativo progettato per attività agentiche, con 1,6 trilioni di parametri e prestazioni elevate in progetti complessi di programmazione visiva e in attività professionali d’ufficio come design creativo, attività 3D e analisi aziendale.
MiniMax elenca le quantizzazioni della community per eseguire M3.1 Flash in locale
MiniMax ha pubblicato una raccolta di versioni quantizzate, realizzate dalla community, del suo modello open-weight M3.1 Flash da 428B parametri, pensate per chi lo esegue sul proprio hardware. MiniMax afferma che i pesi a bit inferiori riducono la memoria necessaria per caricare il modello e i dati dei pesi trasferiti durante la decodifica, e che per ottenere risultati utili servono una calibrazione accurata, kernel efficienti a bassa precisione e una distribuzione degli esperti tra GPU e RAM di sistema.
Claude Mythos 5.5 non è stato annunciato, ma il codice sorgente del sito di Anthropic lo menziona
Anthropic non ha annunciato Claude Mythos 5.5. Diversi account su X riferiscono che il codice HTML della pagina Claude Mythos di Anthropic (anthropic.com/claude/mythos) lo menziona.
Google announces Gemini 4 Carbon, its next frontier model, to cyber defenders first
Google announced Gemini 4 Carbon on October 28, 2026, calling it its strongest model, with state-of-the-art cybersecurity and long-horizon capabilities. It follows Gemini 4 Argon by two weeks. Sundar Pichai's post and Google's blog say it is not yet generally available: starting this week a subset of cyber defenders get access, with more trusted partners added through the Fairwind Program. Google says it will bring Carbon to developers, businesses and consumers "as soon as possible", and that it is taking part in the U.S. government's voluntary process for pre-release model testing.