 AI Tracker
MiniMax elenca le quantizzazioni della community per eseguire M3.1 Flash in locale
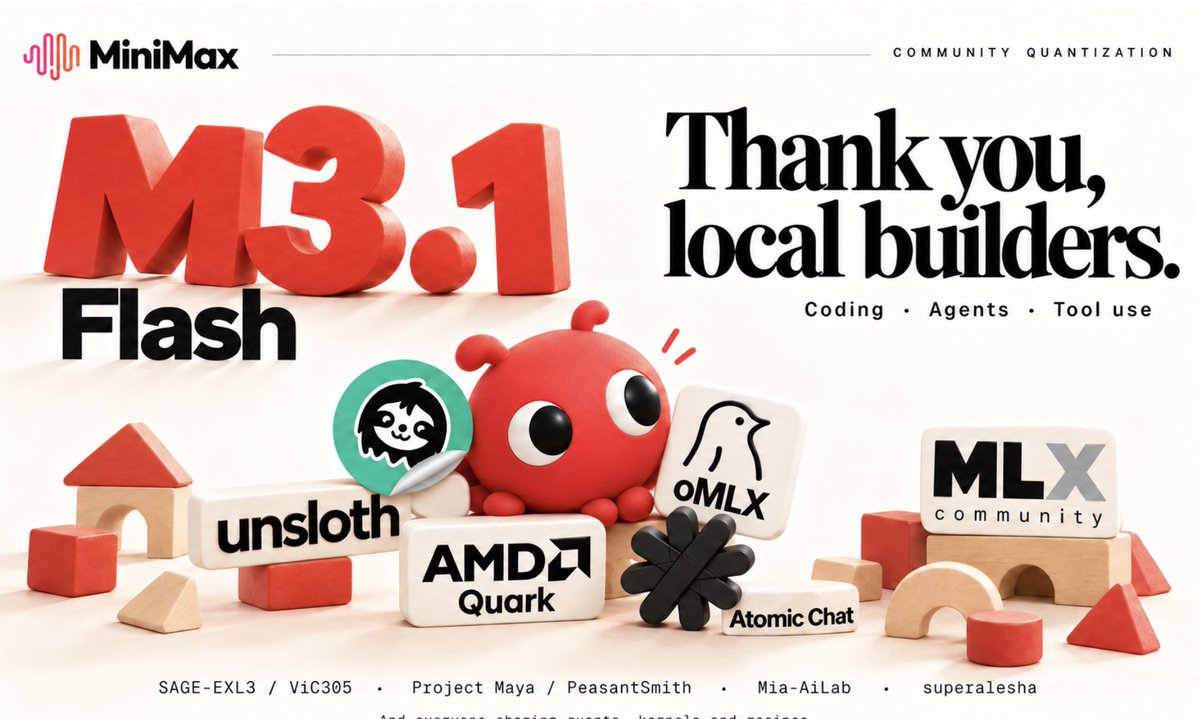
MiniMax ha pubblicato una raccolta di versioni quantizzate, realizzate dalla community, del suo modello open-weight M3.1 Flash da 428B parametri, pensate per chi lo esegue sul proprio hardware. MiniMax afferma che i pesi a bit inferiori riducono la memoria necessaria per caricare il modello e i dati dei pesi trasferiti durante la decodifica, e che per ottenere risultati utili servono una calibrazione accurata, kernel efficienti a bassa precisione e una distribuzione degli esperti tra GPU e RAM di sistema.
I realizzatori citati:
- Unsloth: pesi GGUF Dynamic a 2 bit da 143,9 GB, con calibrazione e test di fedeltà su attività di programmazione, uso di strumenti e altri carichi di lavoro.
- ViC305: quantizzazioni SAGE-EXL3, misurazioni della fedeltà a livello di token e una procedura per un singolo DGX-Spark.
- PeasantSmith: quantizzazioni Project Maya e offloading degli esperti per attività locali di programmazione e uso di strumenti.
- MiaAI_lab: lavoro di quantizzazione EXL3-EAQ.
- jundotkim e mlx-community: quantizzazioni oQ, con decodifica accelerata da DSpark tramite oMLX su Apple Silicon.
- AMD (AIatAMD): Quark MXFP4 adattato per AMD Instinct.
- atomic_chat_hq: GGUF per flussi di lavoro desktop in locale.
- superalesha: inferenza personalizzata che combina pesi quantizzati, caching degli esperti e RAM di sistema su quattro RTX 3090.
Le dichiarazioni sulla fedeltà provengono dagli stessi autori delle quantizzazioni, non da MiniMax né da test indipendenti. Al 1º novembre, il post aveva circa 400 Mi piace su X.
Fonti
- MiniMax M3.1 Flash, su più hardware.X · 36 commenti
Ricevi notizie come questa via push.
AI Tracker ti avvisa quando cambia qualcosa negli strumenti che usi.