 AI Tracker
MiniMax répertorie des quantifications communautaires pour exécuter M3.1 Flash en local
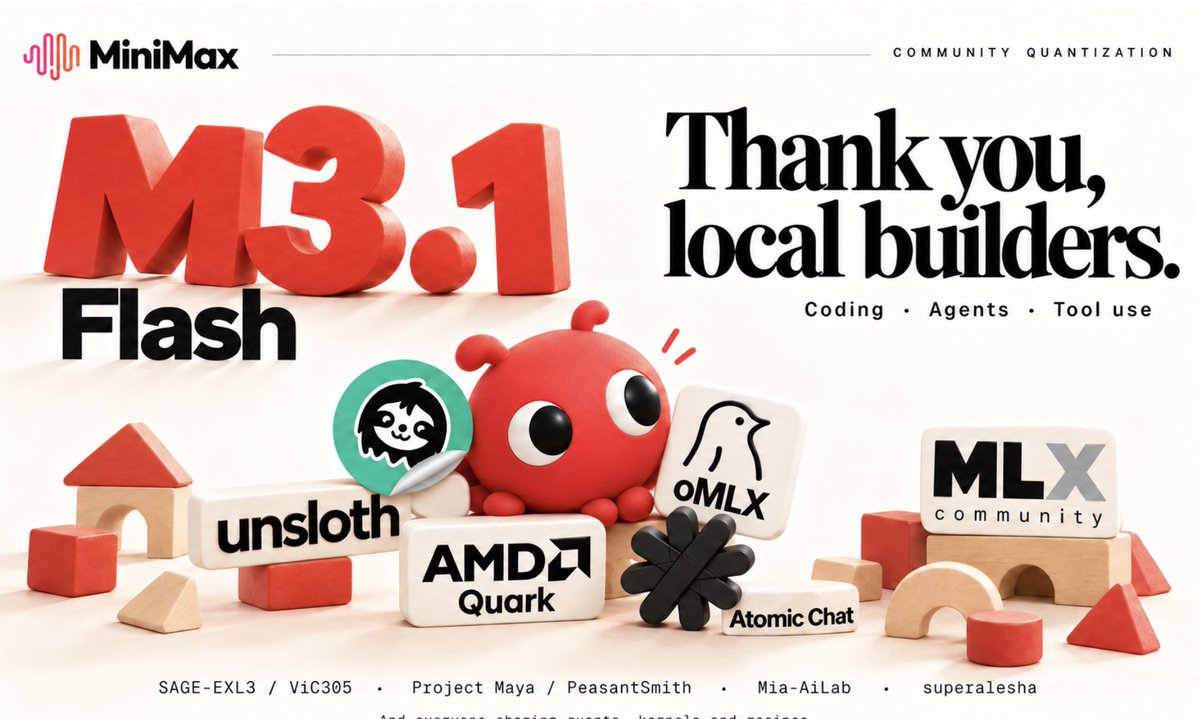
MiniMax a publié un récapitulatif des versions quantifiées de son modèle open-weight M3.1 Flash de 428 milliards de paramètres, créées par la communauté et destinées aux personnes qui l’exécutent sur leur propre matériel. MiniMax indique que les poids à plus faible nombre de bits réduisent la mémoire nécessaire au chargement du modèle ainsi que le volume de données de poids transférées pendant le décodage. Pour que cette approche soit utile, il faut toutefois un étalonnage minutieux, des noyaux efficaces à faible nombre de bits et une répartition des experts entre le GPU et la RAM système.
Les créateurs cités :
- Unsloth : poids GGUF Dynamic 2 bits de 143,9 Go, avec étalonnage et tests de fidélité sur des tâches de programmation, d’utilisation d’outils et d’autres charges de travail.
- ViC305 : quantifications SAGE-EXL3, mesures de fidélité au niveau des jetons et recette pour un seul DGX-Spark.
- PeasantSmith : quantifications Project Maya et déchargement d’experts pour la programmation et l’utilisation d’outils en local.
- MiaAI_lab : travaux de quantification EXL3-EAQ.
- jundotkim et mlx-community : quantifications oQ, avec un décodage optimisé par DSpark via oMLX sur Apple Silicon.
- AMD (AIatAMD) : Quark MXFP4 adapté à AMD Instinct.
- atomic_chat_hq : fichiers GGUF pour les flux de travail sur ordinateur de bureau en local.
- superalesha : inférence personnalisée combinant poids quantifiés, mise en cache des experts et RAM système sur quatre RTX 3090.
Les affirmations sur la fidélité viennent des équipes ayant réalisé les quantifications, et non de MiniMax ni d’un test indépendant. Au 1er novembre, la publication avait reçu environ 400 mentions J’aime sur X.
Sources
- MiniMax M3.1 Flash, sur davantage de votre matériel.X · 36 commentaires
Recevez ce genre d'actus en notification.
AI Tracker vous prévient dès que quelque chose change pour les outils que vous utilisez.