 AI Tracker
MiniMax перечислила созданные сообществом квантованные версии для локального запуска M3.1 Flash
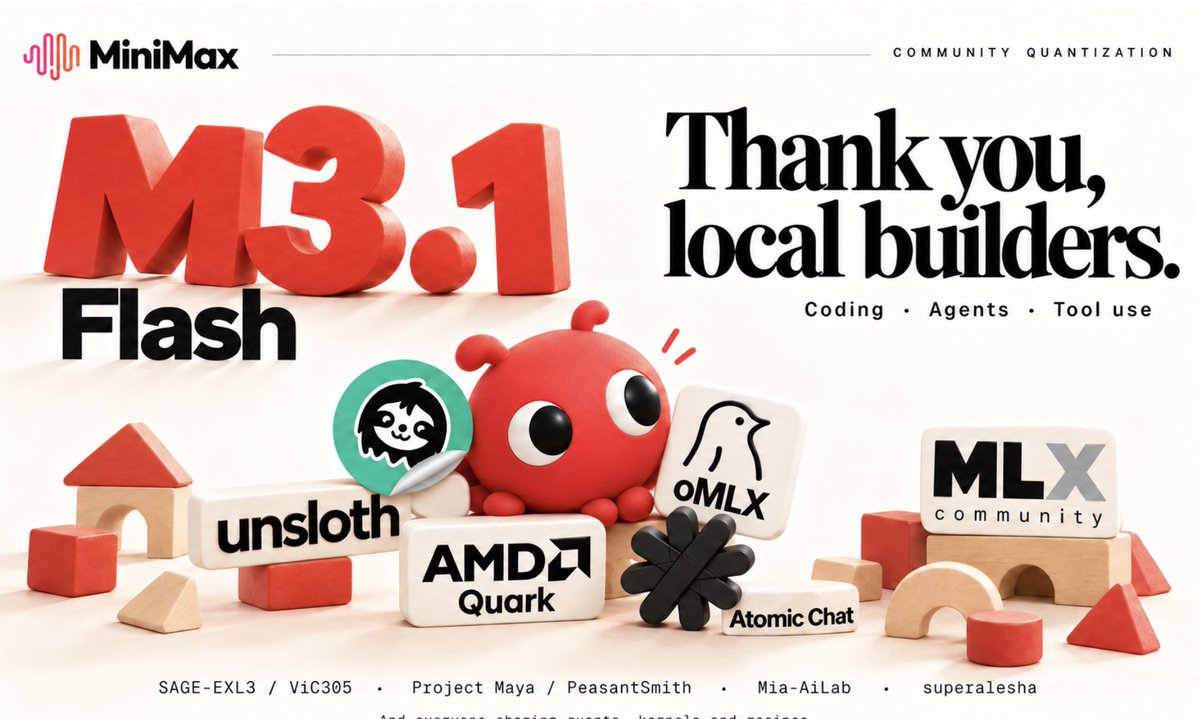
MiniMax опубликовала обзор квантованных версий своей модели с открытыми весами M3.1 Flash на 428 млрд параметров, созданных сообществом для запуска на собственном оборудовании. По словам MiniMax, веса с меньшей разрядностью сокращают объём памяти, необходимый для загрузки модели, и объём данных весов, перемещаемых при декодировании. Чтобы это работало эффективно, нужны тщательная калибровка, производительные низкоразрядные ядра и распределение экспертов между GPU и системной оперативной памятью.
Вот кого компания отметила:
- Unsloth: динамические веса GGUF с разрядностью 2 бита объёмом 143,9 ГБ; проведены калибровка и тестирование точности на задачах программирования, использовании инструментов и других сценариях.
- ViC305: квантизация SAGE-EXL3, измерения точности на уровне токенов и инструкция по запуску на одной DGX-Spark.
- PeasantSmith: квантизация Project Maya и выгрузка экспертов для локального программирования и использования инструментов.
- MiaAI_lab: работа над квантизацией EXL3-EAQ.
- jundotkim и mlx-community: квантизация oQ и декодирование с поддержкой DSpark через oMLX на Apple Silicon.
- AMD (AIatAMD): адаптация Quark MXFP4 для AMD Instinct.
- atomic_chat_hq: модели GGUF для локальных задач на настольных компьютерах.
- superalesha: собственная система инференса, объединяющая квантованные веса, кэширование экспертов и системную оперативную память на четырёх RTX 3090.
Заявления о точности исходят от самих авторов методов квантизации, а не от MiniMax или независимых тестировщиков. К 1 ноября публикация набрала в X около 400 отметок «Нравится».
Источники
- MiniMax M3.1 Flash — теперь на большем числе ваших устройств.X · 36 комментариев
Получайте такие новости в push.
AI Tracker сообщит, когда что-то меняется в ваших инструментах.