 AI Tracker
MiniMax listet Community-Quantisierungen für den lokalen Betrieb von M3.1 Flash auf
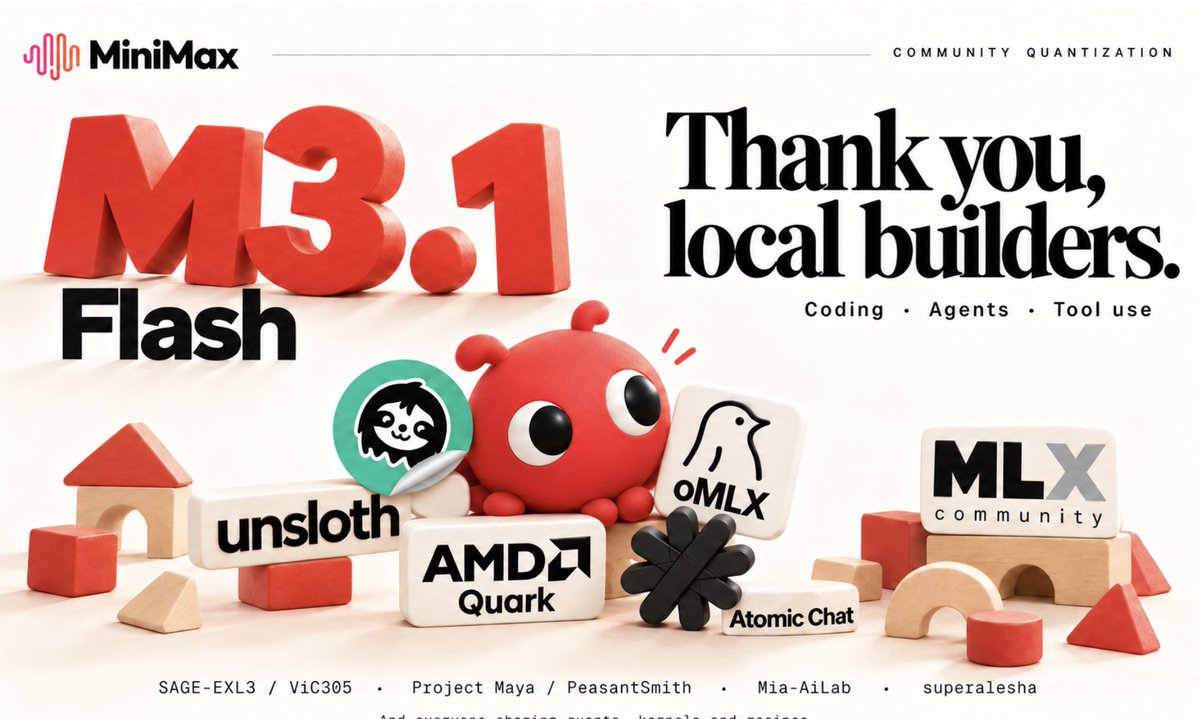
MiniMax veröffentlichte eine Übersicht von quantisierten Versionen seines Open-Weight-Modells M3.1 Flash mit 428 Milliarden Parametern, die von der Community erstellt wurden und sich an Nutzer richten, die das Modell auf eigener Hardware ausführen. Laut MiniMax verringern Gewichte mit niedrigerer Bitbreite den zum Laden des Modells benötigten Speicher sowie die beim Decoding übertragenen Gewichtsdaten. Damit das in der Praxis funktioniert, brauche es sorgfältige Kalibrierung, effiziente Low-Bit-Kernels und eine Verteilung der Experten auf GPU und Systemspeicher.
Die Entwickler, denen MiniMax Anerkennung zollt:
- Unsloth: 2-Bit-Dynamic-GGUF-Gewichte mit 143,9 GB sowie Kalibrierung und Fidelity-Tests für Coding, Tool-Nutzung und weitere Aufgaben.
- ViC305: SAGE-EXL3-Quants, Messungen der Token-Fidelity und eine Anleitung für den Betrieb auf einem einzelnen DGX Spark.
- PeasantSmith: Project-Maya-Quants und Expert-Offloading für lokales Coding und die Nutzung von Tools.
- MiaAI_lab: Quantisierungsarbeiten mit EXL3-EAQ.
- jundotkim und mlx-community: oQ-Quants mit DSpark-gestütztem Decoding über oMLX auf Apple Silicon.
- AMD (AIatAMD): für AMD Instinct angepasste Quark-MXFP4-Quantisierung.
- atomic_chat_hq: GGUFs für lokale Desktop-Workflows.
- superalesha: eigene Inferenzlösung, die quantisierte Gewichte, Expert-Caching und Systemspeicher auf vier RTX 3090 kombiniert.
Die Fidelity-Angaben stammen von den Quantisierungsentwicklern selbst, nicht von MiniMax oder einem unabhängigen Test. Der Beitrag hatte bis zum 1. November etwa 400 Likes auf X.
Quellen
- MiniMax M3.1 Flash auf mehr deiner Hardware.X · 36 Kommentare
News wie diese als Push.
AI Tracker benachrichtigt dich, wenn sich bei deinen Tools etwas ändert.