 AI Tracker
MiniMax mencantumkan kuantisasi komunitas untuk menjalankan M3.1 Flash secara lokal
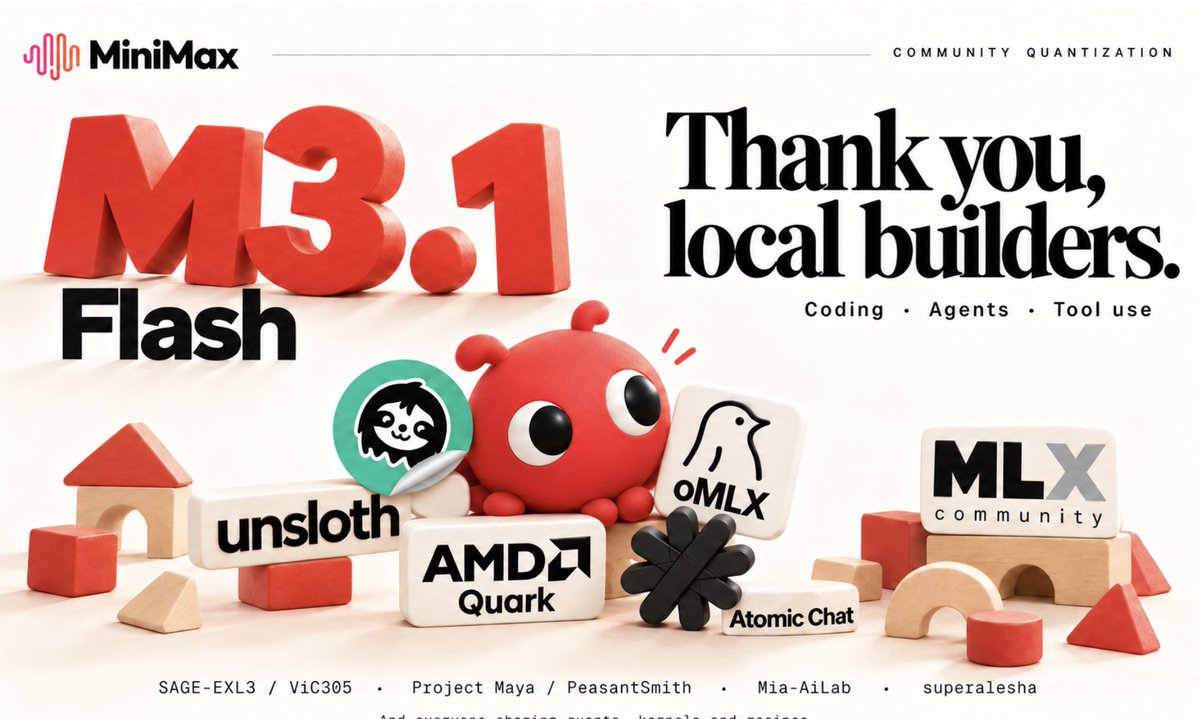
MiniMax mengunggah rangkuman versi terkuantisasi buatan komunitas dari M3.1 Flash berbobot terbuka dengan 428B parameter, yang ditujukan bagi mereka yang menjalankannya di perangkat keras sendiri. MiniMax menyatakan bahwa bobot bit-rendah mengurangi memori yang dibutuhkan untuk memuat model dan data bobot yang dipindahkan selama proses decoding. Agar hasilnya berguna, diperlukan kalibrasi cermat, kernel bit-rendah yang efisien, serta penempatan expert di antara GPU dan RAM sistem.
Para pembuat yang disebutkan:
- Unsloth: Bobot GGUF Dynamic 2-bit berukuran 143.9 GB, dengan kalibrasi dan pengujian fidelitas untuk pemrograman, penggunaan alat, dan beban kerja lainnya.
- ViC305: Kuantisasi SAGE-EXL3, pengukuran fidelitas tingkat token, dan resep untuk satu DGX-Spark.
- PeasantSmith: Kuantisasi Project Maya dan pemindahan expert untuk pemrograman lokal dan penggunaan alat.
- MiaAI_lab: Pengerjaan kuantisasi EXL3-EAQ.
- jundotkim dan mlx-community: Kuantisasi oQ, dengan decoding yang ditenagai DSpark melalui oMLX di Apple Silicon.
- AMD (AIatAMD): Quark MXFP4 yang diadaptasi untuk AMD Instinct.
- atomic_chat_hq: GGUF untuk alur kerja desktop lokal.
- superalesha: Inferensi khusus yang memadukan bobot terkuantisasi, caching expert, dan RAM sistem pada empat RTX 3090.
Klaim fidelitas berasal dari pihak yang melakukan kuantisasi, bukan dari MiniMax atau pengujian independen. Hingga 1 November, unggahan tersebut memperoleh sekitar 400 suka di X.
Sumber
Dapatkan berita seperti ini lewat push.
AI Tracker memberi tahu Anda saat ada perubahan pada alat yang Anda pakai.