 AI Tracker
MiniMax reúne cuantizaciones comunitarias para ejecutar M3.1 Flash localmente
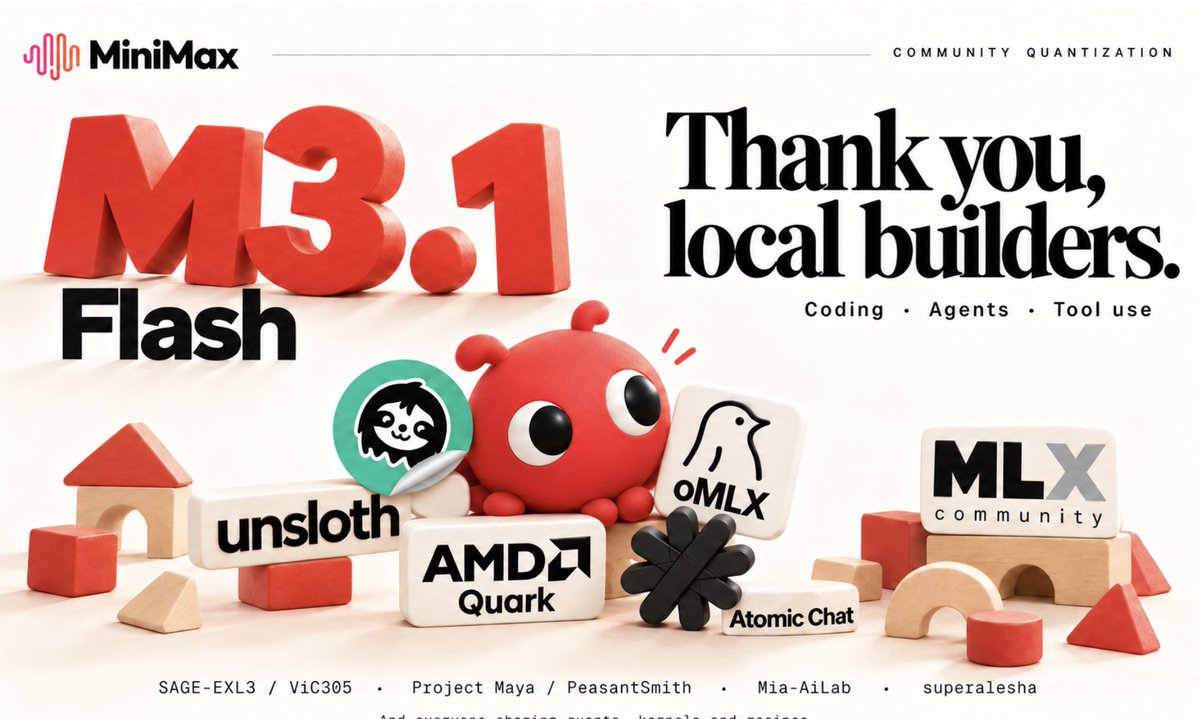
MiniMax publicó un resumen de versiones cuantizadas de código abierto, creadas por la comunidad, de su modelo M3.1 Flash de 428B parámetros, dirigidas a quienes lo ejecutan en su propio hardware. MiniMax afirma que los pesos de menos bits reducen la memoria necesaria para cargar el modelo y los datos de pesos transferidos durante la decodificación, y que para que esto resulte útil hacen falta una calibración cuidadosa, kernels eficientes de baja precisión y distribuir los expertos entre la GPU y la RAM del sistema.
Los creadores a los que da crédito:
- Unsloth: pesos GGUF Dynamic de 2 bits, de 143,9 GB, con calibración y pruebas de fidelidad en tareas de programación, uso de herramientas y otras cargas de trabajo.
- ViC305: cuantizaciones SAGE-EXL3, mediciones de fidelidad por token y una receta para un único DGX-Spark.
- PeasantSmith: cuantizaciones Project Maya y descarga de expertos para programación local y uso de herramientas.
- MiaAI_lab: trabajo de cuantización EXL3-EAQ.
- jundotkim y mlx-community: cuantizaciones oQ, con decodificación impulsada por DSpark mediante oMLX en Apple Silicon.
- AMD (AIatAMD): Quark MXFP4 adaptado para AMD Instinct.
- atomic_chat_hq: archivos GGUF para flujos de trabajo en equipos de escritorio locales.
- superalesha: inferencia personalizada que combina pesos cuantizados, almacenamiento en caché de expertos y RAM del sistema en cuatro RTX 3090.
Las afirmaciones sobre fidelidad provienen de quienes crearon las cuantizaciones, no de MiniMax ni de una prueba independiente. La publicación tenía alrededor de 400 «me gusta» en X al 1 de noviembre.
Fuentes
- MiniMax M3.1 Flash, en más de tu hardware.X · 36 comentarios
Recibe noticias como esta por push.
AI Tracker te avisa cuando algo cambia en las herramientas que usas.