 AI Tracker
MiniMax lista quantizações da comunidade para executar o M3.1 Flash localmente
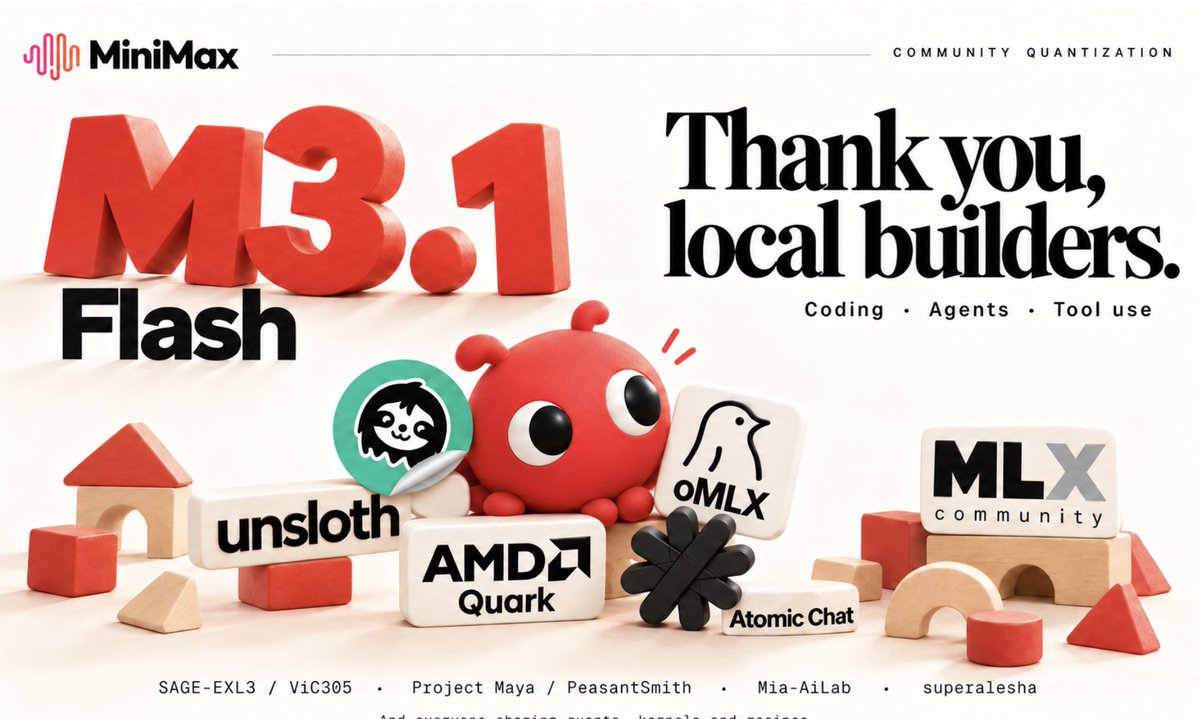
A MiniMax publicou uma seleção de versões quantizadas do M3.1 Flash, modelo de pesos abertos com 428B de parâmetros, criadas pela comunidade para quem quer executá-lo no próprio hardware. Segundo a MiniMax, pesos com menos bits reduzem a memória necessária para carregar o modelo e os dados de pesos transferidos durante a decodificação. Para que isso seja útil, são necessários calibração cuidadosa, kernels eficientes de baixa precisão e distribuição dos especialistas entre a GPU e a RAM do sistema.
Os desenvolvedores mencionados:
- Unsloth: pesos GGUF Dynamic de 2 bits, com 143,9 GB, além de calibração e testes de fidelidade em tarefas de programação, uso de ferramentas e outras cargas de trabalho.
- ViC305: quantizações SAGE-EXL3, medições de fidelidade por token e uma receita para um único DGX-Spark.
- PeasantSmith: quantizações do Project Maya e transferência de especialistas para programação local e uso de ferramentas.
- MiaAI_lab: trabalho de quantização EXL3-EAQ.
- jundotkim e mlx-community: quantizações oQ, com decodificação acelerada por DSpark via oMLX no Apple Silicon.
- AMD (AIatAMD): Quark MXFP4 adaptado para AMD Instinct.
- atomic_chat_hq: arquivos GGUF para fluxos de trabalho em computadores desktop.
- superalesha: inferência personalizada que combina pesos quantizados, cache de especialistas e RAM do sistema em quatro RTX 3090s.
As alegações de fidelidade vêm dos próprios responsáveis pelas quantizações, não da MiniMax nem de testes independentes. Até 1º de novembro, a publicação tinha cerca de 400 curtidas no X.
Fontes
- MiniMax M3.1 Flash em mais do seu hardware.X · 36 comentários
Receba notícias como esta por push.
O AI Tracker avisa você quando algo muda nas ferramentas que você usa.