 AI Tracker
MiniMax ने M3.1 Flash को स्थानीय रूप से चलाने के लिए समुदाय द्वारा बनाए गए क्वांटाइज़्ड संस्करणों की सूची जारी की
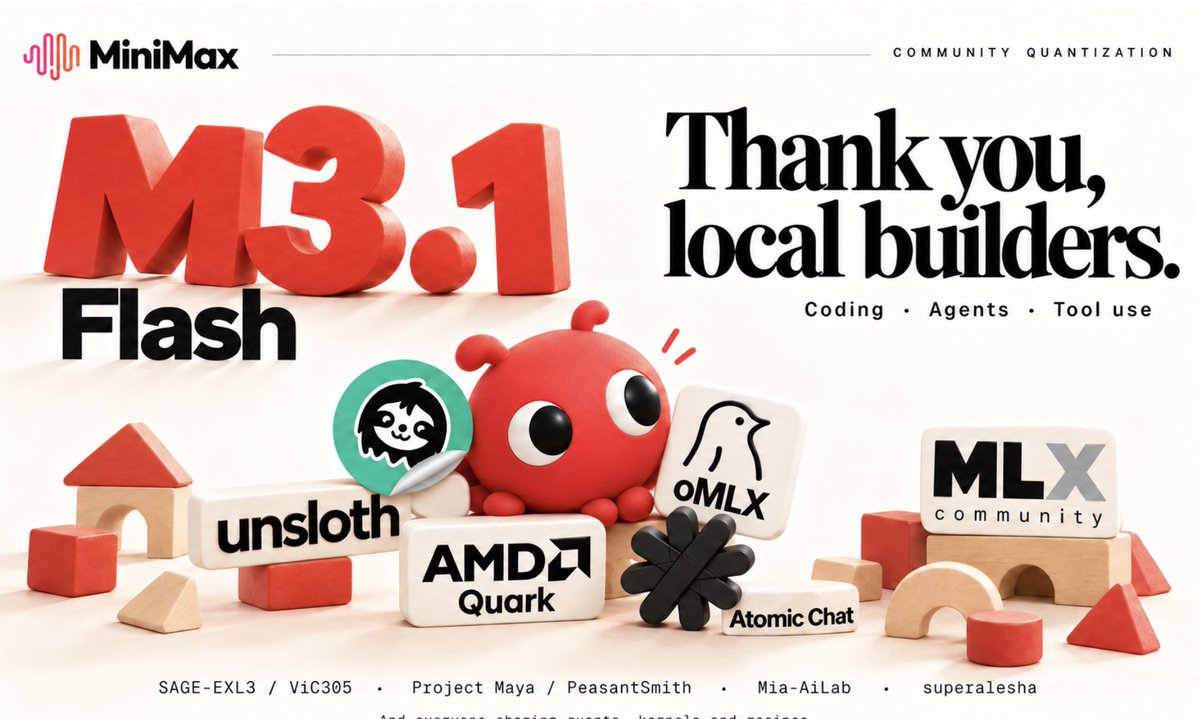
MiniMax ने अपने 428B-पैरामीटर वाले open-weight M3.1 Flash के समुदाय द्वारा बनाए गए क्वांटाइज़्ड संस्करणों का संकलन पोस्ट किया। ये उन लोगों के लिए हैं जो इसे अपने हार्डवेयर पर चलाना चाहते हैं। MiniMax के अनुसार, कम-बिट वाले वेट मॉडल को लोड करने के लिए ज़रूरी मेमोरी और डिकोडिंग के दौरान स्थानांतरित किए जाने वाले वेट डेटा को कम करते हैं। इसे उपयोगी बनाने के लिए सावधानीपूर्वक कैलिब्रेशन, कुशल low-bit kernels और GPU तथा सिस्टम RAM के बीच experts को रखने की ज़रूरत होती है।
जिन निर्माताओं को श्रेय दिया गया है:
- Unsloth: 143.9 GB वाले 2-bit Dynamic GGUF weights, जिनमें कोडिंग, टूल उपयोग और अन्य वर्कलोड पर कैलिब्रेशन तथा fidelity परीक्षण शामिल हैं।
- ViC305: SAGE-EXL3 quants, token-स्तर के fidelity माप और single-DGX-Spark सेटअप की विधि।
- PeasantSmith: स्थानीय कोडिंग और टूल उपयोग के लिए Project Maya quants और expert offloading।
- MiaAI_lab: EXL3-EAQ quantization पर काम।
- jundotkim और mlx-community: oQ quants, जिनमें Apple Silicon पर oMLX के ज़रिए DSpark-संचालित डिकोडिंग शामिल है।
- AMD (AIatAMD): AMD Instinct के लिए अनुकूलित Quark MXFP4।
- atomic_chat_hq: स्थानीय डेस्कटॉप वर्कफ़्लो के लिए GGUFs।
- superalesha: चार RTX 3090s पर quantized weights, expert caching और सिस्टम RAM को मिलाकर बनाया गया कस्टम inference।
Fidelity के ये दावे quantizers की ओर से हैं, MiniMax या किसी स्वतंत्र परीक्षण की ओर से नहीं। 1 नवंबर तक X पर इस पोस्ट को लगभग 400 likes मिले थे।
स्रोत
- MiniMax M3.1 Flash, अब आपके और भी ज़्यादा हार्डवेयर पर।X · 36 टिप्पणियाँ
ऐसी ख़बरें push में पाएँ।
आपके टूल्स में कुछ बदलते ही AI Tracker आपको अलर्ट करता है।