 AI Tracker
MiniMax wymienia społecznościowe kwantyzacje do lokalnego uruchamiania M3.1 Flash
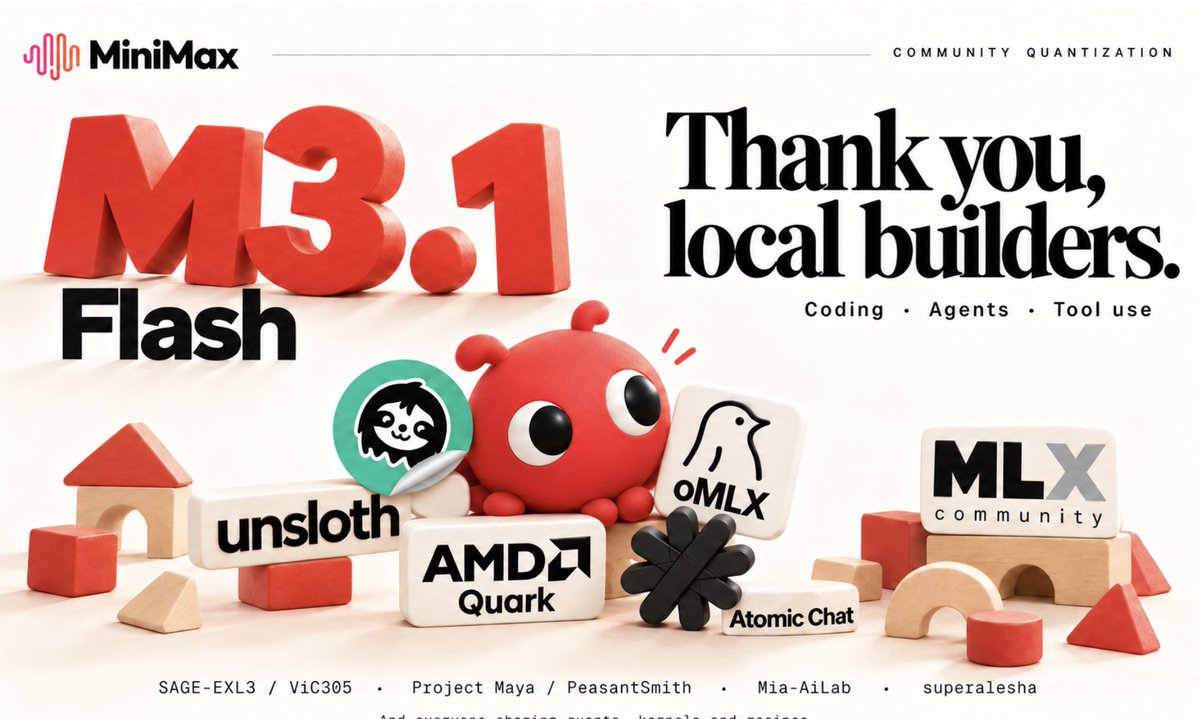
MiniMax opublikował zestawienie kwantyzowanych wersji swojego modelu M3.1 Flash z otwartymi wagami i 428 mld parametrów, przygotowanych przez społeczność z myślą o osobach uruchamiających go na własnym sprzęcie. Firma twierdzi, że wagi o niższej precyzji zmniejszają ilość pamięci potrzebnej do załadowania modelu oraz ilość danych wag przenoszonych podczas dekodowania. Dodaje, że uzyskanie praktycznego rozwiązania wymaga starannej kalibracji, wydajnych niskoprecyzyjnych kerneli oraz odpowiedniego rozmieszczenia ekspertów między GPU a pamięcią RAM systemu.
Wyróżnieni twórcy:
- Unsloth: wagi 2-bitowe Dynamic GGUF o rozmiarze 143,9 GB, z kalibracją i testami wierności w zadaniach programistycznych, obsłudze narzędzi i innych zastosowaniach.
- ViC305: kwantyzacje SAGE-EXL3, pomiary wierności na poziomie tokenów oraz instrukcja konfiguracji dla pojedynczego DGX-Spark.
- PeasantSmith: kwantyzacje Project Maya i odciążanie ekspertów na potrzeby lokalnego programowania i korzystania z narzędzi.
- MiaAI_lab: prace nad kwantyzacją EXL3-EAQ.
- jundotkim i mlx-community: kwantyzacje oQ oraz dekodowanie wspomagane przez DSpark za pośrednictwem oMLX na Apple Silicon.
- AMD (AIatAMD): Quark MXFP4 dostosowany do AMD Instinct.
- atomic_chat_hq: pliki GGUF do lokalnej pracy na komputerach stacjonarnych.
- superalesha: niestandardowe wnioskowanie łączące skwantyzowane wagi, buforowanie ekspertów i pamięć RAM systemu na czterech kartach RTX 3090.
Deklaracje dotyczące wierności pochodzą od twórców kwantyzacji, a nie od MiniMax ani z niezależnych testów. Do 1 listopada wpis miał około 400 polubień na X.
Źródła
- MiniMax M3.1 Flash — na jeszcze większej liczbie Twoich urządzeń.X · 36 komentarzy
Otrzymuj takie wiadomości jako push.
AI Tracker powiadomi Cię, gdy coś zmieni się w narzędziach, których używasz.