AI Tracker
マルチモーダルのニュースを、
開発者向けに。
各 AI プロバイダーのマルチモーダルに関する最新ニュース。リリース、価格改定、提供終了を、あなたへの影響とともに要約します。
Liquid AI、テキスト・ビジョン・音声・オムニ対応の小型モデル6種「LFM3」を発表
Liquid AIは、新しいトライハイブリッド・アーキテクチャとマルチモーダル・エンコーダーを採用した、Liquid Foundation Modelsの新世代「LFM3」を発表しました。同社によると、このアーキテクチャはGPU、CPU、NPUにまたがる14のプロセッサクラス向けに最適化されており、モデルはGPU1基でファインチューニングできます。Google DeepMind、リアルタイムで操作できる世界モデル「Genie 4」を発表
Google DeepMindは2026年10月27日、これまでで最もリアルでインタラクティブな世界モデルとする「Genie 4」を発表しました。DeepMindは投稿で、ユーザーは動的な環境をリアルタイムで探索でき、シーンがどう反応し、どんな音が鳴り、登場する人々がどう動き、反応し、話すかを確認できると述べています。また、「Genie 4: a new generation of world simulation」と題したブログ記事を公開しました。MicrosoftのMAI-Image-2.7-Preview、Artificial Analysisの画像編集ランキングで2位
Artificial Analysisによると、Microsoft AIの最新画像編集モデルで、8月にリリースされたMAI-Image-2.6の後継にあたるMAI-Image-2.7-Previewは、同社のAA-Image-Editing v2.1ランキングで2位となり、OpenAIのGPT Image 2.5 Sunburst (max)に僅差で続いています。この結果はArtificial Analysis独自のものです。SenseTime reportedly open-sources SenseNova 6.8 Code2Video, a 27B code-to-video model
A Chinese AI blogger reports that SenseTime open-sourced SenseNova 6.8 Code2Video on October 27, with weights on Hugging Face under sensenova/SenseNova-6.8-Code2Video. The report is second-hand; SenseTime's own announcement is not cited.インドの言語に対応した音声モデルMaya-2、オープンウェイトで公開
インド向けの音声(音声合成)モデルMaya-2が、10月27日にHugging Face上でmaya-research/maya2-nativeという名称でオープンウェイト公開された。Xでの発表によると、28州と8つの連邦直轄領に暮らす15億人以上を対象としている。
Baidu、デコードコストがほぼ一定の文書パーサー「Unlimited OCR 2」をオープンソース化
Baiduは10月26日、XでUnlimited OCR 2を発表し、コードをGitHubで、重みをHugging Faceで公開しました。このモデルは、有限のコンテキストウィンドウ内で、事実上どんな長さの文書でも解析できるように設計されています。Artificial Analysis、コードで作るマーケティング動画のベンチマーク「Code2Video-AA」を公開
Artificial Analysisは、HeyGenとの共同開発による、HeyGenのCode2Video Benchの独自実装「Code2Video-AA」を公開しました。モデルには114件の商品・ブランドマーケティングのブリーフが提示され、それぞれに対し、ツールを使わず単一の応答でHyperFramesのHTMLコンポジションを作成する必要があります。コンポジションはネットワークアクセスなしで動画にレンダリングされます。評価モデル(Gemini 4 Argon、high)が、エンゲージメント、プロンプトの意図、構図、時間的な一貫性、完成度の5項目で動画をペア比較し、5項目のEloレーティングを平均して総合スコアを算出します。3万5,000件を超える判定に基づき、27モデルを順位付けしています。結果はArtificial Analysis独自のものです。微調整した2015年製CNN、皮膚病変の診断でGPT-6 AstraとClaude Fable 5.1を上回ると皮膚科医が報告
Guy's HospitalとKing's College Londonの顧問皮膚科医Dr Magnus Lynchが、公開データセットMILK10kから無作為に選んだ生検で確定診断された病変200例を使い、GPT-6 AstraとClaude Fable 5.1を検証した。各モデルに臨床写真とダーモスコピー画像を提示し、同じプロンプトとデフォルト設定を使って、6つの診断から選ばせた。比較対象はInception v3(2015年公開)をISIC Archiveの画像68,011枚でH100 GPU 1基を使ってファインチューニングしたモデルで、テスト対象の病変は学習データから除外されている。Moonshot、Kimi K3.1 Proを発表。オープンウェイトは11月4日までに公開予定
MoonshotはKimi K3.1 Proを発表し、3Tクラスで最も高性能なオープンウェイトモデルと称しています。これは、総パラメータ数2.8T、アクティブパラメータ数104B、コンテキスト長1Mトークンのマルチモーダルなmixture-of-expertsモデルです。Moonshotによると、K3.1 ProとK3.1 Pro Highspeed(2~3倍高速)は、Kimi.ai、Kimi Work、Kimi Code、Kimi APIで利用可能です(モデルIDはkimi-k3.1-proとkimi-k3.1-pro-highspeed)。オープンウェイトは2026年11月4日までに公開予定です。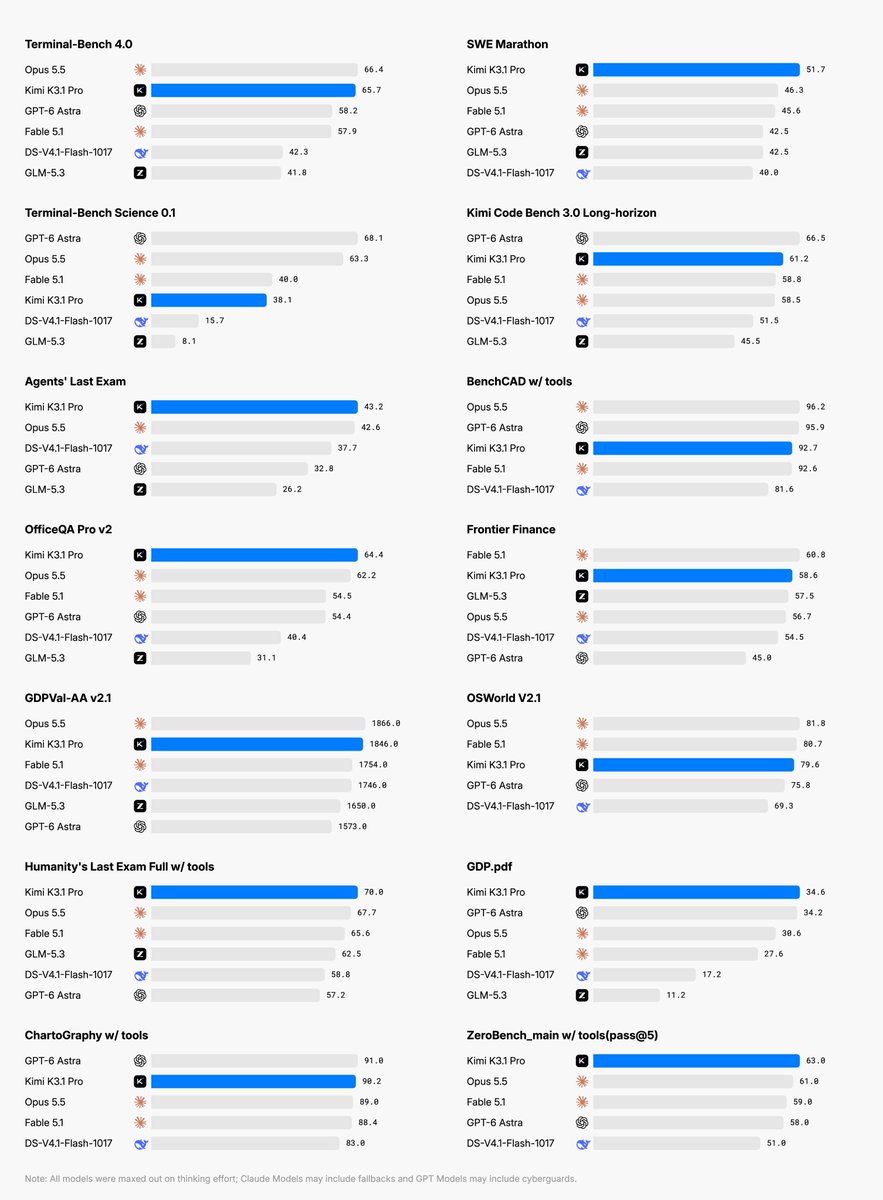
Block、全二重音声対話モデル「Dessa」のプレビューを公開
SquareとCash Appを手がけるBlockは、研究プレビュー版のDessaを公開しました。同社はこれを「これまでに作られた中で最も自然な全二重音声モデル」と称しています。Jack Dorseyの発表によると、感情やニュアンス、間、自然なリズムを備え、人と話しているような感覚で会話できます。Google releases Gemini 4 Argon, its latest frontier model
Google released Gemini 4 Argon on October 13, 2026, and says it is available globally. Google's blog post was shared on Hacker News on October 20. The Gemini API changelog lists gemini-4-argon as generally available from October 13, describing it as Google's most capable model, built for complex coding, agentic, math and science tasks.Grok Bot 0.75.2、デスクトップチャットにカードを追加し、動画生成にも対応
x.aiのリリース変更履歴へのリンクを添えた、Grok BotチームメンバーのXへの投稿によると、Grok Bot 0.75.2がリリースされました。投稿には次の3つの変更点が記載されています。Ideogram introduces its first vector model
Ideogram announced its first vector model on X. According to Ideogram, it generates clean, editable SVGs with smooth gradients and sharp typography from a text prompt, or turns any image into a detailed, scalable vector.
Mistral releases Voxtral 3, speech models and a voice agent SDK
Mistral announced Voxtral 3 on October 20, 2026 (shared on Hacker News, where it had 735 points and 182 comments by October 20). Details and benchmarks below are Mistral's own claims from its announcement page.
ElevenLabs opens a limited alpha of Eleven Realtime Translation
ElevenLabs announced on X on October 21, 2026 a limited alpha of Eleven Realtime Translation, which builds live voice translation into calls. It followed the launch earlier that week of Eleven Realtime, its product for voice agents that talk to people.