 AI Tracker
멀티모달 뉴스,
개발자를 위해.
모든 AI 제공업체의 최신 멀티모달 뉴스: 출시, 가격 변경, 지원 종료를 나에게 미치는 영향과 함께 요약했습니다.
Hume, 한 번의 호출로 오디오 관련 질문에 답하는 Audio Decision API 출시
Hume은 Audio Decision API를 통해 개발자가 오디오 속 화자 수, 누군가 웃고 있는지, 통화 상대가 불만스러워하는지 등을 물을 수 있다고 밝혔습니다. Hume은 이 API가 과거 10개 이상의 모델이 필요했던 작업을 대체한다고 설명합니다.Meituan, 에이전트 작업용 1.6T 파라미터 멀티모달 모델 LongCat-2.5 출시
X 계정 leo114119의 게시물에 따르면 Meituan이 LongCat-2.5를 출시했습니다. 해당 게시물은 Meituan의 LongCat 블로그로 연결됩니다. 게시물에 따르면 Meituan은 이 모델을 에이전트 작업을 위해 구축한 네이티브 멀티모달 모델이라고 설명하며, 복잡한 시각적 코딩 프로젝트와 창의적 디자인, 3D 작업, 비즈니스 분석 같은 전문 사무 업무에서 강점을 보인다고 합니다. 파라미터는 1조 6천억 개입니다.
Google announces Gemini 4 Carbon, its next frontier model, to cyber defenders first
Google announced Gemini 4 Carbon on October 28, 2026, calling it its strongest model, with state-of-the-art cybersecurity and long-horizon capabilities. It follows Gemini 4 Argon by two weeks. Sundar Pichai's post and Google's blog say it is not yet generally available: starting this week a subset of cyber defenders get access, with more trusted partners added through the Fairwind Program. Google says it will bring Carbon to developers, businesses and consumers "as soon as possible", and that it is taking part in the U.S. government's voluntary process for pre-release model testing.
코딩 에이전트와 음성으로 대화하는 로컬 앱 Hex, 정식 출시
OpenCode 계정은 10월 31일 X에서 Hex의 정식 버전을 사용할 수 있다고 밝혔습니다. Hex는 빠르고 로컬에서 실행되며 Mac, Windows, Linux에서 작동하는, 어떤 에이전트와도 음성으로 대화할 수 있는 앱이라고 소개했습니다. 게시물에는 anoma.ly/hex 링크가 포함돼 있습니다.OpenCode 2.2.3, 이미지 생성 도구 추가
OpenCode 계정은 10월 30일 X에서 OpenCode 2.2.3에 OpenAI, Gemini, Grok 등의 이미지 모델을 지원하는 이미지 생성 도구가 추가됐다고 밝혔다. 비디오 게임의 콘셉트 UI나 참고용 아트를 만드는 데 활용할 수 있다고 제안했다.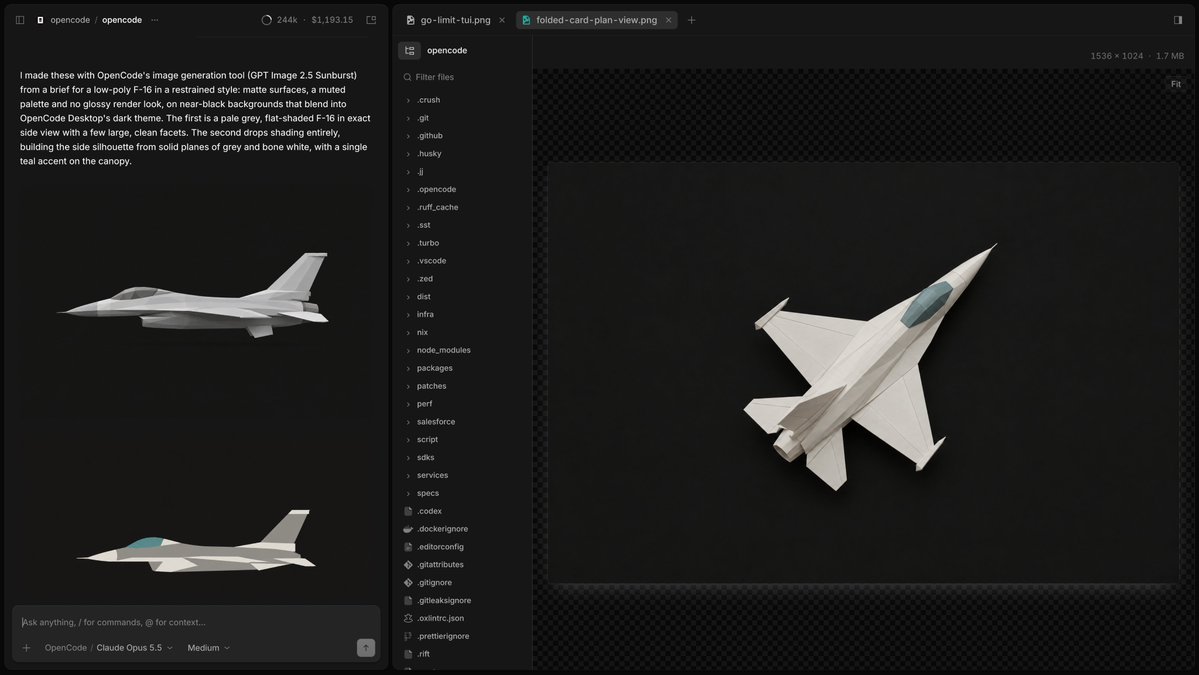
ElevenLabs, 여러 부분으로 구성된 프롬프트를 따르는 효과음 모델 SFX v3 출시
ElevenLabs가 최신 효과음 모델인 SFX v3를 출시했습니다. 회사는 이 모델이 텍스트 프롬프트 하나로 더욱 풍부하고 정밀한 효과음을 만들고, 하나의 프롬프트에 담긴 여러 지시를 더 안정적으로 따른다고 밝혔습니다(예: 군중의 환호, 공이 떨어지는 소리, 이어지는 야유). 음악과 보컬 기능도 개선됐습니다.PokeBot, 로봇 팔에 자연어로 지시하는 API RoboAPI 출시
PokeBot은 10월 29일 Robo-Aurora를 기반으로 한 RoboAPI를 공개했습니다. PokeBot은 Robo-Aurora를 자사의 월드 액션 모델이라고 부릅니다. 회사에 따르면 호환되는 로봇은 작업별 학습 없이 간단한 API를 통해 자연어 지시를 수행할 수 있습니다.Pika, DesignArena에서 최고의 오픈 웨이트 텍스트-투-비디오 모델이라고 자사가 밝힌 고속 비디오 모델 H3 Flex 출시
Pika는 H3 Flex를 공개하며, 자사 주장에 따르면 DesignArena의 텍스트-투-비디오 순위표에서 오픈 웨이트 모델 중 1위로 데뷔한다고 밝혔습니다. Pika는 이 모델이 전문적인 반복 작업을 위해 설계됐다고 설명합니다. 오디오 스템 내보내기, 최대 4K 해상도, 실시간보다 빠른 생성이 가능하며, 15초 분량의 영상과 사운드트랙을 단 7초 만에 만들 수 있습니다.Phonic 1, Artificial Analysis의 Speech to Speech Index에서 1위로 데뷔
Artificial Analysis(자체 측정치를 사용하는 벤치마크 사이트)에 따르면 Phonic의 음성 간 모델 Phonic 1 (High)이 Speech to Speech Index에서 87.1점으로 22개 모델 중 1위를 차지해 Grok Voice 3.0(86.9점)을 근소한 차이로 앞섰습니다. 이 모델은 Phonic API를 통해 분당 $0.07에 이용할 수 있습니다.Fish Audio, Artificial Analysis가 오픈 웨이트 음성 모델 중 1위로 꼽은 Drama 3 출시
Fish Audio가 Hugging Face에 가중치를 공개하며 Drama 3를 출시했습니다. 벤치마크 사이트 Artificial Analysis의 자체 측정 결과에 따르면 Drama 3는 두 음성 아레나 모두에서 오픈 웨이트 모델 중 1위이며, Pronunciation Robustness 벤치마크에서는 전체 모델 중 1위입니다.Artificial Analysis, 로봇 팔을 제어하는 모델 벤치마크 AA-Robotics v0.1 공개
Artificial Analysis가 모델이 로봇 팔을 제어하고 모델 관점에서 작업을 보여주는 AA-Robotics v0.1을 공개했습니다. 같은 로봇이 "hello world"를 쓰는 예시에서, Artificial Analysis에 따르면 Claude Opus 5.5는 점을 하나씩 찍어 글자를 썼으며 팔을 3,270번 움직이는 데 34분이 걸렸습니다. 반면 GPT-6 Astra는 연속된 획으로 써서 514번 움직이는 데 13분이 걸렸습니다.ElevenLabs introduces Cue, a forced alignment model
ElevenLabs research introduced Cue, a forced alignment model: the step that turns a transcript into timestamps, used for subtitles, dubbing and clickable transcripts. It places every character on the audio timeline.Rime, 음성 에이전트용 음성 간 모델 Prism 출시
Rime이 AI 음성 에이전트를 위한 음성 간 모델 Prism을 출시했습니다. 아래 수치는 독립적으로 측정된 결과가 아니라 Rime의 자체 주장입니다.Artificial Analysis, 이미지-투-비디오 모델 벤치마크 AA-Video-I2V v2.1 출시
Artificial Analysis는 이미지-투-비디오 모델 벤치마크인 AA-Video-I2V v2.1과 AA-Video-I2V-Silent v2.1을 출시했습니다. 각 프롬프트는 1080p 시작 이미지와 해당 이미지에 맞춰 작성된 프롬프트를 짝지으며, 사용 사례, 기능, 시각 스타일별로 태그가 지정됩니다. 모델은 최대 1080p에서 평가되며 10개 사용 사례와 10개 기능에 걸쳐 순위가 매겨집니다. 종합 순위는 각 항목을 균등하게 표본 추출합니다. 결과는 Artificial Analysis 자체 평가입니다.
OpenBMB, OCR 결과를 평가하는 2B 모델과 함께 1B 문서 파서 MiniCPM-OCR 출시
OpenBMB는 10월 28일 X에서 iPhone과 iPad에서 로컬로 실행되는 MiniCPM-OCR을 선보였습니다. 오픈 웨이트로 공개됐으며 llama.cpp, vLLM, SGLang 또는 Ollama로 실행할 수 있습니다. 파인튜닝 코드도 오픈 소스로 공개됐고, OpenBMB는 데모와 API도 제공합니다.AssemblyAI, 첫 텍스트 음성 변환 모델 AssemblyAI-TTS-1 출시
AssemblyAI가 음성 에이전트용으로 제작한 첫 텍스트 음성 변환 모델 AssemblyAI-TTS-1을 출시했습니다. AssemblyAI는 이 모델이 90ms 만에 스트리밍되고 문자 100만 개당 15달러이며, 정확도와 자연스러움, 비용을 종합했을 때 대규모로 사용할 수 있는 최고의 TTS 모델이라고 밝혔습니다. OpenRouter에 따르면 이 모델은 해당 플랫폼에서 제공되며, 미국 또는 EU에서 4,000개 이상의 음성을 지원합니다.