 AI Tracker
Artificial Analysis uruchamia ranking HLE-Diamond, dopracowanej wersji Humanity's Last Exam
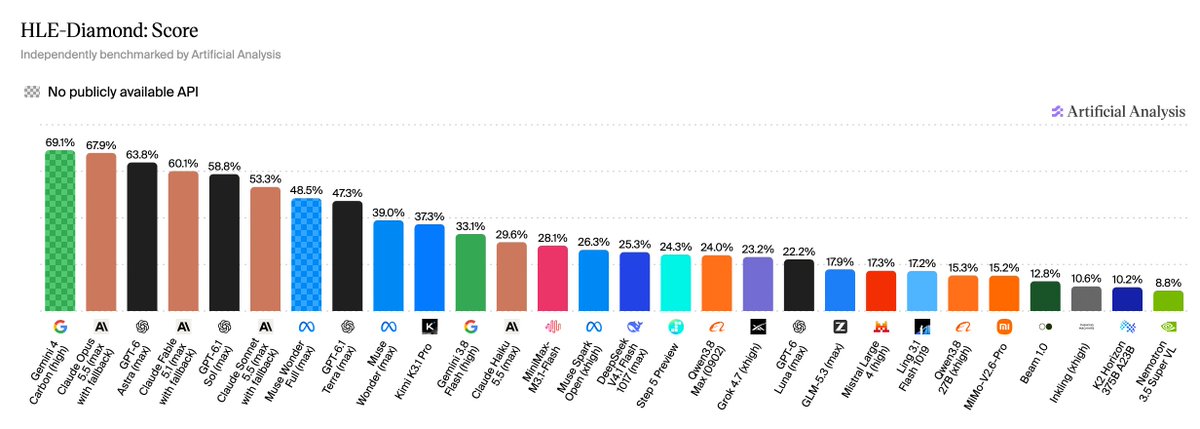
Artificial Analysis uruchomiło ranking HLE-Diamond — własną ewaluację dopracowanej wersji Humanity's Last Exam, obejmującej 1 000 pytań — w ramach 5. wersji swojego Intelligence Index. CAIS i Scale AI opublikowały HLE-Diamond po roku porządkowania i dopracowywania pytań.
Oto wyniki własnych pomiarów Artificial Analysis:
- W HLE-Diamond każde pytanie jest oznaczone jako dotyczące rozumowania lub wiedzy. Modele z wynikiem powyżej 50% uzyskują w pytaniach wymagających rozumowania wyniki wyższe o 16–35 pkt niż w pytaniach sprawdzających wiedzę. GPT-6.1 Sol (max) ma największą różnicę wśród liderów: 76% w rozumowaniu i 41% w wiedzy.
- Wyniki rosną wraz z wyższymi ustawieniami poziomu wysiłku, podobnie jak koszt. Claude Opus 5.5 zyskuje 26 pkt przy przejściu z niskiego poziomu wysiłku (42%) na maksymalny (68%), przy koszcie zadania wyższym o około 35 razy; GPT-6 Astra zyskuje 19 pkt przy przejściu z niskiego poziomu (45%) na maksymalny (64%), przy koszcie zadania wyższym 11 razy.
W rankingu podano wyniki, zużycie tokenów i koszt zadania dla każdego modelu.
Źródła
Otrzymuj takie wiadomości jako push.
AI Tracker powiadomi Cię, gdy coś zmieni się w narzędziach, których używasz.